オンラインでPDFをCSVに無料変換する方法(綺麗な表抽出)
結論と重要ポイント
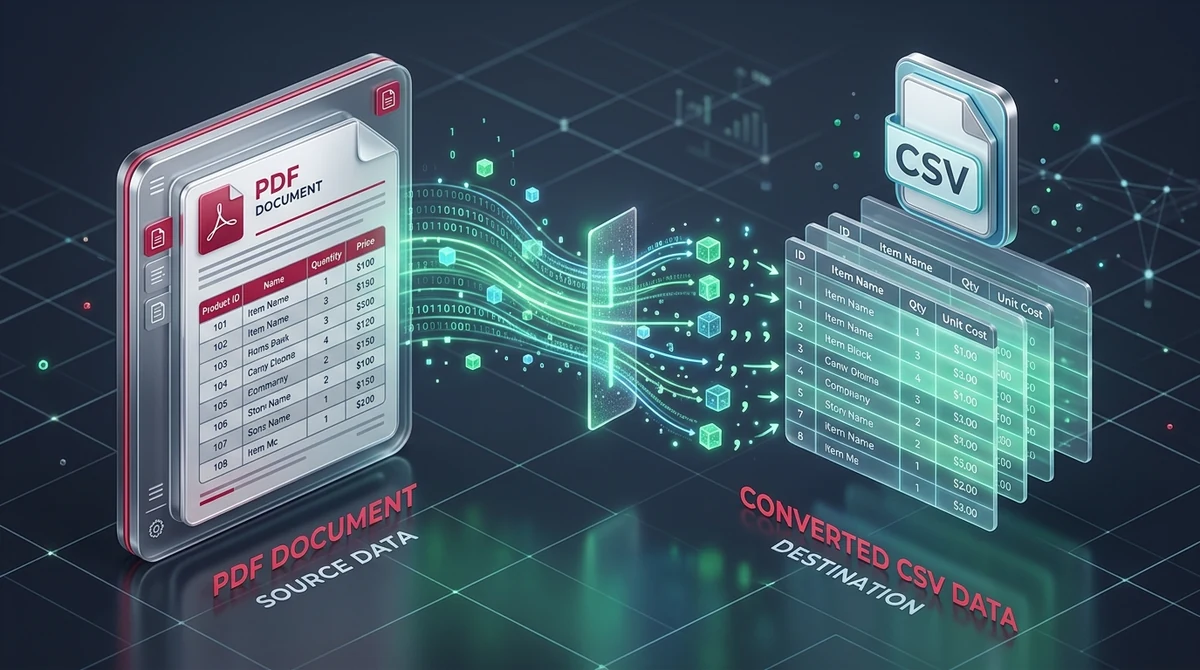
PDF内の表データをオンラインで無料かつ綺麗なCSVファイルに変換するには、AZ2PDFのPDFからCSV変換ツールにドキュメントをアップロードします。格子検出(Lattice)とテキスト気流解析(Stream)を組み合わせた抽出エンジンが表の境界線を識別し、文字を正確な列にグループ化してRFC 4180標準に従い区切り文字をエスケープ処理し、サーバーのRAM上のみで安全に変換を実行します。
- 正確な列の整列:幾何学的な座標解析を用いて文字を正しい行と列にグループ化し、セルの結合やズレを防ぎます。
- データベースやプログラムに即活用可能:RFC 4180に準拠したUTF-8エンコードのカンマ区切り値を生成し、SQLインポートやPython pandas、会計ソフトに最適です。
- 完全無料・透かしなし:課金やアカウント登録なしで無制限に表データを変換可能。広告スタンプも一切入りません。
- 厳格な財務プライバシー保護:ファイルは揮発性RAMバッファ内でのみ処理され、変換完了後5分以内に自動デーモンによって完全に消去されます。
PDFの表を直接コピー&ペーストすると崩れる理由
毎月の経理作業、領収書の監査、在庫一覧のデータ移行などを行ったことがある方なら、誰もがこのストレスを経験したことがあるはずです。綺麗な表が含まれるPDFを開き、マウスで複数行を選択してコピーし、Excelやスプレッドシートに貼り付けます。しかし、整然とした表になるどころか、データは完全に崩壊してしまいます。
4つの異なる列の値がすべて単一のテキストセルに統合され、金額が住所欄に混ざり込み、日付が不規則に分断され、複数行にわたる説明文によって不要な空行が大量に生成されます。このテキストをデータベースやスクリプトに取り込もうとしても、行ごとのフィールド数が不一致となり即座にエラーが発生します。
この根本的な原因は、国際標準規格 ISO 32000 に基づく Portable Document Format (PDF) の構造にあります。行や列の論理階層で情報を保持するスプレッドシートやHTMLとは異なり、PDFは本質的に2Dベクター描画命令のキャンバスです。PDFには「テーブルのセル」という概念が存在せず、文字要素はページの左下隅を原点とするタイポグラフィポイント(1/72インチ)の直交座標平面上に絶対位置として配置されているだけなのです。
帳簿データや取引ログを即座に綺麗な表として取り出すには、AZ2PDFのPDFからCSV変換ツールをご利用ください。セル境界を自動識別し、データベースや機械学習にそのまま投入できるRFC準拠のCSVを生成します。
空間的テーブル抽出アルゴリズムの仕組み
座標情報のみを持つテキストを論理的な表形式データへと復元することは、ドキュメント解析における最難関課題の1つです。RFC 4180 仕様に準拠した高品質な Comma-Separated Values (CSV) を出力するため、専用エンジンは多段階のパイプラインを実行します。
1. バウンディングボックスとテキスト座標の解析
パーサーは各ページの低レベルコンテンツストリームを走査し、個々の文字の水平位置(x)、垂直位置(y)、幅、高さ、フォント情報を抽出してページ全体を幾何学的な座標クラウドとしてモデル化します。
2. 罫線ありテーブルのためのラティス検出(Lattice)
縦横の区切り線が存在するドキュメントでは、ベクターパスの交差判定を行うラティス解析が作動します。線の交点を計算することで、各セルの境界四角形を正確に再構築します。
3. 罫線なしテーブルのためのストリーム解析(Stream)
決算書などの多くは罫線がなく、余白(ホワイトスペース)のみで列を分けています。ストリームアルゴリズムはページ全体を垂直に走査し、連続する余白の帯を検出して自然な列境界を特定します。
4. RFC 4180に準拠したCSVフォーマット出力
行と列の行列を再構築した後、カンマ区切り、特殊文字を含むセルの二重引用符による囲み込み、内部引用符のエスケープ処理、および標準CRLF改行コードを適用してCSVを書き出します。
オンラインでPDFをCSVに変換する簡単3ステップ
専用ソフトのインストールや手作業による打ち直しを行うことなく、わずか数秒で表データを抽出できます。
- PDFファイルをアップロード: 表が含まれるPDFファイルをAZ2PDFの安全なアップロードエリアにドラッグ&ドロップします。
- 表構造の自動解析: 空間解析エンジンが瞬時に行と列の配置を認識し、正確なデータ行列を組み立てます。
- CSVファイルをダウンロード: 生成された標準UTF-8エンコードのCSVファイルを保存し、表計算ソフトやシステムに読み込ませます。
ExcelスプレッドシートではなくCSVを選択すべき理由
どちらも2次元データを扱いますが、システムの連携やデータ処理の現場ではCSVが圧倒的な利便性を発揮します。
1. 圧倒的な軽量性と普遍的な互換性
装飾情報を持たないプレーンテキストであるCSVは、同等のXLSXファイルと比較してファイルサイズが80%〜95%削減されます。有償ソフトを必要とせず、あらゆるOSやサーバー環境で直接扱えます。
2. データベースへの高速インポート
PostgreSQL、MySQL、あるいはSnowflakeやBigQueryなどのデータウェアハウスにおいて、CSVは標準のネイティブ入力形式です。SQL COPYコマンドなどを使用すれば、数百万行のデータをわずか数秒で読み込めます。
3. データサイエンスやプログラミングの自動化
Pythonならpandasライブラリを使って1行のコードで読み込みが完了します。また、grepやawkといったコマンドラインツールを使ってターミナル上で直接検索や加工が可能です。
関係者が書式設定された表の表示を求めている場合は、整ったレポート用に数式を保持したスプレッドシートファイルとして書き出すことも可能です。
複雑なレイアウトへの対応:複数ページ明細、請求書、罫線なし表
実際のビジネス文書は教科書のような単純な表ばかりではありません。プロ仕様の抽出エンジンは高度なレイアウトにも柔軟に対応します。
複数ページにまたがる連続テーブル
数十ページに及ぶ銀行明細書でも、ページ境界を越えて列の定義を維持し、次ページで列の位置が左右にズレる現象を防ぎます。
セル内での複数行テキスト
品名や摘要欄が3〜4行に折り返されている場合でも、行のバウンディングボックスを基準に同一レコードとして結合し、CSV上で不要な改行行が生成されるのを防ぎます。
スキャンした紙文書や画像PDF
紙をコピー機でスキャンしたPDFは文字データを持たない画像です。この場合は、まずOCR処理を適用して検索可能な透明テキスト層を付与してからCSV変換を行います。
データ整合性とセキュリティ:CSVインジェクションと文字化けの防止
外部から受け取った未検証のPDFからデータを抽出して表計算ソフトで開く際には、セキュリティ対策が欠かせません。
CSV数式インジェクション(DDE攻撃)の防止
悪意あるPDFのセルが「=」「+」「-」「@」などの数式開始文字で始まっている場合、Excelを開いた際に外部コマンドが実行されるリスクがあります。安全な抽出エンジンはこれらのセルを適切にエスケープ処理し、純粋なテキストとして扱わせます。
国際通貨記号とUTF-8文字エンコードの維持
円(¥)、ドル($)、ユーロ(€)などの通貨記号や日本語の特殊漢字が文字化け(Mojibake)しないよう、常に標準UTF-8エンコードで出力します。
プライバシー最優先:インメモリ処理が機密財務データを保護する仕組み
表形式のPDFには、銀行口座番号や役員報酬、取引先別単価など最高レベルの機密情報が含まれます。ファイルを永続保存するクラウドサービスにアップロードすることは大きなリスクです。
AZ2PDFは揮発性インメモリアーキテクチャを採用しています。ファイルは処理中のみRAMに保持され、物理ディスクに恒久保存されることはありません。また、自動クリーンアップデーモンにより、処理完了後5分以内にすべてのセッションデータが完全に消去されます。
連携ワークフロー:抽出後のデータクレンジングと統合
表の抽出は一連のドキュメント処理パイプラインの一工程です。各種ツールを組み合わせることで業務をさらに効率化できます。
複数月明細の事前結合: 12か月分の月次明細がある場合、あらかじめ1つのPDFに結合してから一括で年間CSVを出力できます。
対象ページのみの分割抽出: 膨大な年次報告書のうち対象の表が含まれるページだけを事前に切り出すことで、処理を高速化できます。
付随テキストの分離抽出: 表の周辺にある長文の法的注記をプレーンテキストとして分離し、表データと分けて管理できます。
機密性を維持しながら安全に作業を進められるAZ2PDFのドキュメント処理スイートを活用し、表データ抽出の業務効率を飛躍的に高めましょう。
❓ よくあるご質問(FAQ)
CSVはRFC 4180に準拠したカンマ区切りの軽量なプレーンテキストです。SQLデータベースへの投入やPythonスクリプト、自動化パイプラインに最適です。一方、Excel(XLSX)は装飾や複数シート、計算式を保持する形式です。分析やデータ移行が目的であれば、CSVの方が圧倒的に軽量で高速です。
関連トピック記事
PDFのページ整理や高度なドキュメント管理の技術をさらに詳しく学びましょう。
WebページのURLをPDFにオンライン変換する方法(フルページ保存・無料)
WebサイトのURLを高品質なPDFドキュメントへ無料でオンライン変換。1440px横向きレイアウト、CSS背景、フォントを透かしなしで完全再現します。
PDFをスキャン風にする方法(プリンター不要・無料の紙質感エフェクト)
デジタルPDFを紙をスキャンしたようなリアルな質感に無料オンライン変換。プリンターを使わずに微細な傾き、紙の繊維ノイズ、グレースケール濃淡を付加できます。
カラーPDFをグレースケール白黒に変換する方法(無料オンライン・容量70%削減)
カラーPDFを高品質なグレースケール(DeviceGray)に無料オンライン変換。高価なプリンターインクを節約し、ファイル容量を最大70%削減。

レイアウトを崩さずにPDFをWordに変換する方法(無料・編集可能)
フォント崩れや表のズレ、テキストボックス化を防ぎ、PDFを編集可能なWord DOCXに変換する手法を解説。ブラウザ完結で100%安全。
レイアウトを崩さずにWordをPDFに変換する方法(無料・安全)
フォント崩れや改行ずれを防ぎ、Word文書(DOCX/DOC)を高品質な標準PDFに変換する方法を解説。高速・完全無料・ブラウザ内完結のプライバシー保護。
PDFをJPG画像にオンラインで高画質変換する方法(無料・300 DPI対応)
PDFの各ページを無料かつ安全に高解像度JPG画像(300 DPI)に変換する方法を解説。プレゼン資料や各種書類を画質劣化なしでZIP一括ダウンロード可能。