PDFをXMLにオンラインで無料変換(座標付き構造化データの抽出)
結論と重要ポイント
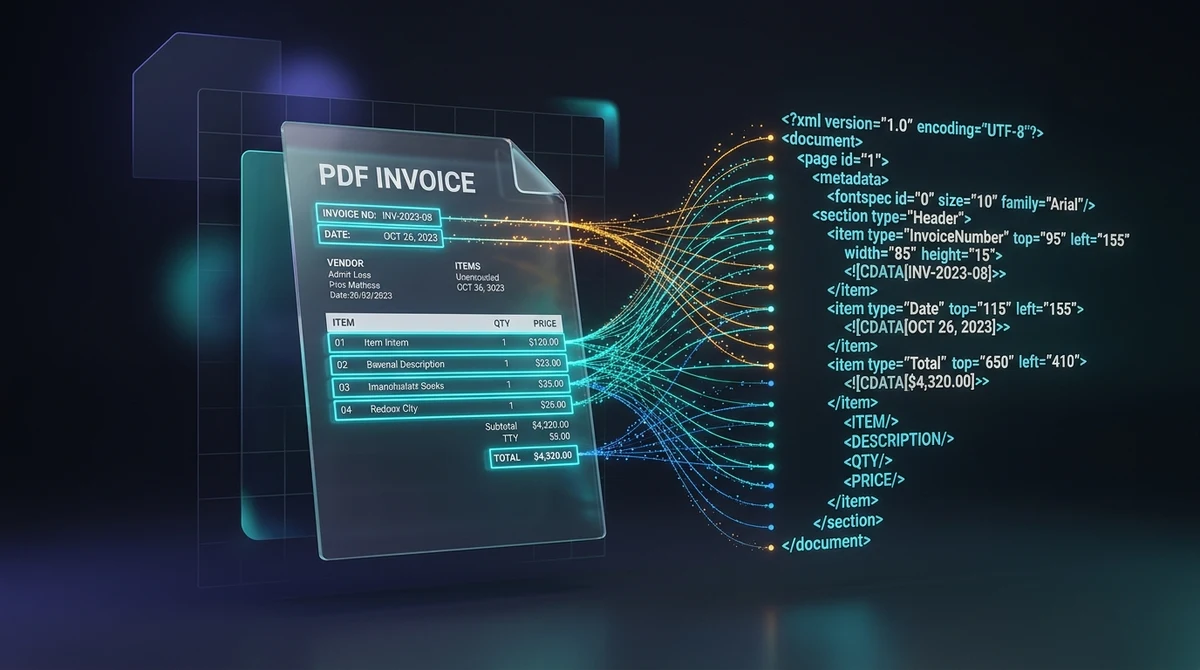
PDFをオンラインで無料かつ安全にXMLへ変換するとは、視覚的なレイアウト情報を絶対的な空間座標(top、left、width、height)およびフォント属性を含む階層構造のExtensible Markup Languageタグに変換する技術です。AZ2PDFの変換エンジンにより、データエンジニアや開発者はソフトウェア不要、完全無料かつメモリ保護された環境で、機械可読な構造化テキストをわずか数秒で抽出できます。
- 空間座標の完全保持:すべてのテキスト要素に厳密なバウンディングボックス属性(top、left、width、height)とフォント情報が付与され、座標に基づく高精度なデータ抽出が可能。
- 機械可読な階層型データ:固定的な視覚ページを構造化されたXMLノード(page、fontspec、text)に変換し、Python、Node.js、ERPシステムへの自動取り込みに対応。
- 請求書処理やETLパイプラインに最適:複数列の財務諸表、企業間請求書、税務帳票の空間的位置関係を崩さずに解析可能。
- 100%無料・RAM内即時処理:AZ2PDFはサーバーの揮発性RAM上でのみファイルを処理し、料金不要、アカウント登録不要、透かしなし、5分以内の自動完全消去を徹底。
データ抽出の課題:なぜPDFはビジネス情報を閉じ込めてしまうのか
現代の企業情報システムにおいて、Portable Document Format(PDF)は信頼性の高い文書形式である一方、自動化にとって最大の障壁でもあります。ISO 32000で国際標準化されたPDFは、文字やベクター描画、余白を紙の印刷物と同様に完全に固定して表示することに特化しています。PC、スマートフォン、オフィスのプリンターなど、どの環境でも寸分違わず同じレイアウトが保たれます。
しかし、人間にとって見やすいこの固定レイアウトは、プログラムによる自動解析を著しく困難にします。PDFファイルはデータベースのテーブルやExcelのような意味論的なデータツリーを保持していません。「行」「列」「小計」「請求書番号」といった概念をPDF自体は認識しておらず、単に座標(X=150, Y=720)にこの文字列を描画するという描画コマンドの集まりに過ぎません。
一般的なテキスト抽出ツールで強引にテキストを取り出そうとすると、以下のような問題が生じます:
- 複数列で構成された表組が1つの無秩序なテキスト列に崩れてしまう。
- ヘッダー、フッター、ページ番号が実データの合間に無作為に混ざり込む。
- 「消費税」というラベルの直下に金額が並んでいるという空間的関係性が失われる。
PDFを構造化されたExtensible Markup Language(XML)に変換することで、文字情報とページ上の正確な幾何学的座標の双方が階層モデルとして抽出され、この問題を根本から解決できます。
PDFからXMLへの変換とは?出力データの構造と特徴
PDFからXMLへの変換は、ドキュメントの視覚的配置を解析し、標準的なDTD仕様(Poppler pdf2xmlなど)に準拠した整然としたXMLオブジェクトモデルへ書き出す処理です。単なるプレーンテキストの出力とは異なり、ページごとに要素が整理され、フォント情報がマッピングされ、各テキスト断片にバウンディングボックスの境界座標が付与されます。
生成されるXML構文の具体的な構造は以下のとおりです:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>このように整理された出力があれば、自動化スクリプトはデータの位置を推測する必要がありません。top、left、width、heightの各属性を参照することで、あらゆるソフトウェアが紙面上の実座標に基づいて目的の数値をピンポイントで取得できます。
空間座標の仕組み:top、left、width、height、fontspecの理解
XML抽出の真価は、詳細な幾何学的メタデータにあります。各XML属性の意味を把握することで、極めて堅牢な自動処理パイプラインを構築できます:
- ページ境界の定義(<page>):ルートとなる
<page>要素は、キャンバスの寸法(標準ポイント単位でwidth="918" height="1188"など)を指定し、すべての子要素に対する基準グリッドを定義します。 - フォント仕様の定義(<fontspec>):文書内で使用されている全フォントを走査し、固有ID(
font="0"、font="1")を割り当てます。書体名、ポイントサイズ、文字色の16進コードが記録されるため、フォントサイズをもとに大見出しと注記テキストを自動判別できます。 - topとleftの座標:
top属性はページ上端からテキストのベースラインまでの垂直距離を表し、left属性はページ左余白からの水平オフセットを示します。 - widthとheightの寸法:テキスト枠の幅と高さを表し、表の列幅の算出や水平方向の行揃えの検証を容易にします。
- インライン装飾タグ:太字(
<b>)や斜体(<i>)などの強調スタイルがテキストノード内にそのまま保持され、重要ラベルの識別に役立ちます。
人間向けのPDF文書を構造化データセットに変換するには、AZ2PDFのPDFからXMLへの変換ツールをご活用ください。文字の座標やタイポグラフィ、階層構造を正確なXMLタグとして抽出します。
オンラインでPDFをXMLに変換する簡単3ステップ
特別なソフトウェアをPCにインストールすることなく、Webブラウザ上で直ちに実行できます:
ステップ1:PDFドキュメントをアップロード
変換したい請求書、財務諸表、技術仕様書などのPDFファイルをアップロードエリアにドラッグ&ドロップするか、端末から選択します。
ステップ2:高速エンジンによる空間データの自動解析
サーバーの揮発性RAM内でPDFの内部オブジェクト構造が解析されます。テキストブロックの配置、外枠の座標計算、フォント仕様のマッピングが瞬時に実行され、有効なXMLツリーが構築されます。
ステップ3:構造化XMLファイルをダウンロード
ダウンロードボタンをクリックして.xmlファイルを保存します。VS Codeなどのエディタで閲覧したり、アカウント登録なしですぐに自社システムへ取り込めます。なお、構造化された数値データを表計算ソフトで直接利用したい場合は、PDFをCSVにオンラインで無料変換する方法もあわせてご確認ください。
実践的な活用例:請求書処理、ETLパイプライン、Document AI学習
PDFからXMLへのデータ変換は、幅広い業務領域における自動化の基盤となっています:
- 経理部門における請求書・支払伝票の自動処理:取引先ごとにレイアウトが異なる多数の請求書を処理する際、従来の正規表現では限界があります。XMLであれば、「請求書番号や支払期日が記載される右上の座標ゾーン」といった位置指定で安定して抽出できます。
- データウェアハウス向けETLパイプライン:四半期決算書や行政資料などの大量ファイルを定期的に取り込む際、XML形式は汎用性が高く、Apache SparkやPython Airflow、リレーショナルデータベースと円滑に連携します。
- Document AIおよびLayoutLMの機械学習データセット:最新のレイアウト認識型ディープラーニングモデルは、文字と2次元バウンディングボックスの組み合わせを入力として必要とします。XML変換により、学習用の高品質な空間データセットを即座に生成できます。
- 企業間電子データ交換(EDI):SAPやOracleなどのERPシステムで発注を自動処理するには構造化データが不可欠です。PDFの注文書をXMLに変換することで、帳票と基幹システム間のスムーズな橋渡しが実現します。
実践パース:Python、lxml、XPathによるXMLデータの解析手法
XMLファイルを取得した後は、Pythonスクリプトを用いて目的のフィールドを容易に抽出できます。lxmlライブラリとXPathを組み合わせることで、座標条件に応じたピンポイントのテキスト抽出が可能です:
from lxml import etree

# 生成されたXMLファイルを読み込んでパース
tree = etree.parse("invoice.xml")
root = tree.getroot()

# 特定の座標範囲内にあるテキストノードをすべて抽出
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
print(f"{coordinates}: {text_node.text}")@top、@left、@fontを適切に組み合わせることで、帳票フォーマットにわずかなズレが生じても崩れにくい柔軟な抽出ルールを構築できます。
トラブルシューティング:スキャン文書、OCR、RAM内セキュリティ
安定した自動抽出フローを維持するために、以下の技術的ポイントに留意してください:
1. 文字データが含まれないスキャン文書
複合機のスキャナーやFAXから取り込んだPDFは、画像データのみで構成されている場合があります。XML変換エンジンは内部のベクター文字情報を抽出するため、画像だけのPDFを投入すると空のXMLが出力されます。この場合は、まずOCRでPDFからテキストを抽出する手順に従って不可視のテキスト層を生成してから、XMLへの変換を行ってください。
2. 大容量マルチページPDFの容量管理
ページ数が数百ページに及ぶ場合、詳細な座標属性が付与されるためXMLのファイルサイズが肥大化することがあります。アーカイブや通信の際はGzip等の圧縮技術を活用するのが効果的です。
3. 厳格なプライバシー保護と揮発性RAM処理
財務諸表や契約書には企業の機密情報が含まれます。AZ2PDFは万全のセキュリティ基準を徹底しています:
- 揮発性RAM上での一時処理:解析からXML生成までのすべての処理はサーバーのメモリ内でのみ実行され、ハードディスクにファイルが永続保存されることは一切ありません。
- 5分以内の自動完全破棄:バックグラウンドプロセスが常時監視し、処理完了後5分以内にすべての一時バッファを完全に消去します。
- アカウント不要・完全無料:メールアドレスや決済情報の入力は一切不要で、完全な匿名性が確保されます。
- 広告用透かしの完全排除:出力されるXMLは正式なDTD標準に準拠したクリーンなデータです。
安全かつ高速なPDF処理は、ブラウザから使えるAZ2PDFオンライン技術文書処理ツール群でお試しいただけます。
❓ よくあるご質問(FAQ)
テキスト抽出では空間的な配置が失われ、複数列の表やヘッダーが混ざり合ってしまいます。CSVは規則正しい表組を前提としています。XMLはバウンディングボックスの座標情報(top、left、width、height)を保持するため、デザインに左右されず座標ゾーンを指定して目的のデータを確実に抽出できます。
関連トピック記事
PDFのページ整理や高度なドキュメント管理の技術をさらに詳しく学びましょう。
オンラインでPDFをCSVに無料変換する方法(綺麗な表抽出)
PDFの表データを綺麗で構造化されたCSVファイルにオンラインで無料変換。銀行明細書や請求書を列崩れや透かしなしで正確に抽出します。
オンラインでPDFをテキストに無料変換する方法(クリーンなTXT抽出)
PDFから書式なしのプレーンテキストをオンラインで無料抽出。複数段組みページも崩さず文字化けのないクリーンなUTF-8 TXTファイルに変換します。

スキャンしたPDFからOCRで文字を抽出する方法(無料&高精度)
スキャンした紙の書類や写真PDFを、無料の多言語OCRで検索・選択可能なテキストに変換。高速、高精度、ブラウザ完結でプライバシー完全保護。
PDFをHTMLにオンラインで無料変換(クリーンなコードとレイアウト保持)
PDF文書を高品質なレスポンシブHTML5およびCSSウェブページにオンラインで無料変換。フォント、スタイル、ベクターグラフィックを透かしなしで保持。
HTMLファイルをレイアウトを崩さずにオンラインでPDFに変換する方法
HTMLファイルとCSSスタイルを印刷用PDF文書にオンラインで無料変換する方法を解説します。フォント、改ページ、レイアウトを透かしなしで完璧に維持。
PDFをEPUBにオンラインで無料変換する方法(電子書籍リーダー向けリフローテキスト)
固定レイアウトのPDF文書をリフロー型EPUB電子書籍にオンラインで無料変換。KindleやKobo、スマホでピンチズームに疲れることなく快適に読書できます。