Sådan udtrækker du tekst fra scannet PDF med OCR (Gratis & Sikkert)
Direkte Svar & Vigtigste Pointer
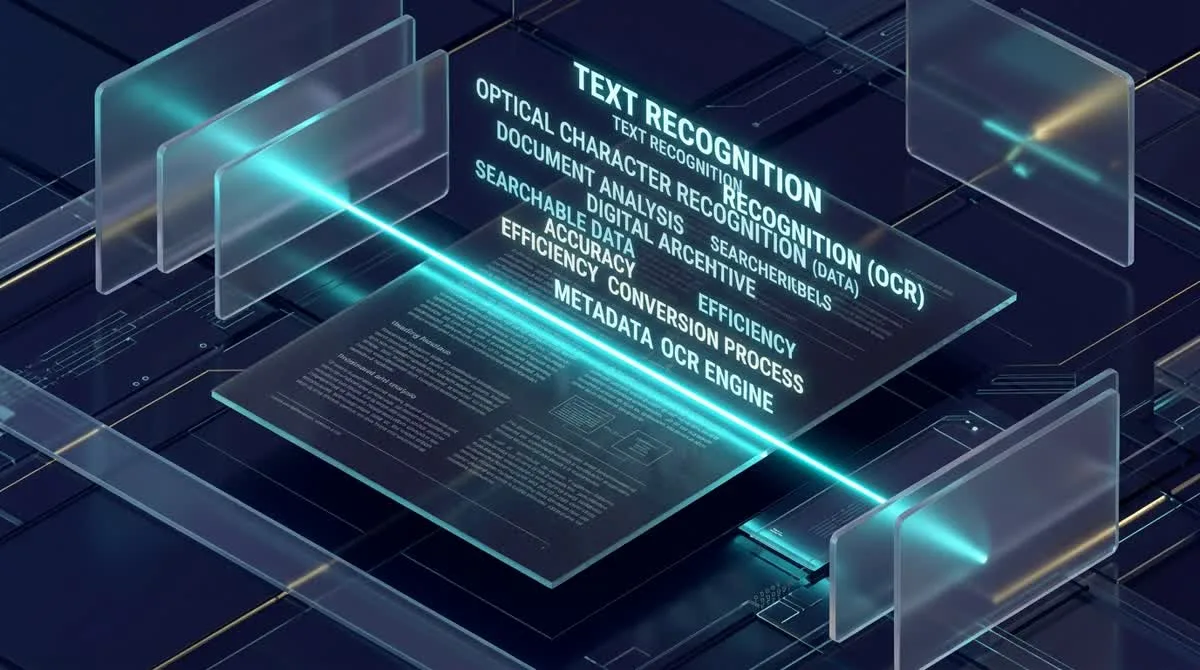
For at udtrække tekst fra en scannet PDF eller et fotodokument analyserer optisk tegngenkendelse (OCR) pixelmønstre, identificerer skrifttegn på over 100 sprog og indsætter et usynligt vektor-tekstlag under originalbilledet. Med AZ2PDF OCR PDF oprettes en søgbar sandwich-PDF direkte i browseren med fuldstændigt privatliv og automatisk RAM-rensning efter 5 minutter.
- Låser fastlåst tekst op: Omdanner flade scanninger og fotokopier til markerbare og søgbare filer med fuld understøttelse af Ctrl+F.
- Bevarer visuel ægthed: Skaber en sandwich-PDF, der fastholder håndskrevne underskrifter, stempler og layout, mens et usynligt tekstlag tilføjes under.
- Præcision på over 100 sprog: Genkender bogstaver, accenter og danske tegn (æ, ø, å) med høj nøjagtighed via integrerede ordbøger.
- Fuldstændig fortrolighed i RAM: Følsomme filer behandles udelukkende i flygtig RAM på NVMe-lager og slettes automatisk efter 5 minutter.
Hvorfor scannede PDF-filer låser teksten (og hvad OCR egentlig gør)
Enhver, der arbejder med digitale dokumenter, kender denne situation: du modtager en væsentlig kontrakt, en gammel tinglysning eller en kvittering i PDF-format og trykker Ctrl+F eller Command+F for at finde et specifikt beløb eller en paragraf. Der sker intet. Du prøver at markere et afsnit med musen for at kopiere det ind i en e-mail, men markøren glider hen over skærmen som på en glasrude. Ikke et eneste ord kan markeres.
For at forstå årsagen skal man se på, hvordan forskellige PDF-dokumenter oprettes:
- Oprindelige digitale vektor-PDF-filer: Når du gemmer et dokument fra Microsoft Word, Google Docs eller InDesign som PDF, indlejrer programmet faktiske tegnkoder (Unicode) og vektorskrifttyper. PDF-læseren forstår tegnenes rækkefølge, og teksten er umiddelbart søgbar og markerbar.
- Scannede bitmap-PDF-filer: Når papir scannes eller fotograferes med telefonen, forstår enheden ikke sprog. Sensorerne registrerer udelukkende et gitter af farvede punkter (et foto). Selvom det menneskelige øje ser ord og tabeller, indeholder PDF-filen blot et billede af et stykke papir.
Her er optisk tegngenkendelse (Optical Character Recognition – OCR) uundværlig. OCR er en teknologi, der undersøger geometrien i pixelmønstre, identificerer bogstaver i forskellige alfabeter og omdanner disse billedfelter til reel digital tekst.
Gør indholdet i flade scanninger tilgængeligt med AZ2PDF OCR PDF-værktøjet. Avancerede algoritmer identificerer flersproget typografi og opretter et usynligt, søgbart tekstlag, der matcher billedet præcist.
Sandwich-PDF-arkitekturen: sådan virker det usynlige tekstlag
Mange er bekymrede for, om OCR-behandling vil ændre layoutet, forvrænge virksomhedens logo eller fjerne håndskrevne underskrifter. Moderne dokumenthåndtering løser dette med en smart standard: sandwich-PDF (eller søgbar billed-PDF).
En sandwich-PDF er opbygget af to perfekt synkroniserede lag:
- Det øverste lag (det scannede billede i høj opløsning): Den visuelle scanning bevares 100 % uændret i forgrunden. Håndskrevne underskrifter, officielle stempler og papirtekstur bevares præcis som indscannet.
- Det nederste lag (usynlig vektortekst): Lige under billedet danner OCR-motoren en matematisk afstemt tekststrøm. I henhold til ISO 32000-standarden vises denne tekst i gengivelsestilstand 3 (uden udfyldning eller kant), så den er helt gennemsigtig for øjet.
Eftersom de usynlige bogstaver har identiske koordinater (X- og Y-akser, grundlinje og skriftstørrelse) som de synlige ord ovenover, føles det helt naturligt: når du trækker musen hen over teksten, vælger du det skjulte tekstlag, Ctrl+C kopierer teksten til udklipsholderen, og Ctrl+F fremhæver ordene direkte på siden.
Opløsning og belysning: hvorfor OCR kræver mindst 300 DPI
Nøjagtigheden i OCR-motoren afhænger direkte af billedets optiske skarphed. Ligesom et menneske har svært ved at tyde uskarpe bogstaver, skal computeren bruge skarp kontrast for at kende forskel på ensartede tegn:
- Guldstandarden på 300 DPI: Til kontordokumenter giver scanning ved 300 punkter pr. tomme (DPI) den ideelle balance mellem filstørrelse og genkendelsespræcision. Ved 300 DPI har små bogstaver som 'e', 'c' og 'o' åbne cirkler, så de ikke forveksles.
- Risikoen ved lav opløsning (under 150 DPI): Scanninger ved 72 eller 100 DPI eller kraftig JPEG-komprimering resulterer ofte i læsefejl: 'rn' smelter sammen til 'm', 'cl' bliver til 'd', og tallet '1' forveksles med lille 'l' eller stort 'I'.
- Retning og hældningskorrektion: Hvis papiret føres skævt ind i scanneren, bliver tekstlinjerne skrå. Gode OCR-motorer opdager vinklen automatisk og retter siden op inden tekstgenkendelsen.
- Jævnt lys ved smartphone-fotos: Når du affotograferer en kvittering med mobilen, bør du undgå kraftige skygger og genskin fra blankt papir for at sikre rene bogstavkanter.
Gør en scannet PDF søgbar med OCR i 3 enkle trin
Det tager kun få sekunder at gøre scannede dokumenter søgbare på computer, tablet eller mobil:
Trin 1: Upload din scannede PDF-fil
Træk og slip filen ind i arbejdsfeltet, eller klik på knappen for at vælge dokumentet på din enhed. Værktøjet håndterer både store flersidede rapporter, kontrakter og enkelte kvitteringer.
Trin 2: Vælg dokumentets sprog
Vælg dokumentets primære sprog. AZ2PDF understøtter mere end 100 sprog, herunder dansk, engelsk, tysk, fransk, spansk, arabisk og kinesisk. Valget aktiverer ordbøger, som sikrer fejlfri genkendelse af æ, ø og å.
Trin 3: Hent din søgbare PDF
Klik på knappen Behandl. OCR-motoren gennemgår siderne, placerer det usynlige tekstlag og danner en standardiseret sandwich-PDF. Klik på Download for at gemme filen uden vandmærker eller login.
Efter indekseringen kan du også udtrække råteksten direkte som ren ASCII eller UTF-8 til brug i databaser eller automatiserede arbejdsgange.
Praktiske anvendelser: når OCR sparer timevis af manuel indtastning
Hvor almindelige PDF-læsere blot viser scanninger som stumme billeder, giver OCR store tidsbesparelser i mange brancher:
1. Jura og sagsbehandling
Advokatkontorer og domstole gennemgår hundredvis af sider med retsdokumenter og tinglysninger. Med OCR kan du med Ctrl+F finde datoer, vidnenavne eller domsafsigelser på fem sekunder.
2. Bogholderi, fakturahåndtering og revision
Økonomiafdelinger modtager store mængder papirbilag. OCR gør CVR-numre, linjebeløb og kontonumre kopierbare, så man undgår tastefejl i regnskabsprogrammet.
3. Akademisk forskning og biblioteker
Forskere og studerende, der digitaliserer bøger eller artikler, kan kopiere citater direkte over i referenceprogrammer og søge på tværs af store digitale arkiver.
4. Digital tilgængelighed og skærmlæsere
I henhold til regler om webtilgængelighed (WCAG) skal digitale filer være tilgængelige for synshandicappede. Rene billed-PDF'er kan ikke læses af skærmoplæsere; OCR-tekstlaget gør det muligt for værktøjer som NVDA og VoiceOver at læse indholdet højt.
Privatliv forrest: flygtig RAM-behandling beskytter fortrolige filer
Dokumenter, der scannes, indeholder ofte meget personlige data: pas, sundhedskort, årsopgørelser, ansættelseskontrakter og patientjournaler.
Mange internettjenester gemmer filer på serverdiske eller anvender dem til at træne AI. Hos AZ2PDF er sikkerheden indbygget i systemets kerne:
- Behandling i flygtig RAM: Filerne åbnes kun i midlertidige RAM-buffere på hurtige NVMe-drev og skrives aldrig til faste diske.
- Automatisk sletning efter 5 minutter: En baggrundsproces fjerner alle midlertidige data definitivt inden for 5 minutter.
- Ingen AI-træning eller dataindsamling: Vi analyserer eller gemmer aldrig dine filer. Dit indhold tilhører udelukkende dig.
- 100 % gratis og uden oprettelse: Brug funktionerne frit uden abonnementer, kortoplysninger eller brugerkonto.
Tilknyttede arbejdsprocesser: hvad du kan gøre efter OCR-behandling
Når dit scannede dokument er blevet søgbart, kan du arbejde videre med det i AZ2PDF's øvrige moduler:
- Konverter til redigerbar Word: Har du brug for at omskrive tekst eller justere tabeller? Brug vores PDF til Word-konverter til at skabe et flydende DOCX-dokument.
- Udtræk tabeller til Excel: Indeholder dit scan regnskabstal, kan du overføre kolonner og rækker til et overskueligt XLSX-regneark.
- Formindsk tunge scanningsfiler: Scanninger i 300 DPI fylder ofte over 30 MB. Brug Komprimer PDF til at reducere filstørrelsen med op til 75 % uden at gøre teksten uskarpt.
- Tilføj noter og underskriv digitalt: Åbn filen i AZ2PDF PDF-editoren for at overstrege vigtige passager eller tegne din digitale underskrift direkte i browseren.
Gør dokumenthåndteringen hurtigere med AZ2PDF dokument- og OCR-suite – med førsteklasses tegngenkendelse og fuld sikkerhed for dine private papirer.
Hurtige løsninger på typiske problemer med OCR-scanning
Hvis tegngenkendelsen ikke giver det ønskede resultat, kan du prøve disse tre råd:
1. Fejl i æ, ø og å eller mærkelige tegn
Tjek, at du har valgt dansk som sprog i indstillingerne før start. Det henter den rette ordbog til danske bogstaver og specialtegn.
2. Ord der er smeltet sammen eller har forkerte mellemrum
Dette skyldes ofte for lav opløsning (under 150 DPI) eller rystede fotos. En ny scanning ved 300 DPI med rent fokus løser problemet med det samme.
3. Håndskrift bliver ikke konverteret korrekt
Standard-OCR er udviklet til maskinskrift og trykte bogstaver. Hvor trykt tekst genkendes med 99 % nøjagtighed, bevares håndskrevne noter og signaturer som visuelle billeder i forgrunden.
Ofte stillede spørgsmål (FAQ)
Gør dokumenthåndteringen hurtigere med AZ2PDF dokument- og OCR-suite – med førsteklasses tegngenkendelse og fuld sikkerhed for dine private papirer.
❓ Ofte Stillede Spørgsmål (FAQ)
En almindelig scannet PDF er blot en digital fil, der indeholder et billede af en side. Den rummer ingen digital tekst, så man kan hverken søge med Ctrl+F eller markere ord. En OCR-behandlet PDF (også kaldet en sandwich-PDF) integrerer et usynligt vektor-tekstlag bag originalbilledet, hvilket gør hvert ord søgbart og kopierbart uden at ændre dokumentets udseende.
Relaterede Artikler om Emnet
Få mere viden om professionel sideorganisering og dokumenthåndtering.

Sådan konverterer du PDF til PowerPoint online gratis (redigerbare dias)
Konverter PDF-dias til redigerbare Microsoft PowerPoint PPTX-præsentationer online gratis. Gendan vektortekst, figurer og billeder uden layoutfejl.

Sådan konverterer du PDF til Word uden at miste formateringen (Gratis)
Lær hvordan du konverterer PDF-dokumenter til redigerbare Word DOCX-filer uden brudte skrifttyper, forskudte tabeller eller tekstbokse. Hurtigt og 100 % privat.
Sådan konverterer du Word til PDF uden at miste formatering (Gratis og Sikkert)
Lær hvordan du konverterer Word DOCX- og DOC-dokumenter til standardiserede PDF-filer med fastlåste skrifttyper, intakte margener og uden linjeskiftfejl. Hurtigt, gratis og 100 % privat.
Konverter Excel til PDF online gratis uden afskårne kolonner
Konverter Excel-regneark (.xlsx, .xls, .csv) gratis online til overskuelige PDF-dokumenter. Undgå afskårne kolonner, vælg liggende format og beskyt formler.

Udflad PDF-formularer og annoteringer permanent
Lær hvordan du udflader udfyldelige PDF-formularfelter, afkrydsningsfelter, signaturer og kommentarer til faste udskriftslag. Undgå uautoriserede ændringer.

Sådan reparerer du beskadigede PDF-filer online (gratis og sikkert)
Lær hvordan du gratis reparerer ødelagte eller ulæselige PDF-filer online. Genopbyg defekte xref-tabeller og få sikker adgang til dine dokumenter igen.