Hvordan konvertere PDF til XML på nett gratis (strukturerte data med koordinater)
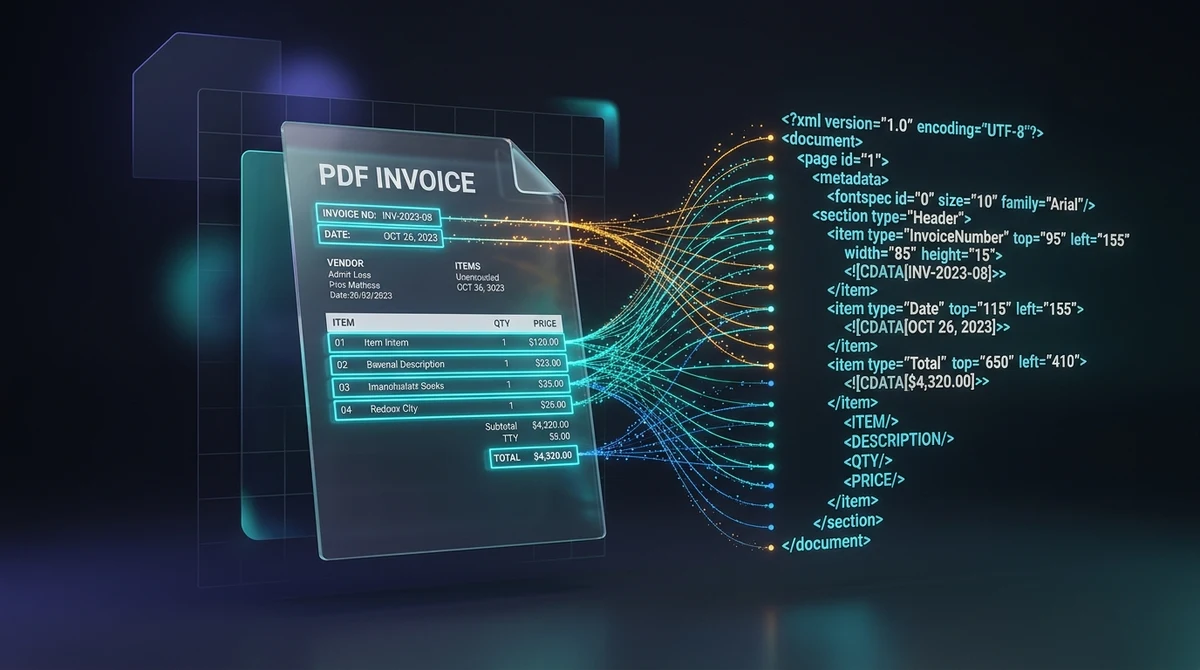
Direkte Svar & Hovedpunkter
Å konvertere PDF til XML på nett gratis innebærer å forvandle visuelle dokumentoppsett til hierarkiske Extensible Markup Language-koder med absolutte romlige koordinater (top, left, width, height) og skriftattributter. Med AZ2PDF-konverteren kan dataingeniører og utviklere hente ut maskinlesbare strukturerte tekstnoder på sekunder, 100 % gratis og sikkert i serverens flyktige RAM-minne.
- Bevar romlige koordinater: Hvert tekstelement merkes med nøyaktige avgrensningsboksattributter (top, left, width, height) og skriftparametere for presis koordinatbasert datautvinning.
- Maskinlesbare hierarkiske data: Gjør om statiske visuelle sider til strukturerte XML-noder (page, fontspec, text) klare for automatisert innlesing i Python, Node.js og ERP-systemer.
- Essensielt for fakturaer og ETL-arbeidsflyter: Ideelt for å analysere flerdelte økonomiske rapporter, B2B-fakturaer og skatteskjemaer uten å miste romlige relasjoner.
- 100 % gratis med direkte minnebehandling: AZ2PDF behandler filene dine i serverens flyktige RAM, uten avgifter, uten registrering, uten vannmerker og med automatisk sletting etter 5 minutter.
Problemet med datautvinning: Hvorfor PDF låser inne forretningsdata
I moderne bedrifts-IT er Portable Document Format (PDF) både en uvurderlig standard og en betydelig hindring for automatisering. Standardisert under ISO 32000 utmerker PDF seg ved visuell nøyaktighet: det låser fast ord, vektorelementer og marger i en eksakt digital kopi av en trykket side. Enten dokumentet åpnes på en datamaskin, telefon eller skrives ut på papir, forblir utseendet identisk.
Det som gjør PDF ideelt for menneskelig lesing, gjør det imidlertid svært vanskelig for programvare å tolke. En PDF-fil lagrer ikke et semantisk datatre slik som en databasetabell eller et Excel-ark. Filen forstår ikke i seg selv hva en rad, kolonne, delsum eller et fakturanummer er, men inneholder kun grafiske tegneinstruksjoner: direkte ordrer som tegn denne tegnstrengen ved koordinat X=150, Y=720.
Når utviklere eller dataingeniører forsøker å trekke ut tekst ved hjelp av vanlige tekstekstraksjonsverktøy, oppstår kjente utfordringer:
- Tabeller med flere kolonner faller sammen til én enkelt uordnet tekststrøm.
- Topptekster, bunntekster og sidenumre blandes tilfeldig inn i datainnholdet.
- Romlige relasjoner (som at et beløp står plassert rett under en avgiftsmerknad) forsvinner fullstendig.
Å konvertere PDF-dokumentet til strukturert Extensible Markup Language (XML) løser dette ved å fange opp både teksten og den eksakte todimensjonale geometrien i et maskinlesbart hierarki.
Hva er PDF til XML-konvertering og hvordan ser utdataene ut?
PDF til XML-konvertering analyserer den visuelle dokumentstrukturen og oversetter den til en velorganisert XML-objektmodell i tråd med anerkjente DTD-standarder (som Poppler pdf2xml). I stedet for å dumpe flat tekst, grupperer motoren elementene side for side, indekserer skriftegenskaper og merker hvert tekstfragment med koordinatene for dets avgrensningsboks (bounding box).
Her er et autentisk utdrag av den resulterende XML-syntaksen:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Med denne oversiktlige strukturen slipper automatiserte skript å gjette hvor dataene hører hjemme. Ved å lese av attributtene top, left, width og height kan programvaren finne opplysningene basert på faktiske koordinater på arket.
Romlige koordinater: Forstå top, left, width, height og fontspec
Hovedfortrinnet med XML-ekstraksjon ligger i de rike geometriske metadataene. Ved å mestre disse attributtene kan du bygge robuste datapipelines:
- Sidedimensjoner (<page>): Rotelementet
<page>definerer arkets fysiske mål (f.eks.width="918" height="1188"i standardpunkter) og danner koordinatsystemet for alle underelementer. - Skrifttypedeklarasjoner (<fontspec>): Parseren katalogiserer alle skrifttyper i dokumentet og tildeler unike ID-er (
font="0",font="1"). Hver<fontspec>spesifiserer skriftfamilie, punktstørrelse og heksadesimal fargekode, slik at skript automatisk kan skille overskrifter fra fotnoter basert på skriftstørrelsen. - top- og left-koordinater:
topangir den vertikale avstanden fra sidens overkant ned til tekstens grunnlinje.leftangir horisontal avstand fra venstremargen. - width- og height-attributter: Disse angir bredden og høyden på tekstens avgrensningsboks, noe som forenkler beregning av kolonnebredder og kontroll av horisontal justering.
- Innebygde formateringstagger: Fet (
<b>) og kursiv (<i>) stil bevares direkte i tekstnodene, noe som hjelper til med å identifisere nøkkelord og etiketter.
Konverter dokumenter til strukturerte maskinlesbare datasett med AZ2PDF PDF til XML-konverteren, som overfører koordinater og hierarkier til standardiserte XML-tagger.
Hvordan konvertere PDF til XML på nett i 3 enkle trinn
Konvertering av PDF til strukturert XML utføres på under ett minutt direkte i nettleseren din:
Trinn 1: Last opp PDF-dokumentet ditt
Dra og slipp fakturaen, regnskapsrapporten eller den tekniske spesifikasjonen i opplastingsfeltet, eller klikk for å velge filen fra enheten din.
Trinn 2: Automatisk behandling av romlige data
Vår høytytende motor analyserer PDF-objektstrukturen i serverens flyktige RAM. Den kartlegger tekstblokker, beregner avgrensningskoordinater, registrerer skrifttabeller og bygger et gyldig XML-tre.
Trinn 3: Last ned den strukturerte XML-filen
Klikk på Last ned for å lagre .xml-filen. Den er klar til å åpnes i kodeeditorer som VS Code eller kobles direkte til bedriftens datasystemer uten registrering. Trenger du i stedet å behandle enkle tabeller i regneark, kan du også lære hvordan du konverter PDF til CSV på nett for rask import til Excel.
Viktige bruksområder: Fakturaer, ETL-arbeidsflyter og Document AI-trening
Konvertering fra PDF til XML utgjør ryggraden i storskala automatisering på tvers av bransjer:
- Automatisert fakturabehandling: Regnskapsavdelinger håndterer månedlig tusenvis av leverandørfakturaer med varierte oppsett. Regulære uttrykk svikter ofte ved designendringer. Med XML kan skript sikte seg inn på faste koordinatsoner (for eksempel det øvre høyre hjørnet for fakturanummer og forfallsdato).
- ETL-arbeidsflyter (Extract, Transform, Load): Datalagre samler jevnlig inn kvartalsrapporter og forsikringskrav. XML gir et nøytralt og standardisert format som enkelt integreres med Apache Spark, Python Airflow og relasjonsdatabaser.
- Trening av Document AI og LayoutLM: Moderne dyplæringsmodeller krever både tekst og todimensjonale avgrensningsbokser for å forstå dokumentoppsett. XML gir optimale romlige treningsdata.
- Elektronisk datautveksling (EDI): ERP-systemer (SAP, Oracle) krever strukturerte data for automatisk ordrehåndtering. Å konvertere innkjøpsordrer i PDF til XML bygger bro mellom visuelle dokumenter og ERP-prosesser.
Praktisk parsing: Bruk Python, lxml og XPath på XML-filen din
Når XML-filen er lastet ned, er det enkelt å skrive et Python-skript for å hente ut spesifikke felter. Med biblioteket lxml og XPath kan du filtrere tekstnoder basert på koordinater:
from lxml import etree

# Les inn og tolk den genererte XML-filen
tree = etree.parse("faktura.xml")
root = tree.getroot()

# Hent alle tekstnoder innenfor et bestemt koordinatområde
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Ved å kombinere @top, @left og @font etablerer du solide uttrekkingsregler som forblir stabile selv ved små layoutendringer.
Feilsøking: Skannede dokumenter, OCR og personvern i RAM
For å oppnå et optimalt arbeidsflytresulat bør du merke deg følgende tekniske råd:
1. Skannede papirdokumenter uten digital tekst
Hvis PDF-dokumentet er opprettet via en skanner uten optisk tegngjenkjenning, inneholder det kun punktgrafikkbilder. Fordi konvertereren henter ut ekte vektortekst, vil en ren bilde-PDF gi en tom XML-struktur. Les vår veiledning om hvordan du kan trekk ut tekst fra PDF med OCR for å opprette et digitalt tekstlag før du konverterer til XML.
2. Håndtering av store flersidige dokumenter
Ved dokumenter på hundrevis av sider kan XML-filen bli omfangsrik på grunn av de detaljerte koordinatattributtene for hvert tekstfragment. Bruk gjerne Gzip-komprimering ved lagring og overføring over nettverk.
3. Fullt personvern og behandling utelukkende i RAM
Fakturaer, avtaler og regnskapsdokumenter inneholder forretningshemmeligheter. Vår plattform følger strenge sikkerhetskrav:
- Behandling kun i RAM: Analyse og oppbygging av XML-treet foregår utelukkende i serverens flyktige RAM-minne og skrives aldri til permanente harddisker.
- Automatisk sletting etter 5 minutter: En bakgrunnsprosess sletter permanent alle midlertidige buffere innen fem minutter etter fullføring.
- 100 % gratis uten registrering: Du slipper å oppgi e-postadresse eller betalingsinformasjon, noe som sikrer full anonymitet.
- Ingen vannmerker: Den genererte XML-filen er ren og samsvarer med offisielle DTD-standarder.
Utforsk flere effektive løsninger i AZ2PDF teknisk verktøysett for PDF direkte i din egen nettleser.
❓ Ofte Stilte Spørsmål (FAQ)
Vanlig tekstfjerning fjerner all romlig informasjon og slår sammen kolonner og overskrifter til en uordnet streng. CSV krever strenge tabellrutenett. XML bevarer den eksakte fysiske plasseringen til hvert ord via avgrensningsboksattributter (top, left, width, height), slik at programmer kan hente ut data basert på koordinatsoner uavhengig av tabelloppsett.
Relaterte Artikler om Emnet
Lær mer om profesjonell sideorganisering og dokumenthåndtering.
Konverter PDF til CSV på nett gratis (ren tabellekstraksjon)
Lær hvordan du konverterer PDF-tabeller til rene, strukturerte CSV-filer på nett gratis. Trekk ut kontoutskrifter og fakturaer uten kolonnefeil.
Konverter PDF til tekst på nett gratis (ren TXT-uttrekking)
Lær hvordan du trekker ut uformatert ren tekst fra PDF-dokumenter på nett gratis. Gjør om flerdelte sider til feilfrie UTF-8 TXT-filer for AI og koding.

Hvordan trekke ut tekst fra skannet PDF med OCR (Gratis & Sikkert)
Lær hvordan du konverterer skannede papirdokumenter og bilde-PDF-er til søkbar og markerbar tekst med gratis flerspråklig OCR. Raskt, nøyaktig og 100 % privat i nettleseren.
Konverter PDF til HTML på nett gratis (ren kode og nøyaktig layout)
Lær hvordan du konverterer PDF-dokumenter til responsive HTML5- og CSS-nettsider på nett helt gratis. Bevar skrifter, oppsett og grafikk uten vannmerker.
Hvordan konvertere HTML-filer til PDF på nett uten tap av formatering
Lær hvordan du konverterer HTML-filer og CSS-stiler til utskriftsklare PDF-dokumenter gratis på nett. Behold nøyaktige skrifttyper, sideskift og layout uten vannmerker.
Hvordan konvertere PDF til EPUB på nett gratis (flytende tekst for leseplater)
Lær hvordan du konverterer PDF-dokumenter til flytende EPUB-e-bøker på nett gratis. Les behagelig på Kindle, Kobo og Apple Books uten slitsom zooming.