Miten muuntaa PDF XML:ksi verkossa ilmaiseksi (rakenteinen data koordinaateilla)
Suora Vastaus & Tärkeimmät Huomiot
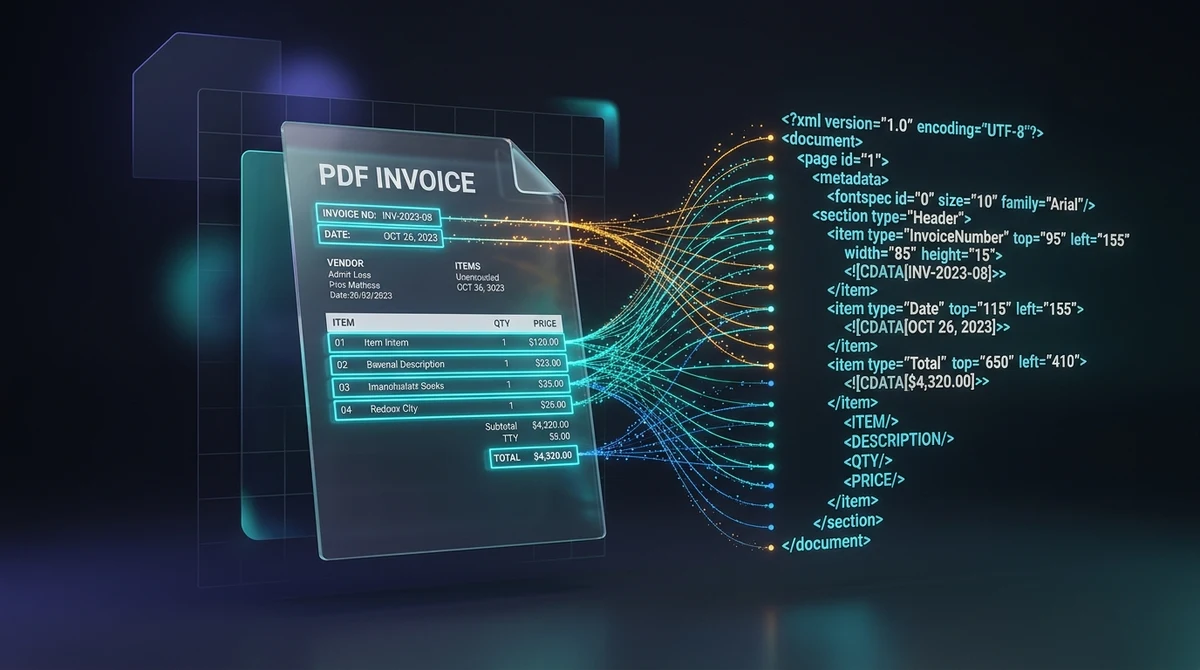
PDF:n muuntaminen XML:ksi verkossa ilmaiseksi tarkoittaa visuaalisten asettelujen muuntamista hierarkkisiksi Extensible Markup Language -tageiksi, jotka sisältävät absoluuttiset koordinaatit (top, left, width, height) ja fonttimääritteet. AZ2PDF-muuntimella data-insinöörit ja kehittäjät voivat purkaa koneluettavia strukturoituja tekstisolmuja sekunneissa, täysin ilmaiseksi ja turvallisesti haihtuvassa RAM-muistissa.
- Säilytä tila-koordinaatit: Jokainen tekstielementti varustetaan tarkoilla rajauslaatikon attribuuteilla (top, left, width, height) ja fonttimäärityksillä tarkkaa koordinaattipohjaista tiedonhakua varten.
- Koneluettava hierarkkinen data: Muuntaa jäykät visuaaliset sivut jäsennellyiksi XML-solmuiksi (page, fontspec, text), jotka ovat valmiita automaattiseen käsittelyyn Pythonissa, Node.js:ssä ja ERP-järjestelmissä.
- Välttämätön laskuille ja ETL-putkille: Ihanteellinen monisarakkeisten talousraporttien, B2B-laskujen ja verolomakkeiden käsittelyyn ilman geometristen suhteiden katoamista.
- 100 % ilmainen ja välitön muistikäsittely: AZ2PDF käsittelee tiedostosi suoraan palvelimen haihtuvassa RAM-muistissa ilman maksuja, ilman rekisteröitymistä, ilman vesileimoja ja poistaa tiedot automaattisesti 5 minuutin kuluessa.
Tiedon purkamisen ongelma: Miksi PDF lukitsee yritystiedot sisäänsä
Nykyaikaisessa yritystietotekniikassa Portable Document Format (PDF) on sekä korvaamaton esitysstandardi että huomattava este automaatiolle. ISO 32000 -standardin mukainen PDF on suunniteltu visuaalista täydellisyyttä varten: se lukitsee sanat, vektorit ja marginaalit tulostetun sivun tarkkaan digitaaliseen vastineeseen. Riippumatta siitä, avataanko tiedosto tietokoneella, puhelimella vai toimistotulostimella, asiakirjan asettelu pysyy täysin muuttumattomana.
Tämä inhimilliselle silmälle täydellinen ominaisuus tekee siitä kuitenkin erittäin haastavan ohjelmalliselle käsittelylle. PDF-tiedosto ei tallenna semanttista tietorakennetta, kuten tietokantataulua tai taulukkolaskentatiedostoa. Tiedosto ei luonnostaan tunnista, mikä on rivi, sarake, välisumma tai laskun numero. Se sisältää vain graafisia piirtokäskyjä: suoria määräyksiä kuten piirrä tämä merkkijono koordinaatteihin X=150, Y=720.
Kun kehittäjät tai data-analyytikot yrittävät purkaa tekstiä tavanomaisilla tekstityökaluilla, syntyy tuttuja ongelmia:
- Monisarakkeiset taulukot romahtavat yhdeksi sekavaksi tekstivirraksi.
- Ylätunnisteet, alatunnisteet ja sivunumerot sekoittuvat satunnaisesti varsinaisten tietojen joukkoon.
- Tärkeät tilasuhteet (kuten tieto siitä, että rahasumma sijaitsee suoraan verorivin alapuolella) katoavat kokonaan.
PDF:n muuntaminen rakenteiseksi Extensible Markup Language (XML) -muodoksi poistaa tämän esteen tallentamalla sekä tekstisisällön että sen tarkan kaksiulotteisen geometrian koneluettavaan hierarkiaan.
Mitä on PDF:n muuntaminen XML:ksi ja miltä tulos näyttää?
PDF:n muuntaminen XML:ksi analysoi asiakirjan visuaalisen asettelun ja kääntää sen jäsennellyksi XML-oliomalliksi virallisten DTD-määritysten (kuten Poppler pdf2xml) mukaisesti. Pelkän suoran tekstin sijaan moottori ryhmittelee elementit sivuittain, indeksoi kirjasinmääritykset ja merkitsee jokaisen tekstinpätkän rajauslaatikon (bounding box) koordinaateilla.
Tässä on aito esimerkki muodostuvasta XML-syntaksista:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Tämän selkeän rakenteen ansiosta automaatiokoodien ei enää tarvitse arvailla tiedon sijaintia. Lukemalla attribuutit top, left, width ja height mikä tahansa sovellus voi paikantaa tarvittavat tiedot niiden fyysisen sivusijainnin perusteella.
Sijaintikoordinaatit: Opi ymmärtämään top, left, width, height ja fontspec
XML-purkamisen suurin hyöty perustuu sen rikkaaseen geometriseen metadataan. Näiden attribuuttien hallinta mahdollistaa häiriönsietokykyisten tietovirtojen rakentamisen:
- Sivun mitat (<page>): Juurielementti
<page>määrittelee tulostussivun fyysiset mitat (esim.width="918" height="1188"standardipisteinä) ja asettaa koordinaatiston kaikille alielementeille. - Fonttimääritykset (<fontspec>): Jäsennin luetteloi kaikki tiedostossa käytetyt kirjasintyylit ja antaa niille uniikit tunnisteet (
font="0",font="1"). Jokainen<fontspec>kertoo fonttiperheen, pistekoon ja heksavärikoodin, minkä ansiosta ohjelma pystyy erottamaan pääotsikot alaviitteistä koon perusteella. - top- ja left-koordinaatit:
top-attribuutti mittaa pystysuoran etäisyyden sivun yläreunasta tekstin perusviivaan.left-attribuutti ilmaisee vaakasuuntaisen etäisyyden vasemmasta reunasta. - width- ja height-attribuutit: Määrittävät tekstilaatikon leveyden ja korkeuden, mikä helpottaa sarakkeiden laskentaa ja vaakasuorien rivitysten tarkistamista.
- Tekstinsisäiset tyylitagit: Lihavointi (
<b>) ja kursivointi (<i>) säilyvät suoraan tekstisolmujen sisällä, mikä nopeuttaa avaintietojen tunnistamista.
Muunna asiakirjat koneellisesti luettaviksi tietorakenteiksi AZ2PDF PDF–XML-muuntimella, joka jäsentää koordinaatit ja semanttisen hierarkian XML-tunnisteiksi.
Miten muuntaa PDF XML:ksi verkossa 3 yksinkertaisessa vaiheessa
PDF-tiedostojen muuntaminen jäsennellyksi XML:ksi hoituu alle minuutissa suoraan verkkoselaimessa:
Vaihe 1: Lataa PDF-asiakirjasi
Vedä ja pudota laskusi, talousraporttisi tai tekninen määrityksesi latausalueelle, tai valitse tiedosto laitteeltasi.
Vaihe 2: Sijaintidatan automaattinen käsittely
Tehokas käsittelymoottorimme analysoi PDF-rakennetta palvelimen haihtuvassa RAM-muistissa. Se kartoittaa tekstiosiot, laskee reunakoordinaatit, lukee kirjasimet ja muodostaa kelvollisen XML-puun.
Vaihe 3: Lataa strukturoitu XML-tiedosto
Napsauta Lataa tallentaaksesi .xml-tiedoston. Voit avata sen heti koodieditorissa tai liittää yrityksesi taustajärjestelmiin ilman käyttäjätiliä. Jos tarvitset vain yksinkertaisten numerotaulukoiden käsittelyä, katso myös miten muunna PDF CSV:ksi verkossa suoraan Excel-yhteensopivaksi.
Korkean lisäarvon käyttötapaukset: Laskut, ETL-putket ja Document AI -koulutus
PDF:n muuntaminen XML:ksi toimii automaation tukipilarina monilla teollisuudenaloilla:
- Automaattinen ostolaskujen käsittely: Talousosastot vastaanottavat tuhansia laskuja eri toimittajilta erilaisilla asetteluilla. Säännölliset lausekkeet (regex) vikaantuvat helposti asettelun muuttuessa. XML:n avulla skriptit voivat kohdistaa noutonsa tiettyihin koordinaattialueisiin (kuten oikeaan yläkulmaan laskunumeron löytämiseksi).
- ETL-tietoputket (Extract, Transform, Load): Tietovarastot kokoavat säännöllisesti osavuosikatsauksia ja vakuutuskaavakkeita. XML tarjoaa alustariippumattoman formaatin, joka integroituu saumattomasti Apache Sparkiin, Python Airflow'hun ja relaatiotietokantoihin.
- Document AI- ja LayoutLM-mallien opetus: Nykyaikaiset asettelutietoiset syväoppimismallit tarvitsevat sekä tekstitokenit että 2D-rajauslaatikot sivujen ymmärtämiseen. XML tarjoaa optimaalisen spatiaalisen opetusdatan.
- Sähköinen tiedonsiirto (EDI): ERP-järjestelmät (kuten SAP ja Oracle) vaativat strukturoitua syötettä tilausten automatisointiin. PDF-tilausten muuntaminen XML:ksi yhdistää visuaalisen dokumentin ja ERP-automaation.
Käytännön jäsentäminen: Pythonin, lxml:n ja XPathin käyttö XML-tiedostolle
XML-tiedoston lataamisen jälkeen datan purkaminen Pythonilla on erittäin suoraviivaista. lxml-kirjastolla ja XPath-kyselyillä voit suodattaa tekstisolmuja niiden koordinaattien mukaan:
from lxml import etree

# Lataa ja jäsennä luotu XML-tiedosto
tree = etree.parse("lasku.xml")
root = tree.getroot()

# Hae kaikki tekstisolmut halutulta koordinaattialueelta
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Yhdistelemällä attribuutteja @top, @left ja @font rakennat kestäviä hakusääntöjä, jotka toimivat luotettavasti pienistä asettelusiirtymistä huolimatta.
Vianetsintä: Skannatut asiakirjat, OCR ja tietosuoja RAM-muistissa
Varmista sujuva tiedonpurkutyö huomioimalla nämä tekniset ohjeet:
1. Skannatut paperiasiakirjat ilman digitaalista tekstiä
Jos PDF on luotu skannerilla ilman optista tekstintunnistusta, se sisältää vain bittikarttakuvia. Koska muunnin lukee natiiveja vektoritekstejä, pelkkiä kuvia sisältävä PDF tuottaa tyhjän XML-rakenteen. Lue ohjeemme siitä, miten pura tekstiä PDF:stä OCR:llä luodaksesi digitaalisen tekstikerroksen ennen XML-muunnosta.
2. Suurikokoisten monisivuisten arkistojen hallinta
Satoja sivuja käsittävissä asiakirjoissa XML-tiedoston koko voi kasvaa huomattavasti yksityiskohtaisten koordinaattien vuoksi. Käytä Gzip-pakkausta tallennukseen ja verkkosiirtoon.
3. Täysi yksityisyys ja käsittely RAM-muistissa
Laskut, sopimukset ja henkilöstötiedot sisältävät arkaluonteisia liikesalaisuuksia. Palvelumme noudattaa tiukkoja turvallisuusperiaatteita:
- Käsittely vain RAM-muistissa: Kaikki jäsentäminen ja XML-tiedoston luonti tapahtuu vain palvelimen haihtuvassa keskusmuistissa, eikä tietoja kirjoiteta pysyville levyille.
- Automaattinen poisto 5 minuutin kuluttua: Taustajärjestelmä poistaa kaikki väliaikaiset puskurit lopullisesti viiden minuutin kuluessa suorituksesta.
- Täysin ilmainen ilman tunnuksia: Emme pyydä sähköpostiosoitetta tai maksutietoja, mikä takaa täydellisen nimettömyyden.
- Ei mainosvesileimoja: Saamasi XML-koodi on puhdasta ja täyttää viralliset DTD-vaatimukset.
Tutustu muihin tehokkaisiin työkaluihin suoraan selaimessasi käyttämällä AZ2PDF tekninen PDF-työkalupakki -sivustoa.
❓ Usein Kysytyt Kysymykset (FAQ)
Pelkän tekstin vienti hukkaa kaikki tilaan liittyvät tiedot, jolloin sarakkeet ja otsikot sekoittuvat toisiinsa. CSV puolestaan edellyttää säännöllistä taulukkorakennetta. XML tallentaa jokaisen sanan tarkan fyysisen sijainnin rajauslaatikon attribuuteilla (top, left, width, height), jolloin ohjelmat voivat poimia tietoja koordinaattialueiden mukaan visuaalisesta tyylistä riippumatta.
Aiheeseen Liittyvät Artikkelit
Syvenny ammattimaisiin sivujen järjestämisen ja asiakirjojen hallinnan menetelmiin.
Muunna PDF CSV:ksi verkossa ilmaiseksi (siisti taulukon purku)
Opi muuntamaan PDF-taulukot siisteiksi ja jäsennellyiksi CSV-tiedostoiksi verkossa ilmaiseksi. Pura tiliotteet ja laskut ilman sarakevirheitä.
Muunna PDF tekstiksi verkossa ilmaiseksi (puhdas TXT-purku)
Opi purkamaan muotoilematonta puhdasta tekstiä PDF-tiedostoista verkossa ilmaiseksi. Muunna monisarakkeiset sivut siisteiksi UTF-8 TXT-tiedostoiksi tekoälylle.

Miten erottaa tekstiä skannatusta PDF:stä OCR:llä (Ilmainen & Turvallinen)
Opi muuntamaan skannatut paperiasiakirjat ja kuva-PDF:t hakukelpoiseksi ja valittavaksi tekstiksi ilmaisella monikielisellä OCR:llä. Nopeasti, tarkasti ja 100 % yksityisesti selaimessasi.
Muunna PDF HTML-muotoon verkossa ilmaiseksi (puhdas koodi ja tarkka asettelu)
Opi muuntamaan PDF-asiakirjat responsiivisiksi HTML5- ja CSS-verkkosivuiksi verkossa ilmaiseksi. Säilytä fontit, tyylit ja grafiikat ilman vesileimoja.
Miten muuntaa HTML-tiedostot PDF-muotoon verkossa ilman muotoilun katoamista
Opi muuntamaan HTML-tiedostot ja CSS-tyylit tulostusvalmiiksi PDF-asiakirjoiksi ilmaiseksi verkossa. Säilytä tarkat fontit, sivunvaihdot ja asettelu ilman vesileimoja.
Muunna PDF EPUB-muotoon verkossa ilmaiseksi (mukautuva teksti lukulaitteille)
Opi muuntamaan PDF-asiakirjat mukautuviksi EPUB-e-kirjoiksi verkossa ilmaiseksi. Lue sujuvasti Kindlellä, Kobolla ja puhelimella ilman jatkuvaa zoomausta.