PDF in XML online kostenlos umwandeln (Strukturierte Daten mit Koordinaten)
Direkte Antwort & Wichtigste Erkenntnisse
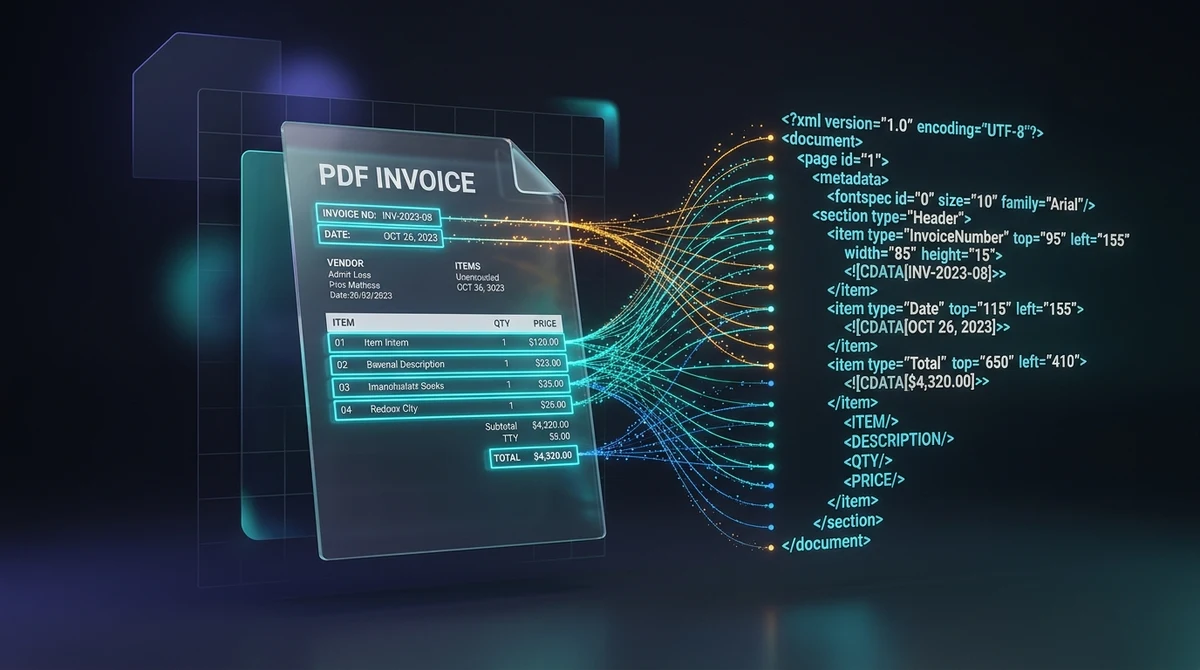
Um eine PDF online kostenlos in XML umzuwandeln, transformieren Sie visuelle Dokumentenlayouts in hierarchische Extensible Markup Language-Tags mit absoluten räumlichen Koordinaten (top, left, width, height) und Schriftspezifikationen. Mit dem AZ2PDF-Konverter können Dateningenieure, Entwickler und Analysten strukturierte maschinenlesbare Textknoten in Sekundenschnelle extrahieren, vollkommen kostenlos und sicher im flüchtigen RAM.
- Räumliche Koordinaten bewahren: Jedes Textelement wird mit exakten Bounding-Box-Attributen (top, left, width, height) und Schriftparametern versehen, was eine präzise koordinatenbasierte Datenextraktion ermöglicht.
- Maschinenlesbare hierarchische Daten: Wandelt statische visuelle Seiten in strukturierte XML-Knoten (page, fontspec, text) um, bereit für die automatisierte Weiterverarbeitung in Python, Node.js und ERP-Systemen.
- Ideal für Rechnungen und automatisierte ETL-Pipelines: Perfekt zum Parsen mehrspaltiger Finanzberichte, B2B-Rechnungen und Steuerformulare, ohne räumliche Zusammenhänge zu verlieren.
- 100 Prozent kostenlos mit sofortiger In-Memory-Verarbeitung: AZ2PDF verarbeitet Ihre Dateien direkt im flüchtigen Server-RAM, ohne Gebühren, ohne Registrierung, ohne Wasserzeichen und mit automatischer Löschung nach 5 Minuten.
Das Problem der Datenextraktion: Warum PDFs Unternehmensdaten einschließen
In modernen Unternehmens-IT-Systemen ist das Portable Document Format (PDF) gleichermaßen unverzichtbar wie problematisch für die Automatisierung. Unter ISO 32000 standardisiert, brilliert das PDF bei der visuellen Darstellung: Es fixiert Wörter, Vektorgrafiken und Seitenränder in einem exakten digitalen Abbild einer gedruckten Seite. Ob auf einem Laptop, einem Smartphone oder einem Laserdrucker, das Dokument sieht absolut identisch aus.
Was das PDF jedoch ideal für das menschliche Auge macht, erschwert die programmgesteuerte Verarbeitung erheblich. Eine PDF-Datei speichert keine semantischen Datenbäume wie eine Datenbanktabelle oder eine Tabellenkalkulation. Sie weiß von Natur aus nicht, was eine Zeile, eine Spalte, eine Zwischensumme oder eine Rechnungsnummer ist. Stattdessen enthält sie primär grafische Zeichenbefehle: Anweisungen wie zeichne diese Zeichenfolge an Koordinate X=150, Y=720.
Wenn Entwickler oder Dateningenieure versuchen, Informationen mit herkömmlichen Text-Dump-Werkzeugen zu extrahieren, treten typische Probleme auf:
- Mehrspaltige Tabellen brechen in einen einzigen, durcheinandergewürfelten Textstrom zusammen.
- Kopfzeilen, Fußzeilen und Seitenzahlen vermischen sich unkontrolliert mit den Datensätzen.
- Räumliche Beziehungen (etwa dass ein Betrag direkt unter einer Steuerbezeichnung steht) gehen vollständig verloren.
Die Konvertierung Ihrer PDF-Dateien in strukturiertes Extensible Markup Language (XML) löst diese Hürde, indem sowohl der Text als auch seine exakte zweidimensionale Geometrie in einer maschinenlesbaren Hierarchie abgebildet werden.
Was ist die PDF-zu-XML-Konvertierung und wie sieht die Ausgabe aus?
Die Konvertierung von PDF in XML erfasst das visuelle Layout eines Dokuments und übersetzt es in ein wohlstrukturiertes XML-Objektmodell gemäß gängigen Document Type Definitions (wie dem Poppler pdf2xml-Standard). Anstatt Text flach zu exportieren, gruppiert die Engine Elemente nach Seiten, ordnet Schrifteigenschaften zu und versieht jedes Textfragment mit Bounding-Box-Koordinaten.
Hier ist ein authentischer Auszug der resultierenden XML-Syntax:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
In dieser strukturierten Ausgabe müssen automatisierte Skripte nicht mehr raten, woher eine Information stammt. Durch Auswerten der Attribute top, left, width und height kann jede Softwareanwendung Daten zielsicher anhand ihrer Position lokalisieren.
Räumliche Koordinaten: Die Attribute top, left, width, height und fontspec verstehen
Die Stärke der XML-Extraktion beruht auf ihren reichhaltigen geometrischen Metadaten. Ein klares Verständnis dieser Attribute erleichtert den Aufbau robuster Datenpipelines:
- Seitenabmessungen (<page>): Das Wurzelelement
<page>definiert die Abmessungen der Arbeitsfläche (z. B.width="918" height="1188"in Standardpunkten) und spannt das Koordinatensystem für alle Kindelemente auf. - Schriftdeklarationen (<fontspec>): Die Engine erfasst alle im Dokument verwendeten Typografien und vergibt eindeutige Bezeichner (
font="0",font="1"). Jedes<fontspec>beschreibt Schriftfamilie, Punktgröße und Hex-Farbcode. Damit können Skripte Hauptüberschriften automatisch von Fußnoten anhand der Schriftgröße unterscheiden. - top- und left-Koordinaten: Das Attribut
topgibt den vertikalen Abstand von der oberen Seitenkante zur Grundlinie des Textes an. Das Attributleftdefiniert den horizontalen Versatz vom linken Seitenrand. - width- und height-Attribute: Diese Werte beschreiben die Abmessungen der Text-Bounding-Box, wodurch sich Spaltenränder berechnen und zeilenbasierte Ausrichtungen feststellen lassen.
- Inline-Typografie-Tags: Formatierungen wie Fett- (
<b>) und Kursivdruck (<i>) bleiben direkt in den Textknoten erhalten, was die Erkennung von Beschriftungsfeldern erleichtert.
Wandeln Sie Dokumente mit dem AZ2PDF PDF-in-XML-Konverter in strukturierte, maschinenlesbare Datensätze um, der Begrenzungskoordinaten und semantische Hierarchien in Standard-XML-Tags überführt.
PDF online in 3 einfachen Schritten in XML konvertieren
Die Konvertierung von PDF in strukturiertes XML lässt sich direkt im Browser ohne Software-Installation durchführen:
Schritt 1: PDF-Dokument hochladen
Ziehen Sie Ihre PDF-Rechnung, Bilanz oder technische Spezifikation per Drag-and-Drop in den Upload-Bereich oder wählen Sie die Datei direkt vom Gerät aus.
Schritt 2: Automatische räumliche Datenanalyse
Unsere leistungsstarke Verarbeitungs-Engine analysiert den PDF-Objektstrom im flüchtigen Server-RAM. Sie berechnet Bounding-Box-Geometrien, erfasst Schriftverzeichnisse und generiert einen validen XML-Baum.
Schritt 3: Strukturiertes XML herunterladen
Klicken Sie auf Download, um Ihre formatierte .xml-Datei zu speichern. Sie können sie sofort in Editoren wie VS Code öffnen oder direkt in Ihre Backend-Datenverarbeitung einspeisen. Wenn Sie stattdessen einfache Tabellen kalkulieren möchten, können Sie auch lernen, wie Sie PDF in CSV online umwandeln, um Daten für Tabellenprogramme aufzubereiten.
Wichtige Anwendungsfälle: Rechnungen, ETL-Pipelines und Document-AI-Training
Die Konvertierung von PDF in XML bildet das Rückgrat für hochvolumige automatisierte Daten-Workflows:
- Automatisierte Rechnungsverarbeitung in der Buchhaltung: Buchhaltungssysteme verarbeiten monatlich tausende Rechnungen verschiedener Lieferanten mit abweichenden Layouts. Reguläre Ausdrücke scheitern hierbei oft. Mit XML können Skripte feste Koordinatenbereiche ansteuern (beispielsweise den oberen rechten Bereich für Rechnungsnummer und Fälligkeitsdatum).
- ETL-Pipelines (Extract, Transform, Load): Data Warehouses binden regelmäßig Quartalsberichte, Versicherungsanträge und behördliche Dokumente ein. XML bietet ein plattformunabhängiges Format, das sich nahtlos in Apache Spark, Airflow und relationale Datenbanken integrieren lässt.
- Training von Document-AI- und LayoutLM-Modellen: Moderne KI-Modelle für Dokumentenanalyse benötigen Text-Tokens und zweidimensionale Bounding-Boxen. XML liefert die idealen räumlichen Trainingsdaten für Dokumentenklassifikatoren.
- Elektronischer Datenaustausch im B2B-Bereich (EDI): ERP-Systeme (SAP, Oracle) erfordern strukturierte Daten für die automatische Auftragsabwicklung. Die Konvertierung von Kunden-PDFs in XML schließt die Lücke zwischen Dokumentenanzeige und ERP-Verarbeitung.
Praktisches Parsen: Python, lxml und XPath auf konvertiertem XML anwenden
Nach dem Herunterladen der XML-Datei ist das Schreiben eines Parsing-Skripts in Python sehr unkompliziert. Mit lxml und XPath lassen sich Textknoten gezielt nach Koordinaten filtern:
from lxml import etree

# XML-Datei einlesen und parsen
tree = etree.parse("rechnung.xml")
root = tree.getroot()

# Alle Textknoten innerhalb bestimmter Koordinatengrenzen abrufen
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Durch die Kombination der Attribute @top, @left und @font erstellen Sie widerstandsfähige Extraktionsregeln, die auch bei leichten Layoutverschiebungen zuverlässig funktionieren.
Fehlerbehebung: Gescannte Dokumente, OCR und Datenschutz im RAM
Beachten Sie die folgenden technischen Hinweise für einen reibungslosen Workflow:
1. Gescannte Dokumente ohne digitalen Text
Wurde ein PDF von einem Scanner oder Faxgerät ohne optische Zeichenerkennung erzeugt, enthält die Datei lediglich Rasterbilder. Da der Konverter native Vektortexte verarbeitet, würde ein reines Bild-PDF ein leeres XML-Gerüst erzeugen. Erfahren Sie hierzu, wie Sie Text aus PDF mit OCR extrahieren, um eine unsichtbare Textebene zu generieren, bevor Sie die Konvertierung starten.
2. Umgang mit großen mehrseitigen Archiven
Bei Dokumenten mit hunderten Seiten können XML-Dateien aufgrund der detaillierten Koordinatenattribute im Megabyte-Bereich anwachsen. Nutzen Sie Standard-Komprimierungsverfahren wie Gzip für die effiziente Archivierung.
3. Vollständige Privatsphäre und In-Memory-Verarbeitung
Steuerunterlagen, Verträge und Bilanzen enthalten geschützte Betriebsgeheimnisse. Unsere Plattform garantiert strenge Sicherheitsvorkehrungen:
- Verarbeitung ausschließlich im RAM: Alle Konvertierungsschritte finden ausschließlich im flüchtigen Arbeitsspeicher des Servers statt. Daten werden zu keinem Zeitpunkt auf permanenten Festplatten gespeichert.
- Automatisches Löschen nach 5 Minuten: Ein Hintergrunddienst bereinigt und vernichtet alle temporären Datenpuffer spätestens fünf Minuten nach Abschluss der Konvertierung.
- Kostenlos ohne Benutzerkonto: Sie müssen weder E-Mail-Adresse noch Zahlungsdaten angeben und bleiben vollständig anonym.
- Keine störenden Werbe-Wasserzeichen: Die erzeugte XML-Datei ist sauber und entspricht den offiziellen DTD-Standards.
Entdecken Sie weitere leistungsfähige Lösungen zur Dokumentenverarbeitung in der AZ2PDF-Suite für technische PDF-Werkzeuge direkt in Ihrem Webbrowser.
❓ Häufig gestellte Fragen (FAQ)
Bei der Umwandlung in reinen Text gehen alle Positionsangaben verloren, sodass Spalten und Kopfzeilen ineinanderlaufen. CSV wiederum setzt starre Tabellenraster voraus. XML speichert über Bounding-Box-Attribute (top, left, width, height) die exakte Position jedes Begriffs auf der Seite, wodurch Daten unabhängig vom visuellen Tabellenstil präzise extrahiert werden können.
Verwandte Artikel zu diesem Thema
Erfahren Sie mehr über professionelle Seitenorganisation und Dokumentenverwaltung.
PDF in CSV online kostenlos umwandeln (saubere Tabellenextraktion)
Erfahren Sie, wie Sie PDF-Tabellen online kostenlos in saubere CSV-Dateien umwandeln. Extrahieren Sie Kontoauszüge und Rechnungen ohne Spaltenfehler und Wasserzeichen.
PDF online in Text umwandeln kostenlos (saubere TXT-Extraktion)
Lernen Sie, wie Sie unformatierten Klartext aus PDF-Dokumenten online kostenlos extrahieren. Mehrspaltige Seiten sauber in UTF-8-TXT-Dateien konvertieren.

Text aus gescanntem PDF mit OCR online extrahieren (Kostenlos & Sicher)
Erfahren Sie, wie Sie gescannte Papierdokumente und Foto-PDFs mit kostenloser mehrsprachiger OCR in durchsuchbaren Text umwandeln. Schnell, präzise und 100 % privat im Browser.
PDF in HTML online kostenlos umwandeln (sauberer Code und exaktes Layout)
Konvertieren Sie PDF-Dokumente kostenlos online in responsive HTML5-Webseiten. Behalten Sie Schriftarten, Formatierungen und Grafiken ohne Wasserzeichen bei.
HTML-Dateien online in PDF umwandeln ohne Formatierungsverlust
Erfahren Sie, wie Sie HTML-Dateien und CSS-Stile kostenlos online in druckfertige PDF-Dokumente konvertieren. Exakte Schriftarten, Seitenumbrüche und Layout ohne Wasserzeichen.
PDF in EPUB online kostenlos umwandeln (Fließtext für E-Reader)
Erfahren Sie, wie Sie PDF-Dokumente online kostenlos in anpassbare EPUB-E-Books umwandeln. Bequemes Lesen auf Kindle, Kobo und Apple Books ohne horizontales Scrollen.