Sådan konverterer du PDF til XML online gratis (strukturerede data med koordinater)
Direkte Svar & Vigtigste Pointer
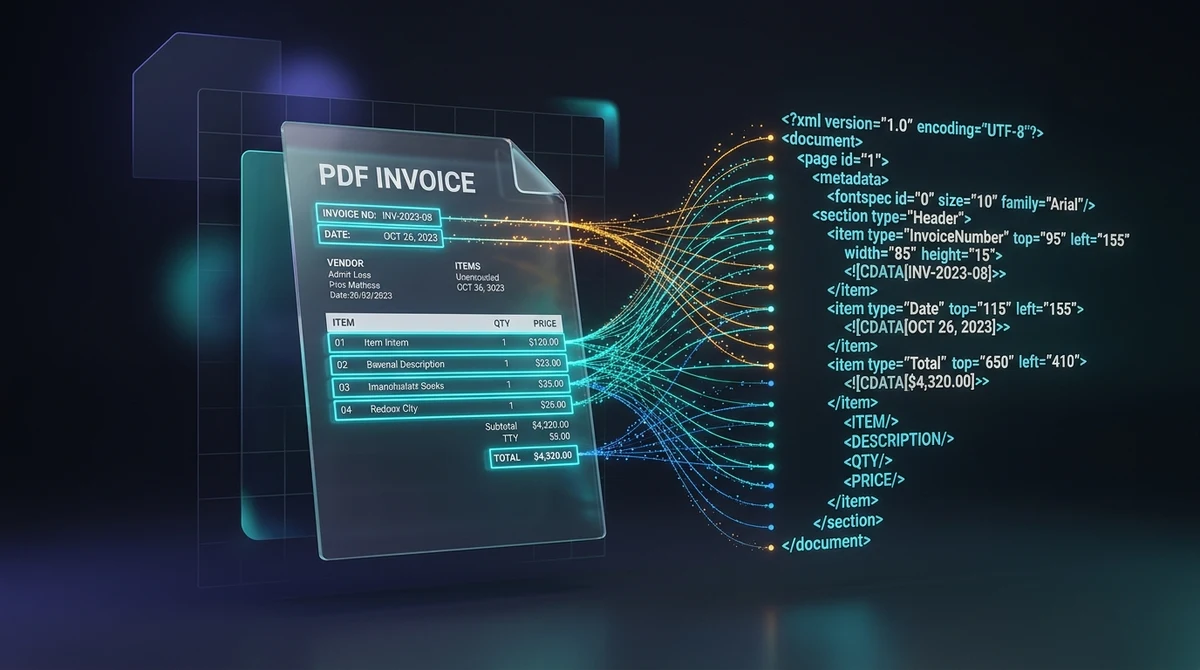
At konvertere PDF til XML online gratis vil sige at omdanne visuelle dokumentlayouts til hierarkiske Extensible Markup Language-tags med absolutte rumlige koordinater (top, left, width, height) og skrifttypeattributter. Med AZ2PDF-konverteren kan datainstruktører og udviklere udtrække maskinlæsbare strukturerede tekstknuder på få sekunder, 100 % gratis og sikkert i serverens flygtige RAM.
- Bevar rumlige koordinater: Hvert tekstelement forsynes med nøjagtige bounding box-attributter (top, left, width, height) og skrifttypeparametre for præcis koordinatbaseret dataudtræk.
- Maskinlæsbare hierarkiske data: Forvandler ubevægelige visuelle sider til strukturerede XML-knuder (page, fontspec, text), der er klar til automatisk indlæsning i Python, Node.js og ERP-systemer.
- Uundværlig til fakturaer og ETL-pipelines: Perfekt til behandling af flerkolonnede finansielle rapporter, B2B-fakturaer og skatteformularer uden tab af rumlige relationer.
- 100 % gratis med direkte in-memory behandling: AZ2PDF behandler dine filer i serverens flyktige RAM uden gebyrer, uden brugerkonto, uden vandmærker og med automatisk sletning efter 5 minutter.
Problemet med dataudtræk: Hvorfor PDF låser forretningsdata inde
I moderne virksomhedsteknologi er Portable Document Format (PDF) både en uundværlig standard for visualisering og en betydelig hindring for dataautomatisering. Standardiseret under ISO 32000 brillerer PDF ved sin visuelle præcision: det fastlåser ord, vektorgrafik og marginer i en nøjagtig digital kopi af en trykt side. Uanset om dokumentet åbnes på en computer, mobil eller sendes til en printer, fremstår det ensartet.
Hvad der imidlertid er perfekt for det menneskelige øje, er notorisk besværligt for computerprogrammer. En PDF-fil gemmer ikke et semantisk datatræ som en databasetabel eller et regneark. Formatet forstår ikke af sig selv hvad en række, kolonne, subtotal eller et fakturanummer er. I stedet indeholder det blot grafiske tegneinstruktioner: eksplicitte ordrer som tegn denne tekststreng ved koordinaterne X=150, Y=720.
Når softwareudviklere eller dataanalytikere forsøger at hente tekst med traditionelle tekstværktøjer, opstår der velkendte fejl:
- Tabeller med flere kolonner klapper sammen til en enkelt uordnet tekststrøm.
- Sidehoveder, sidefødder og sidetal blandes vilkårligt ind mellem datalinjerne.
- Rumlige relationer (som at et beløb befinder sig direkte under en afgiftsmærkning) går fuldstændig tabt.
At konvertere PDF-dokumentet til struktureret Extensible Markup Language (XML) løser dette ved at registrere både tekstindholdet og dets nøjagtige todimensionelle geometri i et maskinlæsbart hierarki.
Hvad er PDF til XML-konvertering, og hvordan ser output ud?
PDF til XML-konvertering analyserer dokumentets visuelle layout og oversætter det til en velstruktureret XML-objektmodel i overensstemmelse med officielle DTD-standarder (såsom Poppler pdf2xml). I stedet for blot at udtrække flad tekst, grupperer motoren elementer side for side, kortlægger skrifttypeegenskaber og mærker hvert tekstfragment med koordinater for dets afgrænsningsboks (bounding box).
Her ses et autentisk eksempel på den genererede XML-syntaks:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Takket være denne overskuelige opbygning behøver programmer ikke længere gætte sig frem til dataindholdet. Ved at aflæse attributterne top, left, width og height kan enhver applikation identificere data ud fra deres fysiske placering på siden.
Rumlige koordinater: Forstå top, left, width, height og fontspec
Styrken ved XML-ekstraktion bunder i de detaljerede geometriske metadata. En grundig forståelse af disse attributter gør det muligt at opbygge stabile dataindsamlingssystemer:
- Sidens dimensioner (<page>): Rodedelen
<page>angiver arkets fysiske dimensioner (f.eks.width="918" height="1188"i standardpunkter) og fastlægger koordinatsystemet for alle underliggende elementer. - Skrifttypedeklarationer (<fontspec>): Parseren indekserer alle anvendte skrifttyper og tildeler unikke id'er (
font="0",font="1"). Hvert<fontspec>angiver skriftfamilie, punktstørrelse og heksadecimal farvekode, så skripts nemt kan skelne overskrifter fra brødtekst og noter. - top- og left-koordinater: Attributten
topangiver den lodrette afstand fra sidens overkant til tekstens grundlinje. Attributtenleftangiver den vandrette afstand fra venstre margin. - Attributterne width og height: Definerer bredden og højden på tekstens afgrænsningsboks, hvilket letter beregningen af kolonnebredder og bekræftelsen af vandret justering.
- Inline typografitags: Fed skrift (
<b>) og kursiv (<i>) bevares direkte i tekstknuderne for hurtig registrering af nøglefelter.
Konverter dokumenter til strukturerede maskinlæsbare datasæt med AZ2PDF PDF til XML-konverteren, som udtrækker koordinater og semantiske hierarkier til XML-tags.
Sådan konverterer du PDF til XML online i 3 enkle trin
Konvertering af PDF-filer til struktureret XML gennemføres på under et minut direkte i webbrowseren:
Trin 1: Upload dit PDF-dokument
Træk og slip fakturaen, regnskabet eller den tekniske rapport til uploadområdet, eller klik for at vælge filen fra din computer eller telefon.
Trin 2: Automatisk beregning af geometriske data
Vores optimerede motor analyserer PDF-objekterne i serverens flygtige RAM. Den lokaliserer tekstafsnit, beregner omkredskoordinater, aflæser skrifttyper og opbygger et gyldigt XML-træ.
Trin 3: Download din strukturerede XML-fil
Klik på Download for at hente din .xml-fil. Den kan straks åbnes i koderedigeringsprogrammer eller indføres i virksomhedens databaser uden krav om oprettelse af brugerkonto. Ønsker du udelukkende at arbejde med simple numeriske oversigter, kan du se hvordan du kan konverter PDF til CSV online for nem import i regneark.
Væsentlige anvendelser: Fakturaer, ETL-pipelines og Document AI-træning
Konvertering fra PDF til XML er en uundværlig brik i automatiseringsarbejdet på tværs af sektorer:
- Automatiseret fakturahåndtering i bogholderiet: Økonomiafdelinger modtager tusindvis af leverandørfakturaer med forskellige opsætninger. Regulære udtryk (regex) svigter ofte ved designændringer. Med XML kan programmer målrette specifikke koordinatzoner (såsom øverste højre hjørne for fakturanummer og betalingsfrist).
- ETL-pipelines (Extract, Transform, Load): Data warehouses modtager løbende kvartalsrapporter og formularer. XML tilbyder et neutralt og ensartet format, der nemt integreres med Apache Spark, Python Airflow og relationsdatabaser.
- Træning af Document AI og LayoutLM: Moderne maskinlæringsmodeller kræver både tekst og todimensionale bounding boxes for at afkode dokumentsider. XML giver det nødvendige koordinatgrundlag.
- Elektronisk dataudveksling (EDI): ERP-systemer (SAP, Oracle) forudsætter strukturerede data for at automatisere ordreoprettelse. At transformere PDF-ordrer til XML bygger bro mellem visuelt materiale og ERP-arbejdsgange.
Praktisk parsing: Brug Python, lxml og XPath på din XML-fil
Når XML-filen er downloadet, er det enkelt at udforme et Python-skript til udtræk af ønskede data. Ved hjælp af lxml-biblioteket og XPath-forespørgsler kan tekstknuder filtreres ud fra koordinater:
from lxml import etree

# Indlæs og parse den dannede XML-fil
tree = etree.parse("faktura.xml")
root = tree.getroot()

# Udfind alle tekstknuder inden for en bestemt geometrisk zone
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Ved at kombinere attributterne @top, @left og @font etablerer du slidstærke udtræksregler, der tåler mindre forskydninger i dokumentlayoutet.
Fejlfinding: Scannede dokumenter, OCR og databeskyttelse i RAM
For at sikre et problemfrit forløb i dine datapipelines bør du følge disse tekniske råd:
1. Scannede dokumenter uden digital tekst
Hvis PDF-filen stammer fra en scanner eller fax uden optisk tegngenkendelse, består den kun af billeder. Da XML-motoren udtrækker native vektortekst, vil en ren billed-PDF returnere et tomt XML-træ. Læs vores guide til hvordan du kan udtræk tekst fra PDF med OCR for at tilføje et digitalt tekstlag før XML-konverteringen.
2. Håndtering af store flersidede dokumenter
Ved dokumenter med flere hundrede sider kan XML-filen vokse betydeligt på grund af de mange koordinatangivelser. Benyt gerne Gzip-komprimering til opbevaring og netværksoverførsel.
3. Fuld fortrolighed og behandling i RAM
Fakturaer, aftaler og regnskaber indeholder forretningskritiske oplysninger. Vores platform håndhæver strenge sikkerhedskrav:
- Behandling udelukkende i RAM: Al parsing og opbygning af XML-strukturen foregår i serverens flygtige arbejdshukommelse og skrives aldrig til permanente harddiske.
- Automatisk destruktion efter 5 minutter: En baggrundstjeneste sletter alle midlertidige data permanent senest 5 minutter efter afslutning.
- Helt gratis uden registrering: Du behøver ikke oplyse e-mailadresse eller betalingskort, hvilket bevarer din fulde anonymitet.
- Ingen vandmærker: XML-filen leveres ren og i fuld overensstemmelse med officielle DTD-krav.
Oplev flere professionelle værktøjer i den AZ2PDF tekniske værktøjskasse til PDF direkte i din browser.
❓ Ofte Stillede Spørgsmål (FAQ)
Ved konvertering til ren tekst forsvinder alle geometriske relationer, så kolonner og overskrifter flyder sammen. CSV kræver regelmæssige rudenet. XML bevarer den nøjagtige fysiske placering af hvert ord via afgrænsningsattributter (top, left, width, height), hvilket gør det muligt for programmer at udtrække data efter koordinatzoner uanset design.
Relaterede Artikler om Emnet
Få mere viden om professionel sideorganisering og dokumenthåndtering.
Konverter PDF til CSV online gratis (ren tabelekstraktion)
Lær hvordan du konverterer PDF-tabeller til rene, strukturerede CSV-filer online gratis. Udtræk kontoudtog og fakturaer uden forskudte kolonner.
Konverter PDF til tekst online gratis (ren TXT-udtrækning)
Lær hvordan du udtrækker uformateret ren tekst fra PDF-dokumenter online gratis. Konverter sider med flere spalter til fejlfri UTF-8 TXT-filer til AI og kode.

Sådan udtrækker du tekst fra scannet PDF med OCR (Gratis & Sikkert)
Lær hvordan du konverterer scannede papirdokumenter og foto-PDF'er til søgbar og markerbar tekst med gratis flersproget OCR. Hurtigt, præcist og 100 % privat i browseren.
Konverter PDF til HTML online gratis (ren kode og nøjagtigt layout)
Lær at konvertere PDF-dokumenter til responsive HTML5- og CSS-websider online helt gratis. Bevar skrifttyper, formatering og grafik uden vandmærker.
Sådan konverteres HTML-filer til PDF online uden tab af formatering
Lær hvordan du konverterer HTML-filer og CSS-stile til printklare PDF-dokumenter gratis online. Bevar præcise skrifttyper, sideskift og layout uden vandmærker.
Konverter PDF til EPUB online gratis (flydende tekst til e-læsere)
Lær hvordan du konverterer PDF-dokumenter til flydende EPUB-e-bøger online gratis. Læs ubesværet på Kindle, Kobo og Apple Books uden konstant zoom.