Jak převést PDF do XML online zdarma (strukturovaná data se souřadnicemi)
Přímá Odpověď a Klíčové Body
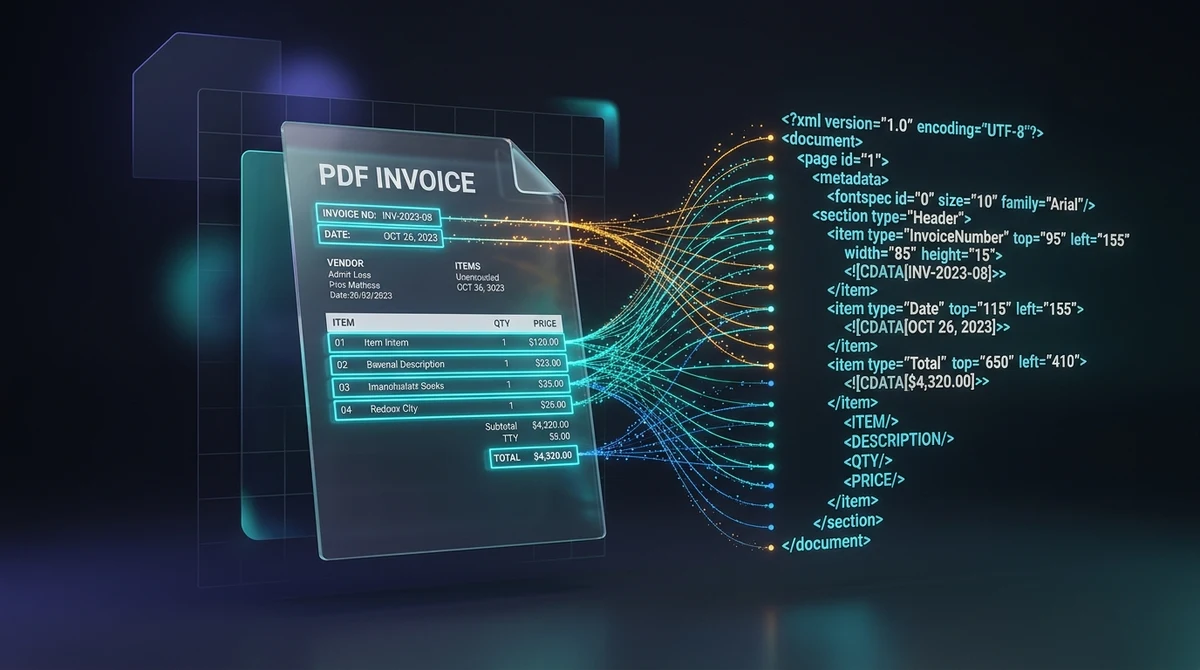
Převod PDF do XML online zdarma znamená transformaci vizuálního rozvržení dokumentu do hierarchických značek Extensible Markup Language obsahujících absolutní prostorové souřadnice (top, left, width, height) a specifikace písem. S převodníkem AZ2PDF mohou datoví inženýři a vývojáři extrahovat strojově čitelné strukturované textové uzly během několika sekund, zcela zdarma a bezpečně v paměti RAM.
- Zachování prostorových souřadnic: Každý textový prvek je opatřen přesnými atributy ohraničujícího rámečku (top, left, width, height) a parametry písma pro přesnou extrakci.
- Strojově čitelná hierarchická data: Převádí nepružné vizuální stránky na strukturované XML uzly (page, fontspec, text) připravené pro automatické zpracování v Pythonu, Node.js a ERP systémech.
- Nezbytné pro faktury a ETL toky: Ideální pro parsování vícesloupcových finančních výkazů, B2B faktur a daňových formulářů bez ztráty prostorových vztahů.
- 100% zdarma s okamžitým zpracováním v RAM: AZ2PDF zpracovává soubory v nestálé operační paměti RAM serveru bez poplatků, bez registrace, bez vodoznaků a s automatickým smazáním do 5 minut.
Problém extrakce dat: Proč PDF uzamyká firemní informace
V moderních podnikových informačních systémech je formát Portable Document Format (PDF) nenahraditelným standardem pro zobrazení, ale zároveň značnou překážkou pro automatizaci. Standardizovaný mezinárodní normou ISO 32000 vyniká PDF vizuální věrností: uzamyká slova, vektorové prvky a okraje do přesné digitální kopie vytištěné stránky. Ať už dokument otevřete na počítači, telefonu nebo pošlete do tiskárny, vypadá naprosto identicky.
To, co dělá PDF ideálním pro lidské čtení, je však zásadní nevýhodou pro počítačové zpracování. Soubor PDF neuchovává sémantický datový strom jako databázová tabulka nebo tabulkový procesor. Soubor sám o sobě nerozumí pojmům jako řádek, sloupec, mezisoučet nebo číslo faktury. Obsahuje pouze nízkoúrovňové grafické kreslicí příkazy: přímé instrukce typu vykresli tento textový řetězec na souřadnicích X=150, Y=720.
Když se vývojáři pokoušejí vytěžit data běžnými textovými extraktory, dochází k závažným chybám:
- Vícesloupcové tabulky se slévají do jediného nepřehledného toku textu.
- Záhlaví, zápatí a čísla stránek se náhodně vměšují mezi řádky obchodních dat.
- Prostorové souvislosti (jako například to, že finanční částka leží přímo pod popiskem daně) se beznadějně ztrácejí.
Převod souboru PDF do strukturovaného formátu Extensible Markup Language (XML) tento problém odstraňuje tím, že zachycuje jak samotný text, tak jeho přesnou dvourozměrnou geometrii ve strojově čitelné hierarchii.
Co je převod PDF do XML a jak vypadá výstupní struktura?
Převod z PDF do XML analyzuje vizuální rozvržení stránky a přetváří jej do uspořádaného objektového modelu XML v souladu s oficiálními specifikacemi DTD (například standardem Poppler pdf2xml). Namísto pouhého výstupu prostého textu motor seskupuje prvky podle stránek, mapuje typografické vlastnosti a každému textovému fragmentu přiřazuje souřadnice ohraničujícího rámečku (bounding box).
Zde je reálná ukázka vygenerované syntaxe XML:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Díky této přehledné struktuře nemusí automatizační skripty odhadovat polohu údajů. Načtením atributů top, left, width a height může jakýkoliv software vyhledat požadovaná data na základě jejich skutečných souřadnic na stránce.
Prostorové souřadnice: Pochopení atributů top, left, width, height a fontspec
Základní výhoda XML extrakce spočívá v podrobných geometrických metadatech. Porozumění těmto vlastnostem vám umožní vytvářet spolehlivé datové toky:
- Hranice plátna stránky (<page>): Kořenový prvek
<page>definuje fyzický rozměr stránky (např.width="918" height="1188"ve standardních bodech), čímž vytváří souřadnicovou síť pro všechny vnořené prvky. - Deklarace písem (<fontspec>): Parser indexuje veškerá písma v souboru a přiřazuje jim jedinečné identifikátory (
font="0",font="1"). Každý tag<fontspec>popisuje rodinu písma, velikost a hex kód barvy, což umožňuje programům automaticky rozlišovat nadpisy od poznámek pod čarou na základě velikosti textu. - Souřadnice top a left: Atribut
topoznačuje svislou vzdálenost od horního okraje stránky k účaří textu. Atributleftudává vodorovnou vzdálenost od levého okraje. - Atributy width a height: Určují šířku a výšku textového bloku, což usnadňuje výpočet šířky sloupců a ověření vodorovného zarovnání na jednom řádku.
- Řádkové stylové značky: Zvýraznění tučným písmem (
<b>) a kurzívou (<i>) zůstává zachováno uvnitř textových uzlů pro snadné rozpoznání klíčových štítků.
Převeďte dokumenty do strukturovaných strojově čitelných datových sad pomocí převodníku PDF do XML od AZ2PDF, který přesně extrahuje souřadnice, typografii i hierarchii do standardních XML značek.
Jak převést PDF do XML online ve 3 jednoduchých krocích
Převod souborů PDF do strukturovaného XML zabere méně než minutu přímo ve vašem webovém prohlížeči:
Krok 1: Nahrajte svůj PDF dokument
Přetáhněte fakturu, finanční zprávu nebo technickou dokumentaci do nahrávacího pole, nebo klikněte a vyberte soubor ze svého zařízení.
Krok 2: Automatické zpracování prostorových dat
Náš výkonný systém analyzuje objekty PDF v nestálé paměti RAM serveru. Mapuje textové bloky, vypočítává souřadnice ohraničení, načítá fonty a vytváří validní XML strom.
Krok 3: Stáhněte si strukturovaný soubor XML
Kliknutím na tlačítko Stáhnout uložte soubor .xml. Můžete jej ihned otevřít v textovém editoru nebo zapojit do firemních systémů bez nutnosti registrace. Pokud potřebujete zpracovávat pouze jednoduché číselné tabulky, zjistěte také, jak převést PDF do CSV online pro přímou práci v tabulkovém procesoru Excel.
Klíčové případy užití: Faktury, ETL toky a trénování Document AI
Transformace PDF do formátu XML představuje páteřní prvek pro rozsáhlou automatizaci v mnoha oblastech:
- Automatické zpracování dodavatelských faktur: Účetní oddělení měsíčně zpracovávají tisíce faktur s odlišnou strukturou. Regulární výrazy (regex) při změně rozvržení často selhávají. S XML mohou skripty cílit na konkrétní zóny souřadnic (například pravý horní roh obsahující číslo faktury a datum splatnosti).
- Firemní ETL toky (Extract, Transform, Load): Datové sklady pravidelně přejímají čtvrtletní výkazy a formuláře. XML poskytuje univerzální formát, který se snadno integruje s Apache Spark, Python Airflow i relačními databázemi.
- Trénování modelů Document AI a LayoutLM: Moderní modely strojového učení vyžadují textové tokeny i 2D ohraničující rámečky k porozumění struktuře stránky. Formát XML nabízí ideální prostorová data pro tyto účely.
- Elektronická výměna dat B2B (EDI): ERP systémy (SAP, Oracle) vyžadují strukturovaná data k automatickému vystavování objednávek. Převod objednávek z PDF do XML překlenuje propast mezi dokumenty a automatizací ERP.
Praktické parsování: Využití Pythonu, lxml a XPath na vygenerovaný XML
Po stažení souboru XML je napsání skriptu pro extrakci v jazyce Python velice snadné. S knihovnou lxml a dotazy XPath můžete textové uzly přesně filtrovat podle souřadnic:
from lxml import etree

# Načtení a parsování vygenerovaného souboru XML
tree = etree.parse("faktura.xml")
root = tree.getroot()

# Získání všech textových uzlů v dané geometrické zóně
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Vhodnou kombinací atributů @top, @left a @font vytvoříte odolná pravidla, která spolehlivě fungují i při drobných posunech v rozvržení dokumentu.
Řešení problémů: Skenované dokumenty, OCR a ochrana soukromí v RAM
Pro zajištění hladkého průběhu automatizovaného zpracování věnujte pozornost těmto technickým zásadám:
1. Skenované dokumenty bez digitální vrstvy textu
Pokud soubor PDF vznikl na optickém skeneru bez rozpoznávání znaků, obsahuje pouze bitmapové obrázky. Jelikož konvertor extrahuje nativní vektorový text, převod čistě obrázkového PDF vytvoří prázdný XML soubor. Podívejte se na náš návod, jak extrahovat text z PDF pomocí OCR, abyste před konverzí do XML vytvořili digitální textovou vrstvu.
2. Práce s objemnými vícestránkovými archivy
U dokumentů s mnoha stovkami stran může soubor XML narůst do značných rozměrů kvůli detailním souřadnicím každého znaku. Pro efektivní ukládání a síťový přenos použijte kompresi Gzip.
3. Maximální ochrana soukromí a zpracování v paměti RAM
Faktury, smlouvy a personální záznamy obsahují důvěrná firemní data. Naše platforma dodržuje přísné bezpečnostní standardy:
- Zpracování výhradně v paměti RAM: Veškerá analýza i sestavení XML struktury probíhá pouze v dočasné paměti RAM serveru a data se nikdy neukládají na pevný disk.
- Automatické odstranění do 5 minut: Proces na pozadí trvale smaže veškeré dočasné vyrovnávací paměti do pěti minut od dokončení.
- Zcela zdarma bez registrace: Nevyžadujeme žádné e-mailové adresy ani platební karty, což garantuje naprostou anonymitu.
- Bez reklamních vodoznaků: Výstupní soubor XML je naprosto čistý a plně odpovídá oficiálním DTD specifikacím.
Vyzkoušejte další spolehlivé nástroje, které nabízí sada technických nástrojů pro PDF od AZ2PDF, přímo ve svém prohlížeči.
❓ Často Kladené Dotazy (FAQ)
Při převodu do prostého textu se ztratí veškeré prostorové uspořádání, takže se sloupce a záhlaví slijí do nepřehledného celku. CSV vyžaduje striktní mřížku tabulky. Formát XML uchovává přesné fyzické umístění každého slova na stránce pomocí atributů ohraničujícího rámečku (top, left, width, height), což programům umožňuje extrahovat data podle souřadnic bez ohledu na vizuální styl tabulky.
Související Články k Tématu
Zjistěte více o profesionální organizaci stránek a správě dokumentů.
Jak převést PDF do CSV online zdarma (čistá extrakce tabulek)
Naučte se převádět tabulky z PDF do čistých CSV souborů online zdarma. Extrahujte bankovní výpisy a faktury bez posunutých sloupců a vodoznaků.
Jak převést PDF do textu online zdarma (čistá TXT extrakce)
Naučte se zdarma extrahovat čistý text bez formátování z dokumentů PDF online. Převeďte vícesloupcové stránky do souborů TXT v UTF-8 pro AI a skripty.

Jak extrahovat text ze skenovaného PDF pomocí OCR (Zdarma a Bezpečně)
Naučte se převádět naskenované papírové dokumenty a fotografické PDF soubory na prohledávatelný a upravitelný text pomocí bezplatného vícejazyčného OCR. Rychle, přesně a 100% soukromě ve vašem prohlížeči.
Jak převést PDF do HTML online zdarma (čistý kód a přesné rozvržení)
Naučte se převádět dokumenty PDF do responzivních webových stránek HTML5 a CSS online a zdarma. Zachovejte písma, styly a grafiku bez vodoznaků.
Jak převést soubor HTML do PDF online bez ztráty formátování
Naučte se zdarma převádět soubory HTML a CSS styly do tiskových PDF dokumentů online. Zachovejte přesná písma, konce stránek i rozvržení bez vodoznaků.
Jak převést PDF do EPUB online zdarma (přizpůsobitelný text pro čtečky)
Naučte se převést dokumenty PDF do přizpůsobitelných e-knih EPUB online zdarma. Čtěte pohodlně na čtečkách Kindle, Kobo i telefonech bez únavného zvětšování.