如何在线免费将PDF转换为XML(带精确坐标的结构化数据)
核心解答与重点摘要
在线免费将PDF转换为XML,是指将文档的视觉呈现布局转换为包含绝对空间坐标(top、left、width、height)和字体属性的分层可扩展标记语言(XML)标签。借助AZ2PDF转换器,数据工程师与开发人员可在数秒内提取机器可读的结构化文本节点,完全免安装、零费用并在易失性内存中安全运行。
- 保留空间几何坐标:每个文本元素均被赋予精确的边界框属性(top、left、width、height)及字体参数,实现基于坐标的精准数据提取。
- 机器可读的层次化数据:将刚性视觉页面重构为标准XML节点(page、fontspec、text),无缝接入Python、Node.js及ERP企业自动化系统。
- 发票解析与ETL流程首选:完美适用于多栏财务报表、B2B电子发票和税务表格的结构化提取,完整保留空间对齐关系。
- 100%免费且内存即时处理:AZ2PDF全程在服务器易失性内存中运行,无需注册、无水印、不收取任何费用,并在5分钟内自动彻底销毁。
数据提取难题:为什么PDF会锁死企业业务信息
在现代企业信息化架构中,便携式文档格式(PDF)既是不可替代的视觉标准,也是自动化流程中最令人头疼的数据壁垒。依据ISO 32000国际标准构建的PDF专为终极视觉呈现而生:它将文字、矢量图形和版面边距严格锁定在物理打印页面的数字孪生中。无论在个人电脑、手机还是激光打印机上,呈现效果都绝对一致。
然而,这种适合人类肉眼阅读的排版特性,却给计算机程序自动化带来了巨大困难。PDF文件内部并不像数据库表或Excel工作簿那样保存语义数据树。它本身根本不理解什么是“行”、“列”、“小计”或“发票号码”,它存储的本质上是一系列底层图形绘制指令:例如在坐标(X=150, Y=720)处绘制指定字符文本。
当软件工程师尝试使用常规文本提取工具读取PDF内容时,往往会出现严重故障:
- 多栏排版的财务报表坍缩为单一行流,文本顺序完全错乱。
- 页眉、页脚和页码随机插在业务数据行之间。
- 空间层面的相对位置关系(例如金额正好对齐在特定税目名称正下方)荡然无存。
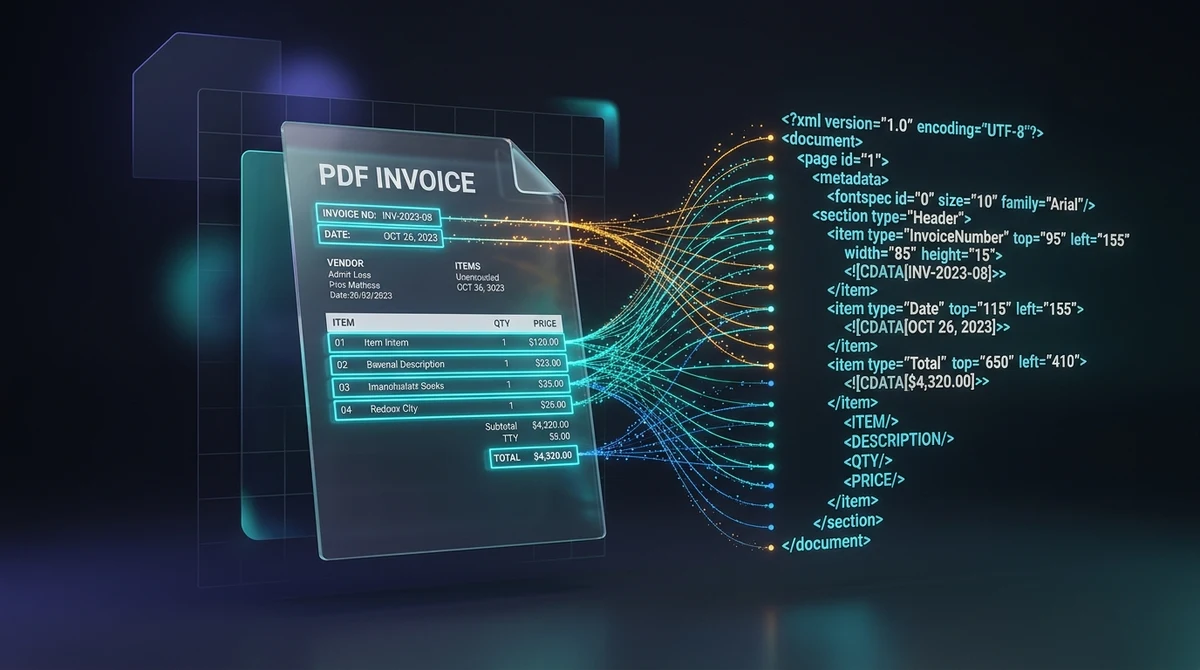
将PDF转换为结构化的可扩展标记语言(XML)能够完美解决这一技术瓶颈,它在机器可读的树状层级中同时捕获了文本内容及其在页面上的绝对二维坐标几何。
什么是PDF转XML?转换后的数据结构具有哪些特点
PDF转XML技术通过分析页面的视觉布局,将其转译为严格遵循文档类型定义(例如Poppler pdf2xml规范)的标准XML对象模型。与简单导出平铺文本不同,转换引擎会按页面归类元素,映射字体属性字典,并为每一个文本节点附带边界框(Bounding Box)空间坐标。
以下是生成的标准XML代码片段示例:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>依托于如此规范的层次化输出,自动化程序无需再盲目猜测文本位置。通过读取top、left、width和height属性,任何业务系统都可以基于页面上的精确坐标直接定位并抽取所需数值。
空间几何坐标:详解top、left、width、height与fontspec属性
XML结构提取的精髓在于丰富的几何元数据。理解这些属性有助于构建高稳定性的自动化数据管道:
- 页面画布边界(<page>):根元素
<page>指定物理画布的真实尺寸(例如以标准磅为单位的width="918" height="1188"),为内部子节点确立统一的坐标系。 - 字体字典声明(<fontspec>):解析器索引文档中出现的所有字体,并分配唯一编号(
font="0"、font="1")。每条<fontspec>均标明字体族、字号和十六进制颜色代码,便于程序依据字号自动区分大标题和脚注。 - top与left空间坐标:
top属性代表文字基线距离页面顶部边缘的垂直间距,left属性代表文字起始位置距离左侧边距的水平偏移。 - width与height尺寸:明确标注文字块边界框的宽度与高度,有助于计算表格列宽边界以及判定文字是否处于同一水平基线。
- 行内富文本标记:粗体(
<b>)与斜体(<i>)排版直接嵌入文本节点内,便于规则快速捕获重点字段。
使用 AZ2PDF PDF转XML转换器 将文档转化为机器可读的结构化数据集,精准解析文本边界坐标与语义层级并输出标准XML标签。
在线将PDF转换为XML的简单3步骤
无需安装任何繁重的桌面端软件,只需在浏览器中即可轻松完成转换:
步骤 1:上传您的PDF文档
将需要转换的发票、财务报表或技术文档拖放到上传区域,或从本地设备直接选取文件。
步骤 2:引擎在内存中自动解析空间坐标
高性能处理系统直接在服务器易失性内存中剖析PDF对象流。系统精准计算文字边界坐标,关联字体属性,生成符合工业标准的XML树。
步骤 3:下载结构化XML文件
点击下载按钮将生成的.xml文件保存到本地。您可以立即在VS Code等编辑器中打开,或直接导入后端数据管道。若您的源文件仅包含平面数字表格,亦可参考在线免费将PDF转换为CSV以快速导入Excel进行分析。
核心高价值应用:电子发票、ETL管道与Document AI训练
PDF转XML是企业级大规模数据自动化作业的关键基石:
- 财务应付账款与发票自动识别:企业财务月度处理成千上万来自不同供应商的发票,格式千差万别。传统正则表达式极易失效。利用XML,程序可锁定特定坐标区域(例如右上角包含发票号和开票日期的固定方框)进行高可靠性抓取。
- 数仓ETL(抽取、转换、加载)管道:大型数据仓库定期汇总季度财报与统计报告。XML格式具备跨平台通用性,能够顺畅接入Apache Spark、Airflow及关系型数据库。
- Document AI与LayoutLM深度学习模型训练:现代基于版面感知的文档大模型需同时接收文本标记与2D边界框坐标。转换后的XML为训练文档分类器与信息抽取模型提供了现成的数据源。
- 企业B2B电子数据交换(EDI):ERP系统(SAP、Oracle)自动创建采购订单要求输入结构化文件。将PDF采购订单转为XML可完美打通视觉账单与业务管理系统之间的自动化断层。
实战解析:使用Python、lxml与XPath提取目标XML节点
获取XML文件后,编写Python脚本提取特定字段非常便捷。利用lxml库和XPath语法,可直接根据空间坐标条件检索目标节点:
from lxml import etree

# 解析生成的XML文档
tree = etree.parse("invoice.xml")
root = tree.getroot()

# 提取位于特定坐标几何区间内的所有文本元素
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
print(f"{coordinates}: {text_node.text}")综合运用@top、@left和@font属性,即便版面布局因打印微调出现少许位移,提取规则依旧稳健运行。
疑难解答:扫描件处理、OCR文字层与内存安全机制
为保障自动化流程顺利实施,建议关注以下技术细节:
1. 无内嵌数字文字层的扫描件PDF
若PDF由扫描仪或传真机生成且未经过光学字符识别,文件内部仅为纯位图图片。由于XML引擎负责提取原生矢量文本流,直接转换纯图片PDF将得到空XML。遇到此类文档,请先查看使用OCR从PDF中提取文本生成透明文字层,再进行XML转换。
2. 超长多页大文档的体积控制
处理上百页的大型文档时,详尽的坐标描述可能导致XML文件体积显著增大。存储或网络传输时建议使用Gzip算法进行高效压缩。
3. 严格的易失性内存安全保障
财务发票、商用合同与雇佣档案属于核心商业秘密。本平台恪守严格的安全准则:
- 易失性RAM瞬时运算:解析与XML重组全部在服务器内存中进行,绝不写入永久物理磁盘。
- 5分钟自动销毁程序:后台守护进程实时运行,任务完成后5分钟内彻底清理一切内存缓存。
- 无需注册即可免费使用:无需提供电子邮箱或支付账户,保障绝对匿名。
- 绝无广告水印:生成的XML代码纯净合规,完全符合官方DTD规范。
欢迎在您的浏览器中直接体验安全高效的AZ2PDF专业技术文档工具箱。
❓ 常见问题解答 (FAQ)
纯文本导出完全丢弃了空间坐标,会导致多列表格与标头相互挤压混乱。CSV要求规则的行列网格。而XML通过边界框属性(top、left、width、height)保留了页面上每个词的物理绝对位置,使自动化程序能依据空间坐标精准定位抓取,不受视觉排版样式干扰。
同主题精选文章
进一步探索专业的 PDF 页面管理与文档组织技巧。
如何在线免费将PDF转换为CSV(干净精准提取表格数据)
了解如何在线免费将PDF表格转换为结构工整的CSV文件。无错列、无乱码、无水印轻松提取银行账单与发票流水。
在线免费将PDF转换为文本(干净的TXT纯文本提取)
学习如何在线免费从PDF文档中提取无格式纯文本。将多栏排版页面转换为干净的UTF-8 TXT文件,适用于AI分析和程序处理。

如何使用OCR从扫描件PDF中提取文字(免费且安全)
了解如何通过免费的多语言OCR将扫描纸质文件和图片PDF转换为可搜索、可选中的文本。快速、精准且100%在浏览器内保护隐私。
如何在现免费将PDF转换为HTML(保留精确布局与干净代码)
学习如何在线免费将PDF文档转换为响应式HTML5和CSS网页。完整保留字体、排版格式与矢量图形,没有任何水印。
如何在不丢失格式的情况下在线将 HTML 文件转换为 PDF
了解如何免费在线将 HTML 文件和 CSS 样式转换为可直接打印的 PDF 文档。精准保留字体、分页与排版布局,无任何水印。
如何在线免费将PDF转换为EPUB(电子书阅读器自适应流式排版)
了解如何在线免费将固定排版的PDF文档转换为流式EPUB电子书。在Kindle、Kobo和手机上舒适阅读,告别频繁缩放与横向拖动疲劳。