如何在线免费将PDF转换为CSV(干净精准提取表格数据)
核心解答与重点摘要
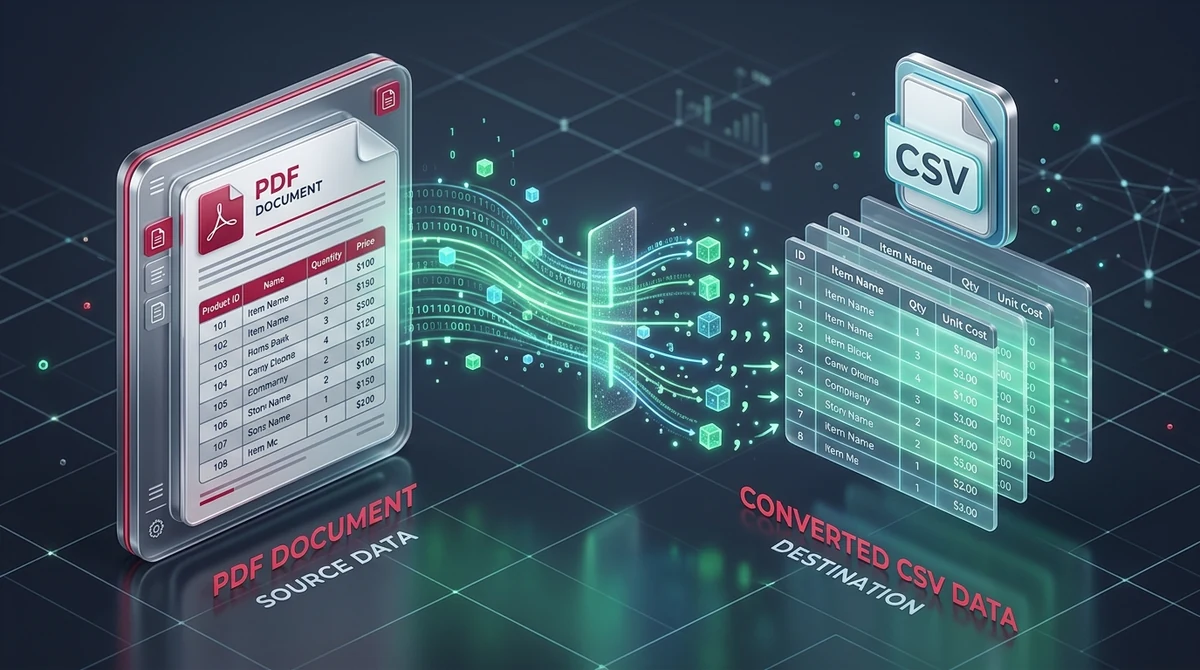
要在线免费将PDF表格转换为格式规整的CSV文件,只需将文档上传至AZ2PDF的PDF转CSV转换工具。该提取引擎综合运用网格识别(Lattice)与文本流解析(Stream)算法,精确锁定表格边框,将分散字符规整归入对应列,遵循RFC 4180规范处理分隔符转义,并全程在服务器临时内存中执行,杜绝数据留存。
- 精准对齐表格列:基于几何坐标分析算法,将文本准确聚类为行与列,彻底杜绝单元格错位与意外合并。
- 无缝对接数据库与代码:输出符合RFC 4180规范及UTF-8编码的CSV文件,可直接用于SQL数据库导入、Python pandas脚本及财务系统。
- 100%免费且无水印:支持无限次表格提取,无隐藏收费陷阱,免注册账号,导出的数据纯净无广告标记。
- 严苛的财务隐私防护:文件仅在易失性内存(RAM)中运算,后台自动化进程将在任务完成后5分钟内彻底销毁所有临时会话数据。
为什么直接从PDF复制表格总会导致格式错乱
凡是处理过月度财务报表、审核过差旅发票或整理过仓储库存清单的人,都遭遇过这样的糟糕体验:打开一份排版美观的PDF报表,用鼠标框选表格内容并复制,粘贴到Excel或记事本中后,原本工整的行列结构荡然无存,变成了一堆杂乱无章的文本。
原本属于4个独立列的数据被强行挤进同一个单元格,商品单价混入地址文本,账单日期被生硬截断,多行长描述甚至会制造出一连串幽灵般的空行。如果试图将这些文本通过自动化脚本写入SQL数据库,系统会因为字段数量不匹配而频繁报错。
这种困局的根源在于国际标准 ISO 32000 对 Portable Document Format (PDF) 的底层定义。与通过明确行列标签构建层级结构的电子表格或HTML网页截然不同,PDF在本质上是一个2D矢量绘图指令画布。PDF规范中根本不存在“表格单元格”的原生概念,文字是以绝对二维几何坐标(以页面左下角为原点、1/72英寸为单位的排版点)分散绘制在页面上的。
想要瞬间将账簿流水与表格信息还原为规整数据,可直接使用 AZ2PDF PDF转CSV在线工具。它能智能定位单元格分隔边界,输出符合RFC工业标准的纯净CSV数据。
空间表格提取算法的底层实现原理
将基于坐标排布的文本碎片重新组装为严谨的二维表格,是文档工程领域最具挑战性的技术之一。为了生成符合 RFC 4180 国际标准的高质量 Comma-Separated Values (CSV),专业的转换引擎设计了多级计算流水线。
1. 字符边界框与绝对坐标抽取
解析器首先深入遍历每个页面的底层内容流,抓取每个文字字符的水平坐标(x)、垂直坐标(y)、宽度、高度以及字体轮廓度量,将整个页面重构成一个多维几何点云。
2. 针对有框线表格的网格几何判定(Lattice)
当文档包含清晰的水平横线与垂直竖线时,网格检测算法会扫描矢量路径对象,通过计算横线与竖线的几何交点,精确还原出每一个单元格的矩形轮廓。
3. 针对无框线表格的文本流密度分析(Stream)
许多企业财务年报采用无边框设计,仅靠空白间隙区分列。文本流算法计算页面全高的纵向空白带,当空白宽度超过设定容差阈值时,自动将其判定为天然的列分隔边界。
4. RFC 4180规范化序列化输出
行列矩阵确认完毕后,系统按照国际规范组装CSV:使用半角逗号分隔字段,对包含换行或特殊字符的单元格添加双引号包裹,转义内部引号,并以标准CRLF换行符结尾。
在线将PDF转换为CSV的3个简单步骤
无需安装庞大的本地软件,也不用手动重复录入,只需简单三步即可完成数据转换:
- 上传PDF文档: 将包含表格数据的PDF拖拽放置到AZ2PDF安全的文件上传区域。
- 智能解析表格结构: 空间算法引擎瞬时完成矢量坐标扫描并精准构架行列矩阵。
- 下载CSV文件: 点击下载按钮,即刻获取UTF-8编码的标准CSV文件,直接导入表格软件或数据库。
在哪些业务场景下应优先选择CSV而非Excel工作簿
尽管两者都能承载表格信息,但在系统自动化及大规模数据交互中,CSV格式具备不可替代的优势:
1. 极致轻量与全平台通用
CSV为不带冗余装饰样式的纯文本格式,文件体积通常比同等内容的XLSX精简80%至95%。它无需任何商业软件授权,即可在任意操作系统、服务器以及Linux终端上原生解析。
2. 数据库超快速批量吞吐
对于PostgreSQL、MySQL等关系型数据库或Snowflake、BigQuery等云端数据仓库,CSV是事实上的标准导入格式。执行SQL COPY语句可以在数秒内吞吐数百万条记录。
3. 数据工程与脚本自动化的高效适配
在Python环境下,使用pandas库仅需一行代码即可将CSV读入DataFrame。此外,开发者可以在终端使用grep、awk等基础命令快速完成数据过滤与排查。
如果业务人员需要格式完备、带表头样式和公式的工作簿用于展示,也可以导出保留公式的格式化工作簿以供正式汇报。
攻克复杂版面:多页账单、发票流水与无框线表格
企业实际业务文档往往结构繁琐,需要专门的解析机制提供保障。
跨越多页的长表格无缝衔接
银行对账单通常长达数十页。解析引擎能在换页节点动态比对表头定义,防止跨页导致的列位置左右漂移。
单元格内容换行多行排版
物流与贸易清单中,单件货物的描述常会换行成3至4行文字。智能算法将换行文字精准归入同一数据项,确保生成的CSV中每件商品严格占据单行。
扫描纸质扫描件与拍摄图片
若PDF由复印机扫描而来,其本质是一张平整的位图,缺乏文字图元。遇到此类文件,必须先经过OCR光学字符识别处理生成可搜索文本层,再执行CSV转换。
数据安全合规:防范CSV公式注入攻击与字符乱码
直接将未经清洗的PDF数据导入表格应用存在潜藏的安全威胁与数据损坏隐患。
防范CSV公式注入攻击(DDE Attack)
若单元格文本以等号(=)、加号(+)、减号(-)或@符号起始,Excel打开时可能会将其作为宏命令或系统指令直接执行。转换器会自动在该字段前添加单引号或双引号,强制程序将其作为纯文本渲染。
国际多币种符号与UTF-8全字符集兼容
账目中常含有人民币(¥)、美元($)、欧元(€)等符号以及各种文字字符。AZ2PDF全程采用标准UTF-8编码导出,彻底终结字符乱码(Mojibake)问题。
隐私至上:为什么全内存处理能保护敏感财务流水
PDF表格往往汇聚了机构最核心的商业秘密:企业账户流水、员工薪酬清单或战略采购底价。上传至保存用户文档的第三方云盘会带来严重的合规风险。
AZ2PDF深度采用易失性内存驻留(In-Memory Ephemeral Storage)架构。所有解析计算均在RAM中完成,文件不写入物理硬盘。在任务完成后5分钟内,后台守护进程将彻底清除所有会话碎片。
协同工作流:提取后的数据清洗、合并与多维转换
数据提取往往是文档管理流程的一环。合理搭配专业工具能让办公效率倍增:
多月份账单合并: 可将全年12个月度的PDF对账单预先合并为一份文档,再批量导出一份连续的年度CSV流水。
关键页面定向截取: 针对厚达数百页的企业年报,可预先截取核心财务报表所在页码,从而显著压缩解析耗时。
正文与数据剥离管理: 将表格旁冗长的法律附注文本剥离为纯文本,保持核心CSV数据表的极致纯粹。
借助 AZ2PDF 文档处理套件 的全流程支持,在确保核心财务机密绝对安全的前提下,大幅提升表格数据处理效率。
❓ 常见问题解答 (FAQ)
CSV是一种轻巧的纯文本格式,严格遵循RFC 4180规范用逗号分隔字段,极易导入SQL数据库或由Python程序批量调用。而Excel(XLSX)则包含样式、颜色、多工作表及公式等丰富表现层。若您仅需提取纯数据进行计算分析或存储,CSV速度更快、体积更小且通用性更高。
同主题精选文章
进一步探索专业的 PDF 页面管理与文档组织技巧。
如何在线将网页URL转换为PDF(免费整页截图保存)
学习如何免费在线将网页URL转换为高清PDF文档。采用1440px横向视图,完整保留CSS背景、图表和字体,无水印且无需安装软件。
如何让PDF看起来像扫描件(免打印机在线复古纸质效果)
无需打印机或扫描仪,在线免费将数字PDF转换成逼真的纸质扫描件效果。自动添加微小机械倾斜、真实纸张纤维噪点与黑白复印机灰度对比度。
如何在线将彩色PDF转换为黑白灰度(免费压缩70%体积)
免费在线将彩色PDF文档转换为单色灰度(DeviceGray)格式。大幅节省打印机墨水,减少高达70%的文件体积,文本依然清晰锐利。

如何保持原始格式将 PDF 转换为 Word(免费且可编辑)
了解如何将 PDF 文档转换为完全可编辑的 Word DOCX 文件,避免字体缺失、表格错位或文本框困扰。快速且 100% 保护隐私。
如何将 Word 转换为 PDF 且不丢失排版格式(免费且安全)
学习如何将 Word DOCX 和 DOC 文档转换为标准化 PDF,锁定字体、保留页边距、杜绝排版错位。快捷、免费且 100% 保护隐私。
如何在线将PDF转换为高清JPG图片(免费、300 DPI超清无损)
学习如何免费在线将PDF页面转换为300 DPI高清JPG图片。画质清晰细腻,支持自动打包ZIP一键下载,内存临时处理全面保护数据隐私。