Cách giải nén luồng nhị phân PDF trực tuyến miễn phí (Bóc tách mã nguồn và FlateDecode)
Câu Trả Lời Trực Tiếp & Điểm Cốt Lõi
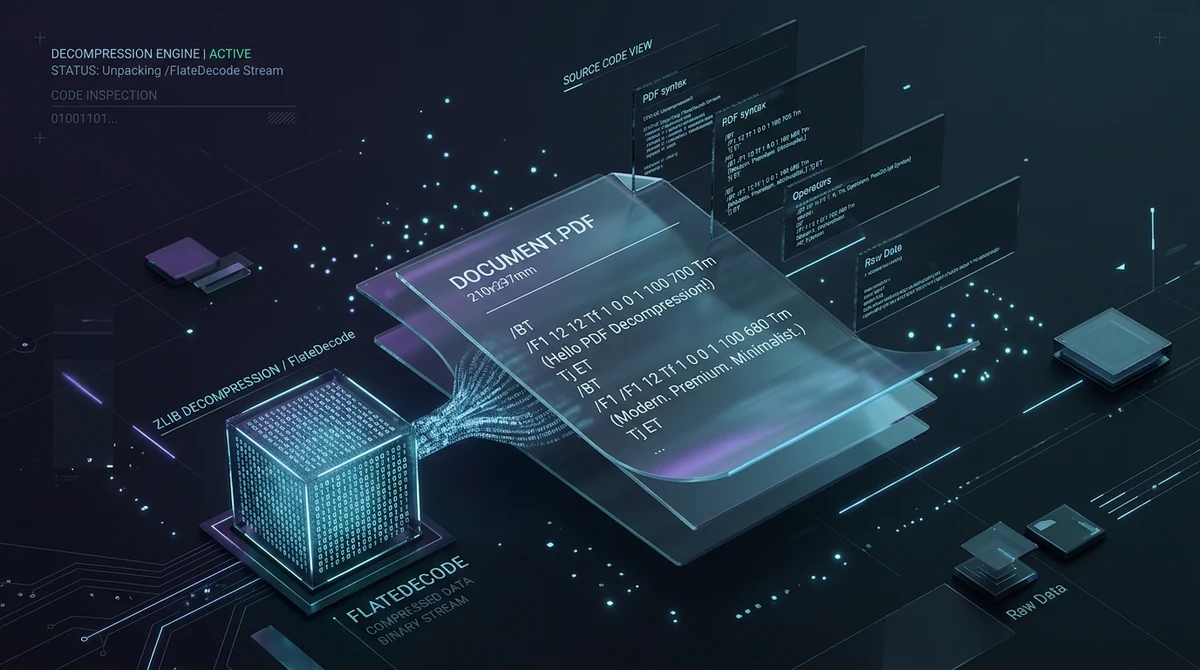
Để giải nén luồng PDF trực tuyến miễn phí, bạn mở rộng các luồng nhị phân nén nội bộ (như FlateDecode, LZWDecode, ASCII85Decode) thành văn bản thuần chứa cú pháp PostScript và PDF theo chuẩn ISO 32000. Tiện ích bóc tách luồng dữ liệu AZ2PDF giúp lập trình viên, chuyên gia bảo mật và kỹ thuật viên in ấn kiểm tra toàn bộ toán tử nội dung chỉ trong vài giây mà không cần cài đặt phần mềm.
- Bóc tách mã nguồn PDF thô: Chuyển đổi các khối nhị phân FlateDecode thành các toán tử đồ họa dễ đọc (BT, ET, Tf, Tj, cm, re, f) dưới dạng văn bản thuần.
- Công cụ đắc lực cho lập trình viên: Chuẩn đoán nhanh các lỗi hiển thị, xung đột font chữ, sai lệch hộp giới hạn (Bounding Box) và lỗi đường cong vector.
- Phục vụ điều tra số và bảo mật: Kiểm tra các đoạn mã JavaScript ẩn và cấu trúc bất thường được che giấu sau các tầng nén Deflate.
- Miễn phí và xử lý bảo mật trong RAM: Dữ liệu được giải nén trực tiếp trong bộ nhớ máy chủ tạm thời, không lưu trữ vĩnh viễn và tự hủy sau 5 phút.
Mã nguồn ẩn bên trong PDF: Vì sao các luồng dữ liệu luôn bị nén mặc định
Đối với phần lớn người dùng máy tính thông thường, tài liệu PDF giống như một tờ giấy kỹ thuật số cố định. Bạn chỉ cần mở tệp lên và trình đọc sẽ hiển thị các đoạn văn bản ngay ngắn, hình ảnh sắc nét và biểu bảng gọn gàng. Tuy nhiên, đằng sau lớp giao diện trực quan đó là một hệ thống ngôn ngữ lập trình hướng đối tượng phức tạp, được quy định chặt chẽ bởi tiêu chuẩn quốc tế ISO 32000.
Một tệp PDF tiêu chuẩn được cấu thành từ các đối tượng độc lập: từ điển (dictionaries), mảng (arrays), số nguyên, chuỗi văn bản và đặc biệt là luồng dữ liệu (streams). Luồng nhị phân là nơi lưu trữ dung lượng lớn nhất của tài liệu, bao gồm chuỗi lệnh vẽ trang, tọa độ đường cong vector, tập lệnh phông chữ nhúng và dữ liệu mô tả cấu trúc.
Nếu toàn bộ luồng nội dung trang được ghi lại bằng ký tự văn bản thuần ASCII, kích thước file PDF sẽ phình to gấp nhiều lần. Một tài liệu báo cáo chỉ khoảng hai mươi trang chứa hàng nghìn tọa độ lặp lại có thể dễ dàng chạm mốc hàng chục megabyte. Nhằm giải quyết vấn đề này, các bộ sinh mã PDF (như Adobe Acrobat, Ghostscript, iText hay Chromium) luôn nén các luồng nội dung bằng thuật toán nén toán học. Dù giúp tài liệu gọn nhẹ, việc này lại biến toàn bộ mã nguồn nội bộ thành những khối nhị phân mã hóa mà mắt người không thể đọc hiểu trực tiếp.
Để kiểm tra chuyên sâu cấu trúc, sửa lỗi hiển thị hoặc trích xuất dữ liệu gốc, các chuyên gia cần công cụ giải nén PDF AZ2PDF để đưa các luồng nhị phân trở về dạng văn bản thuần mà không làm sai lệch cấu trúc đối tượng.
Bộ lọc FlateDecode là gì và tại sao mã PDF thô trông giống chuỗi ký tự rác?
Khi bạn mở một tệp PDF thông thường bằng trình soạn thảo văn bản hoặc mã nguồn như Visual Studio Code, Sublime Text hay Notepad++, bạn có thể nhìn thấy dòng mở đầu tài liệu như %PDF-1.7 cùng các từ khóa cấu trúc cơ bản như /Type /Catalog hoặc /Pages. Thế nhưng, ngay khi con trỏ chuột chạm vào phần nội dung luồng dữ liệu, văn bản lập tức biến thành một ma trận ký tự kỳ dị, biểu tượng hỗn loạn và các dấu hỏi chấm vô nghĩa.
Dưới đây là một ví dụ điển hình về từ điển đối tượng ngay trước khối luồng nhị phân:
5 0 obj
<<
  /Length 1420
  /Filter /FlateDecode
>>
stream
xœí[msÛ8 … [dữ liệu nhị phân không thể đọc được] …
endstream
endobj
Thẻ quy định khối dữ liệu này chính là /Filter /FlateDecode. Trong đặc tả kỹ thuật PDF, FlateDecode đại diện cho thuật toán nén tiêu chuẩn công nghiệp zlib/deflate (được định nghĩa trong chuẩn RFC 1950 và RFC 1951). Deflate rà soát luồng byte để tìm các chuỗi ký tự lặp lại, thay thế chúng bằng con trỏ bit ngược dòng và áp dụng mã hóa Huffman để co nhỏ dữ liệu xuống mức tối thiểu.
Do các byte đã được gói gọn ở cấp độ bit, các trình soạn thảo mã nguồn không thể biên dịch chúng sang bảng mã ký tự UTF-8 hay ASCII thông thường. Khi mở tài liệu trên trình đọc PDF, ứng dụng sẽ tự động giải nén luồng dữ liệu trong bộ nhớ tạm thời để vẽ trang. Nhưng đối với kỹ sư phần mềm và chuyên viên điều tra số liệu, bức tường nhị phân này ngăn chặn hoàn toàn khả năng kiểm tra trực tiếp các lệnh thực thi bên dưới.
Ai là người cần giải nén các luồng dữ liệu nội bộ của tệp PDF?
Giải nén luồng PDF không phải là thao tác dành cho việc chia sẻ tài liệu văn phòng thông thường, bởi tệp sau khi giải nén sẽ có dung lượng lớn hơn nhiều. Thay vào đó, đây là tiện ích chẩn đoán mang tính sống còn đối với các chuyên gia kỹ thuật:
- Lập trình viên phát triển hệ thống xuất PDF: Khi bạn xây dựng các ứng dụng tạo tài liệu tự động bằng các thư viện như pdf-lib, ReportLab, FPDF, Puppeteer hoặc Apache PDFBox, các lỗi vẽ trang xuất hiện rất thường xuyên. Chữ bị đè lên nhau, khoảng cách ký tự font bị biến dạng hoặc đường lề cắt xén mất nội dung. Bằng cách giải nén tệp PDF kết quả, bạn có thể mở file trong VS Code để xem chính xác ma trận biến đổi tọa độ (các toán tử
cmvàTm) nhằm xác định chính xác dòng code gây ra lỗi. - Kỹ thuật viên chế bản và xưởng in ấn chuyên nghiệp: In ấn công nghiệp đòi hỏi độ chuẩn xác tuyệt đối về màu sắc và chuẩn font. Kỹ thuật viên giải nén PDF để kiểm tra xem font chữ nhúng có bảng ánh xạ ToUnicode CMap chuẩn hay không, kiểm tra các kênh phân màu CMYK và xác nhận các kênh màu pha (Spot Color) trước khi chạy máy in lớn tốn kém.
- Chuyên gia phân tích an ninh mạng và điều tra số (Forensics): Tin tặc thường nhúng mã độc JavaScript độc hại, các lệnh thực thi ngầm hoặc liên kết lừa đảo bên trong các luồng dữ liệu nén của PDF. Các phần mềm diệt virus đôi khi bị đánh lừa bởi nhiều lớp nén lồng nhau. Việc giải nén toàn bộ cây đối tượng sẽ bộc lộ trực tiếp các khối từ điển
/JavaScript, hành động khởi chạy và cấu trúc bất thường. - Kỹ sư và sinh viên nghiên cứu cấu trúc tài liệu ISO: Đọc hàng nghìn trang tài liệu chuẩn ISO 32000 thường rất trừu tượng. Việc mở một tệp PDF đã được giải nén sạch sẽ giúp người học quan sát trực quan mối tương quan giữa trang, phông chữ, đồ họa và luồng nội dung thực tế.
Nguyên lý giải nén luồng PDF theo đặc tả kỹ thuật ISO 32000
Giải nén một tệp PDF đòi hỏi kỹ thuật phức tạp hơn rất nhiều so với việc dùng phần mềm giải nén file thông thường như WinRAR hay 7-Zip. Tệp PDF không phải là một kho lưu trữ nén đơn thuần, mà là một mạng lưới các đối tượng liên kết chéo qua bảng tham chiếu XRef. Nếu chạy thuật toán giải nén bừa bãi lên toàn bộ file, phần tiêu đề và bảng xref sẽ bị phá hủy ngay lập tức, khiến tài liệu bị hỏng hoàn toàn.
- Lập bản đồ tham chiếu chéo (XRef Mapping): Động cơ xử lý phân tích phần trailer của PDF và nạp toàn bộ bảng tham chiếu chéo (xref table) vào bộ nhớ nhằm xác định vị trí của từng đối tượng gián tiếp (như
1 0 R,2 0 R). - Phát hiện và sàng lọc luồng dữ liệu: Trình phân tích duyệt qua toàn bộ cây đối tượng tài liệu. Khi phát hiện một đối tượng chứa từ điển luồng, hệ thống kiểm tra các khóa bộ lọc nén:
/Filter,/DecodeParms. Các bộ lọc được hỗ trợ bao gồm FlateDecode (zlib), LZWDecode, ASCII85Decode và RunLengthDecode. - Giải nén luồng nhị phân (Payload Inflation): Dữ liệu nhị phân nén được giải mã qua luồng xử lý trong bộ nhớ để tái tạo thành chuỗi byte thô nguyên bản.
- Loại bỏ khóa bộ lọc: Hệ thống xóa bỏ các thuộc tính
/Filtervà/DecodeParmskhỏi từ điển đối tượng, báo hiệu cho trình đọc PDF biết rằng luồng này hiện ở định dạng thô không nén. - Tính toán lại độ dài luồng dữ liệu (/Length): Khi luồng nén nở rộng thành văn bản thuần, giá trị độ dài ban đầu không còn chính xác. Hệ thống tính toán lại số byte thực tế của nội dung mới và cập nhật giá trị số nguyên
/Length. - Tái cấu trúc và lập chỉ mục XRef mới: Toàn bộ tài liệu được tuần tự hóa lại với các tham số uncompressed. Bảng tham chiếu chéo XRef được tái tạo hoàn toàn với các độ dời byte (byte offset) chính xác tuyệt đối, đảm bảo tệp mở trơn tru trên mọi ứng dụng đọc PDF.
3 bước đơn giản để giải nén luồng nhị phân PDF trực tuyến
Trước đây, việc bóc tách mã nguồn PDF thô thường yêu cầu cài đặt tiện ích dòng lệnh phức tạp, thiết lập môi trường biên dịch hoặc viết mã script Python. Với nền tảng trực tuyến, bạn có thể thực hiện công việc này ngay trên trình duyệt web chỉ trong vài giây:
Bước 1: Tải lên tài liệu PDF cần bóc tách mã nguồn
Truy cập tiện ích giải nén luồng PDF. Kéo và thả tệp PDF trực tiếp vào khung tải lên hoặc nhấp để chọn tệp từ máy tính. Công cụ hoạt động mượt mà trên Windows, macOS, Linux, iPhone và Android mà không cần cài đặt thêm bất kỳ tiện ích bổ trợ nào.
Bước 2: Hệ thống tự động giải nén các luồng nội bộ trong RAM
Ngay sau khi tiếp nhận tệp, động cơ xử lý tiến hành phân tích cấu trúc đối tượng trực tiếp trong bộ nhớ RAM tạm thời. Mọi luồng FlateDecode được giải mã thành văn bản rõ ràng, các bộ lọc nén được gỡ bỏ và bảng byte offset được tính toán lại hoàn toàn tự động.
Bước 3: Tải xuống tệp PDF đã giải nén hoàn chỉnh
Sau khi hoàn tất, tệp kết quả sẵn sàng để bạn tải về thiết bị. Hãy mở tệp này bằng bất kỳ trình soạn thảo code hoặc text nào (như Visual Studio Code hoặc Notepad++) để tự do đọc, tìm kiếm bằng Ctrl+F và phân tích cú pháp. Nếu trong quá trình phân tích bạn phát hiện các bảng offset bị đứt gãy từ file gốc, bạn có thể tham khảo thêm cách sửa file PDF bị lỗi trực tuyến để khôi phục hoàn chỉnh cấu trúc xref.
Đọc hiểu cú pháp PDF thô: Các toán tử đồ họa phổ biến trong trình soạn thảo
Khi mở tệp PDF đã giải nén trong trình soạn thảo mã nguồn, toàn bộ các khối ký tự nhị phân bí ẩn biến mất hoàn toàn. Thay vào đó, bạn sẽ nhìn thấy các toán tử đồ họa PostScript rõ ràng định hình cách từng ký tự và khối hình hiển thị trên trang:
5 0 obj
<<
  /Length 284
>>
stream
q
1 0 0 1 50 720 cm
BT
/F1 16 Tf
18 TL
(Chao mung den voi Ky thuat Tai lieu PDF) Tj
T*
/F2 11 Tf
(Tat ca cac luong noi dung da co the doc duoc truc tiep.) Tj
ET
0.2 0.4 0.8 rg
50 680 500 2 re
f
Q
endstream
endobj
Nắm rõ các toán tử cơ bản giúp việc kiểm tra tài liệu trở nên dễ dàng:
qvàQ: Lưu và phục hồi ngăn xếp trạng thái đồ họa (giữ nguyên độ dày nét vẽ, màu sắc và ma trận tọa độ).cm: Ma trận biến đổi hiện tại (Current Transformation Matrix), thiết lập vị trí, tỷ lệ co giãn hoặc góc xoay của phần tử.BTvàET: Bắt đầu khối văn bản (Begin Text) và kết thúc khối văn bản (End Text). Toàn bộ thao tác hiển thị chữ bắt buộc phải nằm giữa hai toán tử này./F1 16 Tf: Chỉ định sử dụng tài nguyên phông chữ F1 với kích thước 16 point.Tj: Hiển thị chuỗi văn bản trên trang. Bạn có thể đọc trực tiếp các từ ngữ nằm trong dấu ngoặc đơn.T*: Di chuyển con trỏ văn bản xuống đầu dòng tiếp theo dựa theo khoảng cách dòng (TL).revàf: Khai báo một hình chữ nhật (tọa độ x, y, chiều rộng, chiều cao) và tô màu hiện tại vào hình đó.
Nhờ các luồng dữ liệu đã được giải nén thành văn bản, việc tìm kiếm một đoạn văn bản bị thiếu hoặc xác định vì sao hình ảnh bị lệch tọa độ chỉ mất vài thao tác tìm kiếm đơn giản bằng phím tắt Ctrl+F.
So sánh tiện ích trình duyệt trực tuyến và các công cụ dòng lệnh (qpdf, mutool)
Trong môi trường phát triển truyền thống, các lập trình viên thường dùng hai công cụ dòng lệnh phổ biến sau để giải nén luồng PDF:
- Cú pháp lệnh qpdf:
qpdf --qdf --object-streams=disable input.pdf output.pdf - Cú pháp lệnh MuPDF mutool:
mutool clean -d input.pdf output.pdf
Mặc dù các tiện ích CLI này rất mạnh mẽ, chúng lại tạo ra rào cản đáng kể trong công việc hàng ngày:
- Đòi hỏi phải cài đặt trình quản lý gói phụ trợ (như Homebrew trên macOS hoặc apt trên Linux) và biên dịch thư viện C++.
- Không thể chạy trên máy tính công ty bị khóa quyền quản trị, thiết bị di động, máy tính bảng hoặc Chromebook không có terminal.
- Nhân viên văn phòng, chuyên viên pháp lý hoặc kiểm toán viên không quen với việc gõ lệnh và điều hướng đường dẫn thư mục.
Tiện ích trực tuyến mang lại khả năng giải nén chuyên sâu tương đương thông qua giao diện trực quan trên trình duyệt, không cần cấu hình terminal hay cài đặt phần mềm.
Hệ quả kỹ thuật: Dung lượng tệp tăng vọt và thời điểm cần nén lại
Khi thao tác với các tệp PDF đã giải nén, bạn cần lưu ý hai đặc điểm kỹ thuật thực tế:
1. Kích thước tệp gia tăng đáng kể
Thuật toán FlateDecode thông thường đạt tỷ lệ nén từ 60% đến 85% trên dữ liệu đồ họa vector và chuỗi lệnh văn bản. Việc mở rộng các luồng này sẽ làm tổng dung lượng tệp tăng lên nhiều lần. Một tài liệu nén 500 KB có thể tăng lên 2 MB hoặc 4 MB sau khi giải nén toàn bộ cây đối tượng. Do đó, các tệp PDF giải nén chỉ nên được dùng trong môi trường thử nghiệm, phân tích lỗi và lập trình, không nên dùng để phát hành cho khách hàng cuối.
2. Cách xử lý đối với các luồng hình ảnh
Tài liệu PDF lưu trữ hình ảnh chụp bằng các bộ lọc chuyên biệt, chẳng hạn như /DCTDecode cho ảnh JPEG và /JPXDecode cho ảnh JPEG 2000. Quá trình giải nén luồng PDF chỉ bóc tách các lệnh vẽ FlateDecode, metadata và từ điển font chữ sang văn bản, chứ không chuyển các ảnh JPEG thành ký tự văn bản. Ảnh chụp vẫn giữ nguyên định dạng bitmap để tài liệu hiển thị trọn vẹn trên các trình đọc thông thường.
3. Nén lại tệp sau khi hoàn thành sửa đổi
Sau khi hoàn tất quá trình kiểm tra mã nguồn hoặc chỉnh sửa thủ công các toán tử, bạn nên nén tài liệu trở lại để tối ưu hóa băng thông trước khi gửi email hoặc đăng tải trực tuyến.
Bảo mật tuyệt đối: Xử lý giải nén trong RAM và cơ chế tự hủy dữ liệu
Các tài liệu PDF được đưa vào kiểm tra kỹ thuật thường chứa mã nguồn độc quyền, số liệu tài chính nội bộ hoặc dự thảo hợp đồng mật. Khi sử dụng công cụ trực tuyến, tính bảo mật của dữ liệu luôn là mối quan tâm hàng đầu.
Nhiều dịch vụ chuyển đổi thông thường ghi tệp của người dùng vào ổ cứng máy chủ lâu dài hoặc thu thập dữ liệu trái phép. AZ2PDF cam kết tiêu chuẩn bảo vệ quyền riêng tư nghiêm ngặt nhất:
- Xử lý hoàn toàn trong bộ nhớ RAM tạm thời: Quy trình đọc cấu trúc, giải nén FlateDecode và tái cấu trúc bảng tham chiếu chỉ diễn ra trong bộ nhớ đệm khả biến, tuyệt đối không lưu trữ vĩnh viễn trên ổ đĩa.
- Cơ chế tự hủy tự động sau 5 phút: Tiến trình dọn dẹp chạy ngầm liên tục trên hệ thống để hủy vĩnh viễn mọi dữ liệu tạm thời chỉ trong vòng 5 phút sau khi kết thúc tác vụ.
- Miễn phí 100% không yêu cầu đăng ký: Bạn không cần cung cấp địa chỉ email, số điện thoại hay tài khoản cá nhân, đảm bảo tính ẩn danh trọn vẹn.
- Không chèn hình mờ quảng cáo: Tệp PDF xuất ra hoàn toàn sạch sẽ, không bị gắn thêm bất kỳ logo hay dấu quảng cáo nào làm biến đổi dữ liệu.
Khám phá trọn bộ giải pháp xử lý tài liệu bảo mật và chuyên nghiệp tại nền tảng công cụ PDF trực tuyến AZ2PDF, nơi mọi tác vụ kỹ thuật được thực thi an toàn và riêng tư tuyệt đối.
❓ Câu Hỏi Thường Gặp
Bởi vì các tài liệu PDF tiêu chuẩn luôn nén luồng nội dung trang, thông số phông chữ và siêu dữ liệu bằng thuật toán zlib Deflate (thể hiện qua khóa /Filter /FlateDecode trong từ điển đối tượng). Khi bạn mở file bằng trình soạn thảo văn bản, chương trình cố gắng hiển thị các byte nhị phân nén dưới dạng văn bản thường nên gây ra chuỗi ký tự rác. Thao tác giải nén sẽ mở rộng các luồng nhị phân này thành các lệnh văn bản đọc hiểu được.
Bài Viết Cùng Chủ Đề Liên Quan
Khám phá các kỹ thuật tổ chức trang và quản lý tài liệu PDF chuyên nghiệp.
Cách tự động đổi tên file PDF theo nội dung trực tuyến miễn phí
Hướng dẫn cách tự động đổi tên file PDF theo nội dung văn bản và thẻ tiêu đề metadata trực tuyến miễn phí. Sắp xếp hóa đơn, hồ sơ scan không suy hao chất lượng.

Cách sửa file PDF bị lỗi trực tuyến (Miễn phí & Bảo mật)
Hướng dẫn khôi phục và sửa lỗi file PDF bị hỏng, không mở được trực tuyến miễn phí. Tái tạo bảng xref, phục hồi luồng dữ liệu nhị phân và truy cập tài liệu tức thì.

Cách xóa trang trắng trong file PDF quét trực tuyến miễn phí và nhanh chóng
Hướng dẫn tự động phát hiện và xóa trang trắng trong tài liệu PDF scan trực tuyến miễn phí. Loại bỏ các trang quét hai mặt rỗng không làm giảm chất lượng file.
Cách chuyển đổi PDF sang chuẩn PDF/A để lưu trữ số lâu dài
Hướng dẫn chuyển đổi tài liệu PDF sang định dạng PDF/A chuẩn ISO 19005 miễn phí trực tuyến. Nhúng font chữ, chuẩn hóa hệ màu ICC và bảo tồn tài liệu vĩnh viễn.

Cách đặt mật khẩu bảo vệ file PDF miễn phí (Mã hóa chuẩn quân sự AES-256)
Hướng dẫn cách đặt mật khẩu và mã hóa file PDF trực tuyến miễn phí bằng chuẩn mã hóa AES-256 cấp ngân hàng. Bảo vệ hợp đồng, sao kê lương tuyệt đối an toàn.

Cách mở khóa và xóa mật khẩu file PDF trực tuyến (Gỡ bảo vệ vĩnh viễn)
Hướng dẫn cách mở khóa và xóa mật khẩu bảo vệ file PDF trực tuyến miễn phí. Giải mã quyền in ấn, sao chép văn bản an toàn, không watermark, bảo mật tuyệt đối.