Cách chuyển đổi PDF sang Markdown trực tuyến miễn phí (trích xuất MD sạch)
Câu Trả Lời Trực Tiếp & Điểm Cốt Lõi
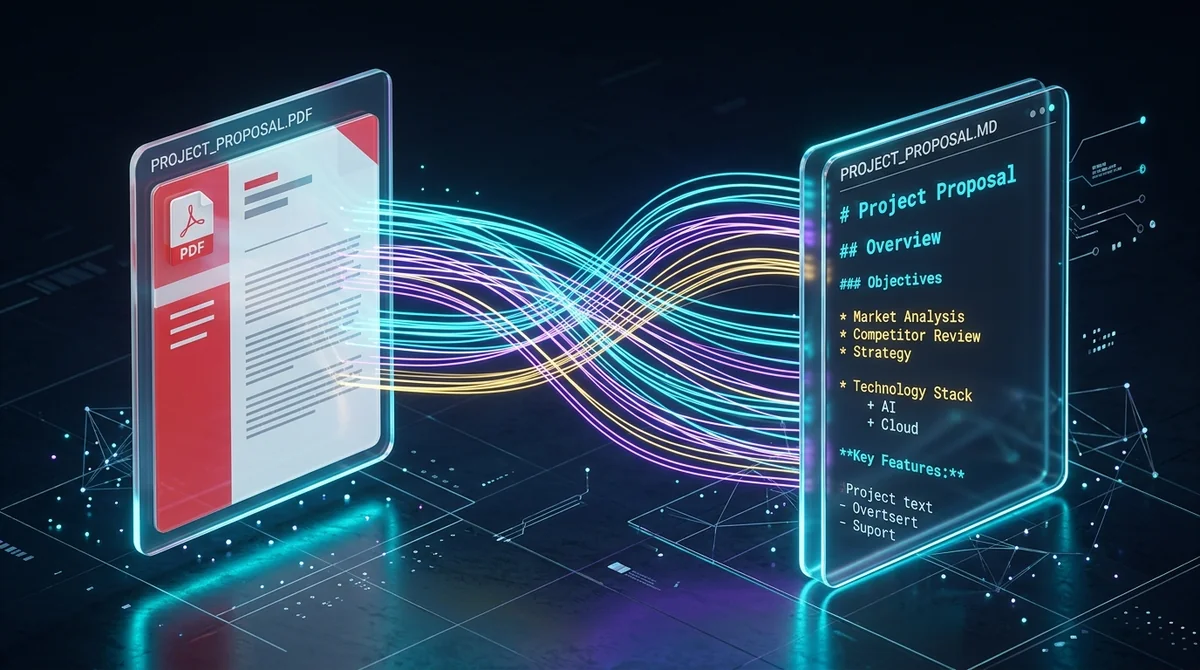
Để chuyển đổi PDF sang Markdown trực tuyến, bạn cần phân tích luồng văn bản gốc, nhận diện phân cấp ấn bản (như cỡ chữ, ngắt dòng, ký hiệu danh sách) và ánh xạ chúng sang cú pháp Markdown GitHub Flavored (# cho tiêu đề, * cho danh sách và khối mã code). Công cụ AZ2PDF PDF sang Markdown xử lý hoàn toàn miễn phí ngay trong trình duyệt mà không lưu trữ dữ liệu, tạo ra các tệp .md chuẩn cấu trúc sẵn sàng cho LLM, Obsidian và trình tạo trang tĩnh.
- Tối ưu ngữ cảnh AI & LLM: Định dạng Markdown loại bỏ lề trang và bố cục thừa, giúp tiết kiệm tới 70% lượng token khi nạp tài liệu vào các mô hình AI.
- Bảo toàn cấu trúc phân cấp: Tự động tái tạo tiêu đề, danh sách có thứ tự và không thứ tự, trích dẫn blockquote và đoạn mã nguồn sang cú pháp chuẩn GFM.
- Bảo mật dữ liệu tuyệt đối: Quá trình xử lý tài liệu diễn ra hoàn toàn trong bộ nhớ RAM tạm thời và tự động hủy sau khi hoàn thành.
- Miễn phí 100% không giới hạn: Chuyển đổi không giới hạn tài liệu PDF sang Markdown mà không cần đăng ký tài khoản, không giới hạn dung lượng và không chèn watermark.
Tại sao chuyển PDF sang Markdown phức tạp hơn việc sao chép văn bản
Lập trình viên phần mềm, nhà nghiên cứu trí tuệ nhân tạo và các chuyên gia quản trị tri thức thường xuyên đối mặt với rào cản lớn khi làm việc với tài liệu: định dạng PDF. Dù phân tích báo cáo kỹ thuật, tài liệu nghiên cứu học thuật hay tài liệu API, PDF luôn là chuẩn mực toàn cầu để phân phối văn bản. Tuy nhiên, khi bạn cố gắng trích xuất nội dung đó sang định dạng Markdown (.md) hiện đại, các công cụ cơ bản thường thất bại hoàn toàn.
Theo tiêu chuẩn quốc tế ISO 32000, PDF không phải là luồng văn bản liên tục như tệp Word hay Google Docs. Bản chất của PDF là một mặt phẳng hiển thị hai chiều dựa trên tọa độ hình học PostScript. Tệp PDF chứa các lệnh toán học chính xác điều khiển bộ vẽ hiển thị từng ký tự (glyph) tại tọa độ cố định trên trang giấy in, sử dụng các toán tử định vị như BT (Bắt đầu văn bản), ET (Kết thúc văn bản) và ma trận biến đổi tọa độ Tm.
Do PDF ưu tiên hiển thị thị giác hơn ngữ nghĩa cấu trúc, nó không có khái niệm gốc về đoạn văn, tiêu đề h1/h2, danh sách gạch đầu dòng hay khối trích dẫn. Các từ trên cùng một dòng nhìn thấy được có thể nằm rải rác ngược chiều trong luồng nhị phân. Các đoạn ngắt dòng sinh ra chỉ để chữ không tràn mép giấy A4 bị mã hóa thành ký tự xuống dòng cứng. Khi bạn sao chép văn bản từ trình xem PDF thông thường, bạn nhận về những câu văn đứt đoạn, từ ngữ bị gãy nửa (như "tài- liệu") và mất toàn bộ trật tự phân cấp.
Ngược lại, Markdown là định dạng thuần ngữ nghĩa. Trong Markdown, văn bản trôi chảy tự nhiên với cú pháp thanh thoát: dấu thăng (#) cho tiêu đề, dấu sao (*) cho danh sách và dấu backtick cho khối mã. Việc chuyển đổi PDF sang Markdown đòi hỏi một quy trình thông minh nhằm tái cấu trúc thứ tự đọc, đo đạc kích thước phông chữ để suy luận cấp độ tiêu đề, loại bỏ lề giấy in và chuyển dịch bố cục thị giác thành mã ngữ nghĩa chuẩn chỉ.
Trích xuất tài liệu kỹ thuật phức tạp thành các tệp Markdown thân thiện với lập trình viên cùng công cụ chuyển đổi PDF sang Markdown AZ2PDF. Công cụ tự động phân tích phân cấp tiêu đề, khối mã nguồn và danh sách thành cú pháp CommonMark chuẩn mực.
Tại sao Markdown là định dạng tối ưu cho LLM, RAG và kho tri thức số
Nhu cầu chuyển đổi PDF sang Markdown độ trung thực cao đã bùng nổ mạnh mẽ, trở thành nền tảng cốt lõi cho các luồng xử lý AI hiện đại và quản trị tri thức cá nhân:
1. Tiết kiệm lượng lớn token và cung cấp ngữ cảnh sạch cho AI: Khi nạp tài liệu vào các mô hình ngôn ngữ lớn (LLM) như GPT-4, Claude 3.5 hay Gemini 1.5, số lượng token quyết định trực tiếp chi phí và chất lượng câu trả lời. Nạp trực tiếp PDF thô làm lãng phí hàng nghìn token vào lề trang, tiêu đề lặp lại và số trang chân trang. Markdown loại bỏ toàn bộ nhiễu hạt này trong khi vẫn giữ vững cấu trúc logic, giúp giảm 50% đến 75% lượng token tiêu thụ.
2. Tối ưu tìm kiếm vector trong mô hình RAG: Các hệ thống Retrieval-Augmented Generation (RAG) dựa vào các đoạn văn bản (chunks) được đánh số chỉ mục vector. Markdown cung cấp các ranh giới tự nhiên: phân đoạn theo tiêu đề H2 (##) hoặc H3 (###) giúp công cụ tìm kiếm vector cô lập trọn vẹn từng chủ đề mạch lạc, tăng vọt độ chính xác truy xuất và loại trừ hiện tượng ảo giác (hallucination) của AI.
3. Tích hợp liền mạch với Obsidian, Notion và Logseq: Các chuyên gia dùng hệ thống quản trị tri thức cá nhân (PKM) ưa thích tệp Markdown cục bộ. Lưu trữ tài liệu nghiên cứu dưới dạng Markdown cho phép tạo liên kết hai chiều (wiki-links), gắn thẻ tag và xây dựng bộ não thứ hai vĩnh cửu không bị khóa chặt trong định dạng nhị phân độc quyền.
4. Quản lý phiên bản tài liệu bằng Git diff dễ dàng: Bạn không thể theo dõi sự thay đổi trên tệp nhị phân PDF. Khi chuyển sang Markdown, từng đoạn văn, ví dụ mã code và tham số kỹ thuật đều có thể được theo dõi và đánh giá thông qua các lệnh Git commit và pull request tiêu chuẩn.
Cách chuyển đổi PDF sang Markdown trực tuyến qua 3 bước đơn giản
Bạn không cần cài đặt các thư viện Python phức tạp hay phần mềm thương mại đắt đỏ để chuyển tài liệu sang Markdown. Quy trình trực tuyến hoàn tất nhanh chóng ngay trong trình duyệt:
- Tải tài liệu PDF lên: Kéo thả tệp PDF vào khu vực tải lên của công cụ trực tuyến hoặc duyệt tệp từ thiết bị của bạn. Quá trình xử lý khởi chạy tức thì.
- Trích xuất cấu trúc tự động: Động cơ phân tích luồng văn bản, phân loại phông chữ lớn thành các thẻ tiêu đề (
#,##,###), căn chỉnh các điểm đánh dấu thành danh sách Markdown chuẩn và chuẩn hóa khoảng cách đoạn văn. - Tải về tệp Markdown (.md) sạch: Nhấn nút tải về để lưu tệp .md hoàn chỉnh về máy. Tệp sẵn sàng mở ngay trong Obsidian hoặc đưa vào prompt AI hoàn toàn miễn phí không bị gắn watermark quảng cáo.
Bạn có thể dễ dàng quản lý toàn diện quy trình làm việc với tài liệu của mình thông qua hệ sinh thái công cụ PDF trực tuyến của AZ2PDF.
So sánh Markdown, Plain Text và HTML: Chọn định dạng xuất phù hợp
Tùy theo mục đích sử dụng cụ thể, việc lựa chọn định dạng trích xuất sẽ quyết định hiệu quả công việc:
Markdown (.md): Cân bằng hoàn hảo giữa khả năng đọc của con người và cấu trúc máy học. Cung cấp các ký hiệu ngữ nghĩa cho tiêu đề, danh sách, trích dẫn và khối mã nguồn mà vẫn là văn bản thuần túy. Lựa chọn số một cho AI, kho ghi chú Obsidian và trang tài liệu kỹ thuật.
Văn bản thuần (.txt): Phù hợp khi bạn chỉ cần chữ cái đơn thuần để lọc bằng biểu thức chính quy (Regex) hoặc chạy các tập lệnh terminal bash như grep và awk.
HTML Web (.html): Phù hợp khi cần nhúng trực tiếp lên các trang web với đầy đủ thuộc tính CSS trang trí.
Sau khi tinh chỉnh tài liệu kỹ thuật trong trình soạn thảo ưa thích, bạn có thể dễ dàng biên dịch ngược ghi chú Markdown đã cập nhật thành tệp PDF trang nhã để gửi báo cáo chuyên nghiệp cho cấp quản lý.
Tài liệu PDF kỹ thuật số gốc và PDF scan: Tầm quan trọng của OCR
Hiểu rõ nguồn gốc của tệp PDF giúp bạn tránh được sự bối rối khi kết quả trích xuất bị trống:
PDF kỹ thuật số gốc: Được xuất trực tiếp từ phần mềm soạn thảo (Word, Google Docs, LaTeX). Tệp chứa mã ký tự vector chuẩn và bảng ánh xạ phông chữ /ToUnicode, cho phép trích xuất văn bản chính xác 100% với tốc độ tức thì.
PDF scan dạng ảnh: Được tạo khi quét giấy tờ qua máy scan hoặc chụp ảnh bằng điện thoại. Đối với máy tính, tệp này chỉ chứa các bức ảnh bitmap raster mà không có luồng văn bản số. Để trích xuất tài liệu scan sang Markdown, tài liệu bắt buộc phải qua công đoạn nhận dạng ký tự quang học (OCR) của AZ2PDF để tái tạo lớp văn bản trước khi xuất ra Markdown.
Thực hành tốt nhất để có Markdown sạch và xử lý các lỗi định dạng thường gặp
Để tài liệu Markdown sau khi chuyển đổi đạt chất lượng tối ưu và ít phải chỉnh sửa thủ công nhất, hãy ghi nhớ những kinh nghiệm sau:
1. Xử lý tài liệu chia nhiều cột: Các bài báo nghiên cứu thường dùng bố cục hai cột. Động cơ trích xuất thông minh sẽ phân tích rãnh phân tách cột để đọc hết cột bên trái trước khi sang cột bên phải, đảm bảo văn bản không bị đan xen lộn xộn.
2. Xử lý bảng biểu phức tạp: Bảng số liệu có nhiều ô gộp hoặc nhiều dòng trong một ô nên được xử lý cẩn thận. Với bảng quá phức tạp, bạn có thể chuyển bảng sang dạng bảng tính trước khi dán vào Markdown.
3. Bảo toàn khối mã nguồn: Kiểm tra lại các khối mã code và thêm định danh ngôn ngữ (như python, bash) sau ba dấu backtick để trình đọc hiển thị màu cú pháp chính xác.
4. Nối các từ bị gắt ngọn ở cuối dòng: Thuật toán tự động nhận diện các dấu gạch nối mềm ngắt dòng và ghép liền từ ngữ lại với nhau, giữ cho câu văn liền mạch.
Bảo mật và quyền riêng tư: Tại sao xử lý bộ nhớ tạm thời là bắt buộc
Các tài liệu kỹ thuật, nghiên cứu độc quyền hay hợp đồng chuyển sang Markdown thường chứa thông tin cơ mật cao. AZ2PDF được thiết kế trên nền tảng ưu tiên quyền riêng tư tuyệt đối. Toàn bộ quá trình xử lý văn bản diễn ra trong vùng đệm RAM cách ly tạm thời và lập tức trả kết quả về phiên duyệt web của bạn.
Hệ thống không lưu trữ tệp trên ổ cứng vĩnh viễn, không xem nội dung và không chia sẻ dữ liệu cho bên thứ ba. Tiến trình tự động quét dọn nền sẽ xóa vĩnh viễn mọi dữ liệu tạm trong vòng 5 phút sau khi phiên làm việc kết thúc.
Tối ưu hóa quy trình làm việc kỹ thuật của bạn cùng nền tảng xử lý tài liệu trực tuyến AZ2PDF, tận hưởng khả năng xử lý nhanh chóng mà không phụ thuộc máy chủ bên ngoài.
❓ Câu Hỏi Thường Gặp
Có. Công cụ PDF sang Markdown của AZ2PDF hoạt động trực tiếp trong trình duyệt hoàn toàn miễn phí, không yêu cầu tạo tài khoản, không giới hạn số lượng và không chèn watermark.
Bài Viết Cùng Chủ Đề Liên Quan
Khám phá các kỹ thuật tổ chức trang và quản lý tài liệu PDF chuyên nghiệp.
Cách chuyển PDF sang EPUB trực tuyến miễn phí (Bố cục linh hoạt cho máy đọc sách)
Hướng dẫn chuyển đổi tài liệu PDF sang sách điện tử EPUB tự co giãn dòng trực tuyến miễn phí. Đọc mượt mà trên Kindle, Kobo và điện thoại không mỏi mắt.
Cách chuyển PDF sang XML trực tuyến miễn phí (Dữ liệu có cấu trúc kèm tọa độ)
Hướng dẫn chuyển đổi tài liệu PDF sang mã XML có cấu trúc trực tuyến miễn phí. Bóc tách tọa độ không gian bounding box, định dạng font và nút văn bản chuẩn xác.
Cách chuyển đổi file HTML sang PDF trực tuyến không lỗi định dạng
Hướng dẫn cách chuyển đổi file HTML và mã CSS sang tài liệu PDF chuẩn in ấn trực tuyến miễn phí. Giữ nguyên phông chữ, ngắt trang và bố cục không có hình mờ.
Cách chuyển PDF sang HTML trực tuyến miễn phí (giữ nguyên bố cục và mã sạch)
Hướng dẫn chuyển đổi tài liệu PDF sang mã web HTML5 và CSS trực tuyến miễn phí. Giữ trọn font chữ, màu sắc và đồ họa vector sắc nét không watermark.
Cách đảo ngược màu PDF sang Dark Mode trực tuyến miễn phí (bảo vệ mắt)
Hướng dẫn đảo ngược màu PDF sang nền tối Dark Mode trực tuyến miễn phí. Giảm mỏi mắt ban đêm, tiết kiệm pin OLED, giữ nguyên 100% nét chữ vector và tìm kiếm Ctrl+F.
Cách xóa toàn bộ hình ảnh trong file PDF trực tuyến miễn phí (giữ nguyên chữ và vector)
Hướng dẫn cách xóa toàn bộ hình ảnh, ảnh nền và đồ họa raster khỏi file PDF trực tuyến miễn phí. Giữ nguyên chữ vector sắc nét, tiết kiệm mực in và giảm dung lượng tối đa.