PDFストリームをオンラインで無料解凍する方法(生コードとFlateDecodeの展開)
結論と重要ポイント
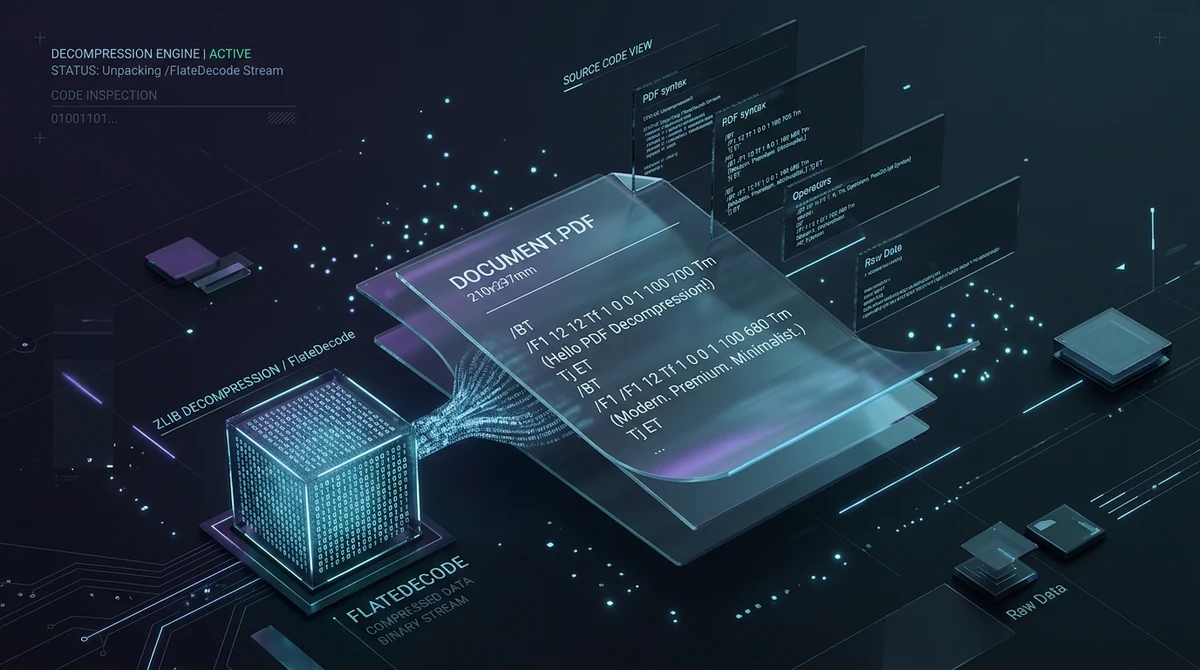
PDFストリームをオンラインで無料解凍するとは、ISO 32000規格に準拠し、内部で圧縮されたバイナリストリーム(FlateDecode、LZWDecode、ASCII85Decodeなど)を平文のPostScript・PDF構文に展開する処理です。AZ2PDFのストリーム解凍ツールを使用すれば、エンジニアやセキュリティ担当者がソフトウェアをインストールすることなく、ブラウザ上で安全かつ瞬時にページ演算子を可視化できます。
- PDF生コードの可視化: 難解なFlateDecodeバイナリブロックを、平文のPostScript風演算子(BT, ET, Tf, Tj, cm, re, f)に展開します。
- 開発者とデバッグに必須: レンダリング異常、フォントエンコーディングの競合、境界ボックスのズレ、破損したベクターパスを即座に診断可能。
- セキュリティ調査と監査: 圧縮フィルターの背後に隠された悪意あるJavaScript辞書や難読化ペイロードを直接露出させて検査します。
- 完全無料&RAM内セキュア処理: サーバーの揮発性メモリ上でのみ高速処理され、登録不要、透かしなし、5分以内の完全自動消去を保証。
PDF内部の隠蔽コード:ストリームがデフォルトで圧縮される理由
一般的なPCユーザーにとって、PDFファイルは印刷されたデジタル用紙や固定画像のように感じられます。ダブルクリックすれば、美しく配置された段落、シャープなロゴ、整った表が即座に表示されます。しかし、その視覚的レイアウトの深層には、国際標準ISO 32000によって厳密に定義された、高度なオブジェクト指向言語が存在しています。
標準的なPDFは、辞書(Dictionary)、配列(Array)、数値、文字列、そしてストリーム(Stream)という独立した構成要素から組み立てられています。ストリームは、ページ描画コマンド、ベクター図形のパス座標、埋め込みフォントプログラム、メタデータなど、大量のデータを格納するバイナリシーケンスです。
もしすべてのページストリームがプレーンなASCIIテキストで保存されていた場合、ファイルサイズは膨大に肥大化してしまいます。わずか20ページの請求書であっても、繰り返される座標指定や描画命令により、簡単に数十メガバイトに達します。この問題を解決するため、PDF生成エンジン(Adobe Acrobat、Ghostscript、Puppeteerなど)は数学的アルゴリズムを用いて内部ストリームを圧縮します。軽量で共有しやすくなる反面、内部の構文は暗号化されたようなバイナリブロックとなり、人の目では直接読めなくなります。
内部構造を調査・修復したり、ドキュメントの生成ロジックを解析するためには、構造を破壊することなくストリームをAZ2PDFツールによるPDFストリームの解凍処理が不可欠です。
FlateDecodeとは何か?なぜ未解凍のコードは文字化けに見えるのか
通常のPDFファイルをVisual Studio CodeやSublime Text、メモ帳などのテキストエディタで開くと、ファイルの先頭にあるヘッダー(%PDF-1.7など)や基本的な辞書キー(/Type /Catalog、/Pages)は確認できるかもしれません。しかし、カーソルが実際のコンテンツストリームに達した瞬間、画面は意味不明な記号、文字化け、疑問符の羅列で埋め尽くされます。
以下は、圧縮ストリーム直前のオブジェクト辞書の典型例です:
5 0 obj
<<
  /Length 1420
  /Filter /FlateDecode
>>
stream
xœí[msÛ8 … [判読不能なバイナリデータ] …
endstream
endobj
このバイナリ化を引き起こしているのが /Filter /FlateDecode という記述です。PDF仕様において、FlateDecodeは業界標準のzlib/deflate圧縮アルゴリズム(RFC 1950およびRFC 1951で定義)を指します。Deflateはストリーム内の重複シーケンスを検出し、ビットレベルの後方ポインタに置き換え、ハフマン符号化を適用することでデータを劇的に圧縮します。
ビット単位で圧縮されているため、テキストエディタはこれを標準的なUTF-8やASCII文字列として解釈できません。日常的な閲覧であればビューアがメモリ上で自動展開するため問題ありませんが、ソフトウェア開発者やフォレンジック調査員にとっては、このバイナリの壁がコマンド検査の大きな障害となります。
主なユースケース:PDF内部ストリームの解凍が必要な専門職とは
PDFストリームの解凍は、ファイルを展開するとサイズが何倍にも肥大化するため、一般的なファイル共有用途ではありません。しかし、以下のような専門的なエンジニアリング領域では極めて重要な役割を果たします:
- PDF生成パイプラインを構築するソフトウェアエンジニア: pdf-lib、ReportLab、FPDF、TCPDF、Puppeteer、Apache PDFBoxなどのライブラリで帳票出力を行う際、文字の重複、フォント幅のずれ、不適切なクリッピングパスなどのバグが頻発します。出力されたPDFを解凍することで、VS Code上で正確な描画マトリクス(
cmやTm演算子)を直接検査し、コード内の不具合を特定できます。 - プリプレス技術者および印刷工場オペレーター: 商業印刷では、厳密なカラーマネジメントとフォントの整合性が求められます。エンジニアはPDFを解凍して、フォントに正しいToUnicode CMapが含まれているか、CMYK分離チャンネルやスポットカラー定義が正確かを事前に検証します。
- サイバーセキュリティアナリスト&デジタルフォレンジック調査員: 攻撃者は圧縮されたPDFストリーム内部に悪意あるJavaScriptコードや難読化シェルコードを隠蔽することがあります。オブジェクトツリー全体を解凍することで、隠された
/JavaScript辞書や不正なxrefエントリを露出し、セキュリティツールで精密に検査できます。 - PDF仕様(ISO 32000)を学ぶ開発者や学生: 1,000ページを超えるISO公式規格書を読むだけでは理解が困難です。解凍されたクリーンなPDFをエディタで閲覧することで、オブジェクト、フォントリソース、グラフィックス状態の関連性が視覚的に理解できます。
ISO 32000規格に基づくPDFストリーム解凍の内部仕組み
PDFの解凍は、単に7-Zipなどの汎用展開ソフトにかけるような単純な処理ではありません。PDFは相互参照されたオブジェクトグラフで構成されているため、ファイル全体に無差別な展開処理を施すとヘッダーやxrefテーブルが破壊され、ファイルが開けなくなります。
- 相互参照テーブル(XRef)のマッピング: パーサーがトレイラーを読み込み、メモリ上にすべての間接オブジェクト(
1 0 R、2 0 Rなど)のアドレスマップを作成します。 - ストリーム辞書の検知と検査: ドキュメントツリー全体を走査し、ストリームを含むオブジェクトを特定。
/Filterおよび/DecodeParmsキーを検証します(FlateDecode、LZWDecode、ASCII85Decodeなどに対応)。 - インメモリでのペイロード展開: 圧縮されたバイナリがメモリ上の入出力ストリームを通過し、元の未圧縮バイト列へと復元されます。
- フィルター辞書キーの削除: オブジェクト辞書から
/Filterと/DecodeParmsを除去し、以降のリーダーに対してストリームが生データであることを宣言します。 - ストリーム長(/Length)の再計算: 展開によりサイズが増加するため、古い
/Length値を無効化し、正確な未圧縮バイト数を計測して整数値を更新します。 - XRefテーブルの完全再構築: ドキュメント全体を未圧縮構文として再シリアライズ。すべてのオブジェクトの開始バイト位置(byte offset)を再計算してXRefテーブルを新規構築することで、あらゆるPDFリーダーでエラーなく開ける整合性を担保します。
オンラインでPDFストリームを解凍する3つの簡単ステップ
かつてPDFストリームの展開には、C++コンパイラの設定やPythonスクリプトの作成が必要でした。Webブラウザツールを使えば、数秒で安全に完了します:
ステップ 1: PDFファイルをアップロード
解凍ツールを開き、対象のPDFファイルをドラッグ&ドロップするか、端末から選択します。Windows、macOS、Linux、iOS、Androidのいずれのブラウザでも完全に動作します。
ステップ 2: 高速エンジンが内部ストリームを自動展開
ファイルが読み込まれると、サーバーの揮発性メモリ上でドキュメント構造が解析されます。FlateDecodeストリームがプレーンテキストに変換され、フィルターが除去され、オフセットが自動補正されます。
ステップ 3: 解凍済みPDFをダウンロードしてエディタで確認
処理完了後、解凍されたPDFファイルをダウンロードします。VS CodeやSublime Textなどのテキストエディタで開くことで、すべてのPostScript演算子を自由に検索・分析できます。もし元のファイルに構造的な不整合がある場合は、破損したPDFファイルをオンラインで修復する方法を参考にクロスリファレンステーブルを正常化してください。
生のPDF構文を読み解く:テキストエディタ内で確認できる主要演算子
解凍されたPDFをテキストエディタで開くと、バイナリの壁が消え去り、以下のような整然とした描画オペレーターが現れます:
5 0 obj
<<
  /Length 284
>>
stream
q
1 0 0 1 50 720 cm
BT
/F1 16 Tf
18 TL
(Welcome to Document Engineering) Tj
T*
/F2 11 Tf
(All page content streams are now fully human-readable.) Tj
ET
0.2 0.4 0.8 rg
50 680 500 2 re
f
Q
endstream
endobj
主要な演算子の役割を理解することで、調査作業がスムーズに進みます:
qとQ: グラフィックス状態スタックの保存と復元(線幅、描画色、変換行列を保持)。cm: 現在の変換行列(Current Transformation Matrix)。要素の配置座標、拡大縮小、回転角度を制御。BTとET: テキストブロックの開始(Begin Text)と終了(End Text)。文字出力は必ずこの内部で行われます。/F1 16 Tf: フォントリソースF1をサイズ16ポイントでアクティブ化。Tj: 文字列をページ上に描画。括弧内の英数字がそのまま出力テキストです。T*: 行送りパラメーター(TL)に従って次の行の先頭へカーソルを移動。reとf: 矩形パス(x, y, 幅, 高さ)を定義し、現在の塗りつぶし色で描画。
ストリームが展開されていれば、エディタのCtrl+F検索を使用するだけで、特定のテキストの描画位置や異常な座標指定を瞬時に特定できます。
オンラインブラウザツールとコマンドライン(qpdf、mutool)の比較
開発現場では従来、ターミナルから以下のCLIツールを用いてストリームを展開していました:
- qpdf コマンド構文:
qpdf --qdf --object-streams=disable input.pdf output.pdf - MuPDF mutool 構文:
mutool clean -d input.pdf output.pdf
これらのコマンドラインツールは強力ですが、いくつかの制約があります:
- Homebrewなどのパッケージマネージャーの導入や環境変数の構築が必要です。
- ターミナル操作が制限された企業の管理下PC、Chromebook、スマートフォンでは実行できません。
- 日常的な簡易調査において、コマンド引数の指定は手間がかかります。
オンラインツールなら、ブラウザ上で直感的に同じプロ仕様の解凍処理を実行でき、環境構築の手間を完全にゼロにできます。
技術的留意点:ファイルサイズの大幅増加と再圧縮のタイミング
解凍済みPDFを扱う際には、以下の2点に注意してください:
1. ファイルサイズが大幅に増大する
FlateDecode圧縮は、ベクター図形や描画命令を60〜85%程度圧縮しています。これらを平文テキストに展開すると、500KBの文書が2MB〜4MB程度に膨らみます。そのため、解凍ファイルはデバッグや内部検証用にとどめ、顧客への最終納品には使用しないでください。
2. 写真・画像ストリームの挙動
PDF内の写真は、通常 /DCTDecode(JPEG)などの専用画像フィルターで格納されています。ストリーム解凍ツールはFlateDecodeのページ命令やフォント辞書を展開しますが、JPEG写真データを無意味に文字コード化することはありません。画像は有効なビットマップとして保持され、標準ビューアでも正常にレンダリングされます。
3. 調査完了後の再圧縮
コードの修正や確認が完了した後は、配布前に最適化・再圧縮を行い、ファイルサイズを適正な状態に戻すことを推奨します。
プライバシー重視:サーバー保持ゼロのRAM内揮発性処理
調査対象となるPDF文書には、企業機密のソースコード、財務データ、未公開の契約書が含まれることが多いため、Webツールの安全性は最重要事項です。
AZ2PDFは、業界最高峰のセキュリティ基準を徹底しています:
- 揮発性RAM内のみでの完全処理: 文書の構文解析やストリーム展開はすべてサーバーの一時メモリ上で実行され、永続ストレージに保存されることはありません。
- 5分以内の自動完全消去: バックグラウンドデーモンが常時稼働し、処理後5分以内にすべてのメモリ領域を完全に破棄します。
- 登録不要&100%無料: メールアドレスや個人情報の入力は一切不要で、完全な匿名性が保護されます。
- 透かしなし: 生成されるPDFに広告ロゴやプロモーション文字列が挿入されることは一切ありません。
安全性に優れたAZ2PDFオンラインPDF総合プラットフォームを活用し、機密情報を外部に漏洩させることなく、高度なドキュメントエンジニアリング解析を行ってください。
❓ よくあるご質問(FAQ)
標準的なPDFファイルは、描画コマンドやフォント辞書をzlib Deflateアルゴリズム(/Filter /FlateDecode)で圧縮しているためです。テキストエディタがこの圧縮バイナリを通常の文字列として表示しようとするため文字化けが発生します。ストリームを解凍することで、人間が読めるテキスト構文に復元されます。
関連トピック記事
PDFのページ整理や高度なドキュメント管理の技術をさらに詳しく学びましょう。
PDFファイルを内容に基づいて無料で自動名前変更する方法(オンライン)
文書内容やメタデータのタイトルタグに基づいてPDFファイルをオンラインで無料自動リネームする方法を解説。スキャンデータや請求書を劣化なしで整理。

破損したPDFファイルをオンラインで修復する方法(無料&安全)
開けない、壊れたPDFファイルをオンラインで無料修復。破損した相互参照(xref)テーブルを再構築し、バイナリストリームから文書を安全に復元します。

スキャンしたPDFから空白ページを自動検出して削除する方法(無料・登録不要)
スキャンしたPDF内の余分な白紙ページをオンラインで自動検出して無料削除。両面スキャン時の空白ページを高画質のまま瞬時に整理します。
長期デジタル保存のためのPDFからISO標準PDF/Aへの変換方法
PDFドキュメントをISO 19005準拠のPDF/A形式にオンラインで無料変換。フォントの完全埋め込み、ICCカラープロファイルの標準化、法的証拠性の確保を解説。

無料でPDFにパスワードを設定して保護する方法(AES-256暗号化)
軍事レベルのAES-256暗号化を使用して、オンラインで安全かつ無料でPDFにパスワードを設定・保護する方法を解説。透かしなしで機密契約書や給与明細を保護。

パスワード付きPDFのロックをオンラインで解除する方法(セキュリティを恒久的に削除)
正当な権限を持つPDFの閲覧パスワードや印刷・コピー制限をオンラインで無料解除する方法を徹底解説。透かしなし・メモリ内暗号解除で完全保護。