Comment convertir un PDF en XML en ligne gratuitement (Données structurées avec coordonnées)
Réponse Directe & Points Clés
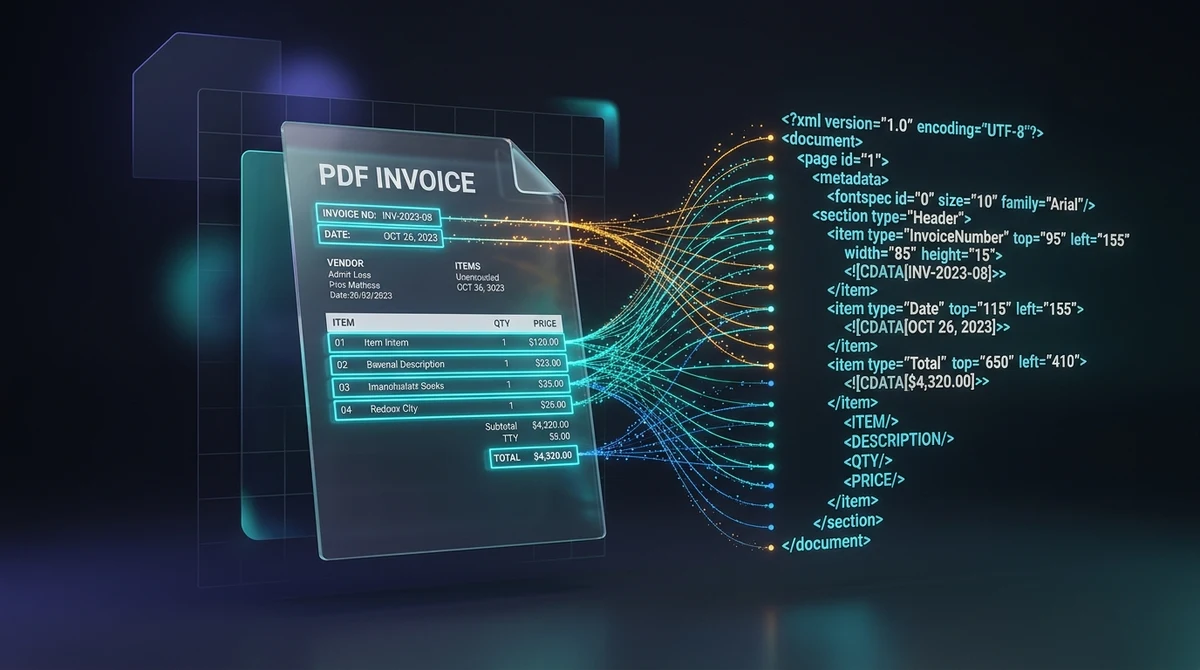
Pour convertir un PDF en XML en ligne gratuitement, vous transformez les mises en page visuelles en balises hiérarchiques Extensible Markup Language contenant des coordonnées spatiales absolues (top, left, width, height) et des spécifications de police. Grâce au convertisseur AZ2PDF, ingénieurs de données, développeurs et analystes extraient des nœuds de texte structurés lisibles par machine en quelques secondes, sans installation de logiciel, 100 % gratuit et en mémoire vive volatile.
- Préservation des coordonnées spatiales : Chaque élément de texte est doté d'attributs de boîte englobante (top, left, width, height) et de paramètres de police pour une extraction géométrique précise.
- Données hiérarchiques lisibles par machine : Transforme des pages rigides en nœuds XML structurés (page, fontspec, text) prêts pour l'ingestion automatique sous Python, Node.js et les progiciels ERP.
- Essentiel pour factures et pipelines ETL : Idéal pour analyser les relevés financiers multicolonnes, les factures B2B et les formulaires fiscaux sans rompre les relations spatiales.
- 100 % gratuit et traitement instantané en RAM : AZ2PDF traite vos fichiers directement dans la mémoire vive volatile sans frais, sans inscription, sans filigrane et avec purge automatique après 5 minutes.
Le problème de l'extraction de données : Pourquoi le PDF emprisonne l'information
Dans l'informatique d'entreprise moderne, le format Portable Document Format (PDF) est à la fois un standard incontournable et un obstacle majeur pour l'automatisation. Standardisé à l'échelle internationale sous la norme ISO 32000, le PDF excelle dans la fidélité de rendu : il verrouille les mots, les éléments vectoriels et les marges dans une réplique exacte d'une page imprimée. Sur un ordinateur, un smartphone ou une imprimante de bureau, le document reste parfaitement identique.
Cependant, ce qui rend le PDF parfait pour la lecture humaine le rend particulièrement difficile à traiter pour les ordinateurs. Un fichier PDF ne stocke pas d'arbre de données sémantique comme une table de base de données ou un tableur Excel. Il ne conçoit pas intrinsèquement ce qu'est une ligne, une colonne, un sous-total ou un numéro de facture. Il ne contient que des instructions de tracé graphique : des ordres bruts tels que dessiner cette chaîne de caractères aux coordonnées X=150, Y=720.
Lorsque des développeurs ou ingénieurs tentent d'extraire des informations avec des utilitaires classiques de récupération de texte, les problèmes surgissent :
- Les tableaux à colonnes multiples s'effondrent en un unique flux de texte désordonné.
- Les en-têtes, pieds de page et numéros de page s'intercalent de manière aléatoire au milieu des données métier.
- Les relations spatiales (comme savoir qu'un montant se trouve immédiatement sous une mention de taxe) disparaissent totalement.
Convertir votre document PDF en Extensible Markup Language (XML) structuré résout ce défi en capturant à la fois le texte et sa géométrie spatiale exacte dans une arborescence lisible par machine.
Qu'est-ce que la conversion PDF en XML et à quoi ressemble le résultat ?
La conversion de PDF en XML capture la disposition visuelle d'un document et la transcrit en un modèle objet XML rigoureusement structuré selon les DTD reconnues (telles que le standard Poppler pdf2xml). Au lieu d'extraire un texte brut et plat, le moteur regroupe les éléments par page, indexe les polices typographiques et marque chaque fragment de texte avec les coordonnées de sa boîte englobante.
Voici un extrait authentique de la syntaxe XML produite :
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Grâce à cette sortie organisée, vos scripts d'automatisation n'ont plus besoin d'extrapoler l'emplacement des informations. En analysant les attributs top, left, width et height, n'importe quel logiciel peut localiser instantanément les données en fonction de leurs coordonnées réelles.
Coordonnées spatiales : Comprendre top, left, width, height et fontspec
La valeur ajoutée majeure de l'extraction XML réside dans ses métadonnées géométriques. Comprendre ces attributs permet de concevoir des pipelines de traitement extrêmement fiables :
- Dimensions du canevas de page (<page>) : L'élément racine
<page>spécifie les dimensions de la page physique (commewidth="918" height="1188"en points typographiques), établissant la grille de coordonnées pour tous les nœuds enfants. - Déclarations typographiques (<fontspec>) : Le moteur répertorie toutes les polices utilisées dans le document et leur attribue un identifiant unique (
font="0",font="1"). Chaque balise<fontspec>définit la famille de police, la taille en points et la couleur hexadécimale, permettant de distinguer automatiquement les titres majeurs des notes de bas de page. - Coordonnées top et left : L'attribut
topindique la distance verticale depuis le bord supérieur de la page jusqu'à la ligne de base du texte. L'attributleftmesure le décalage horizontal depuis la marge gauche. - Attributs width et height : Ils précisent la largeur et la hauteur de la boîte englobante du bloc de texte, simplifiant le calcul des limites de colonnes et la vérification des alignements sur une même ligne horizontale.
- Balises typographiques en ligne : Le gras (
<b>) et l'italique (<i>) sont conservés directement au sein des nœuds de texte, facilitant l'identification des libellés et étiquettes clés.
Convertissez vos documents en jeux de données exploitables par machine grâce au convertisseur PDF en XML AZ2PDF, qui structure les coordonnées spatiales et la hiérarchie en balises XML standardisées.
Comment convertir un PDF en XML en ligne en 3 étapes simples
La conversion de documents PDF en code XML structuré se réalise en moins d'une minute directement dans votre navigateur web :
Étape 1 : Téléversez votre document PDF
Glissez-déposez votre facture PDF, relevé financier ou rapport technique dans la zone de dépôt, ou cliquez pour sélectionner le document sur votre appareil.
Étape 2 : Analyse automatique des données spatiales
Notre moteur haute performance analyse le flux d'objets PDF dans la mémoire vive volatile du serveur. Il cartographie les blocs de texte, calcule les géométries de contour, répertorie les dictionnaires de polices et génère un arbre XML conforme.
Étape 3 : Téléchargez votre fichier XML structuré
Cliquez sur Télécharger pour enregistrer votre fichier .xml. Vous pouvez l'ouvrir immédiatement dans votre éditeur favori (tel que VS Code) ou l'intégrer directement dans vos systèmes informatiques d'entreprise. Si vous devez simplement manipuler des données tabulaires simples, vous pouvez également découvrir comment convertir un PDF en CSV en ligne pour une exploitation directe sous Excel.
Cas d'usage stratégiques : Factures, pipelines ETL et entraînement de Document AI
La transformation de PDF en XML constitue le socle de flux d'automatisation majeurs dans de multiples secteurs d'activité :
- Traitement automatisé de factures fournisseurs : Les services comptables traitent des volumes considérables de factures avec des présentations variables. Les expressions régulières regex classiques échouent fréquemment. Avec le XML, les programmes ciblent des zones de coordonnées fixes (par exemple, extraire les données dans le quadrant supérieur droit où figurent numéro et date de facture).
- Pipelines ETL (Extract, Transform, Load) : Les entrepôts de données d'entreprise intègrent régulièrement bilans, déclarations d'assurance et rapports officiels. Le format XML offre une interopérabilité universelle, parfaitement compatible avec Apache Spark, Python Airflow et les bases de données SQL.
- Entraînement de modèles Document AI et LayoutLM : Les architectures de Deep Learning modernes sensibles à la mise en page nécessitent à la fois les jetons de texte et les boîtes 2D pour appréhender la structure des pages. Le XML fournit les données spatiales idéales pour entraîner ces modèles.
- Échange de données informatisé B2B (EDI) : Les progiciels de gestion intégrés (SAP, Oracle) requièrent des données structurées pour automatiser les commandes. Convertir les bons de commande PDF en XML crée une passerelle fluide entre le document humain et l'ERP.
Analyse pratique : Utiliser Python, lxml et XPath sur votre fichier XML
Une fois votre fichier XML téléchargé, l'écriture d'un script d'extraction en Python est particulièrement intuitive. La bibliothèque lxml associée aux requêtes XPath permet de filtrer précisément les nœuds selon leurs coordonnées :
from lxml import etree

# Charger et analyser le fichier XML généré
tree = etree.parse("facture.xml")
root = tree.getroot()

# Extraire tous les éléments textuels situés dans une zone de coordonnées définie
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
En combinant judicieusement @top, @left et @font, vous créez des règles d'extraction stables qui résistent aux légères variations de mise en page.
Dépannage : Documents numérisés, OCR et confidentialité en mémoire vive
Pour assurer le bon déroulement de vos processus automatisés, tenez compte de ces recommandations techniques :
1. Documents numérisés sans couche textuelle numérique
Si votre PDF provient d'un scanner ou d'un télécopieur sans reconnaissance optique de caractères, le fichier ne contient que des images bitmap. Le convertisseur extrayant le texte vectoriel natif, un PDF contenant uniquement des images produira un fichier XML vide. Pour y remédier, consultez notre tutoriel pour extraire le texte d'un PDF avec OCR afin d'intégrer une couche de texte numérique avant la conversion en XML.
2. Gestion des archives volumineuses multi-pages
Sur des documents de plusieurs centaines de pages, le XML peut devenir volumineux en raison de la répétition des attributs de position. Pensez à utiliser des méthodes de compression comme Gzip pour leur stockage et transmission réseau.
3. Confidentialité absolue et traitement en mémoire RAM
Factures, contrats commerciaux et dossiers financiers contiennent des informations confidentielles stratégiques. Notre service applique les normes de sécurité les plus rigoureuses :
- Traitement éphémère en mémoire RAM : L'analyse syntaxique et la génération de l'arbre XML s'exécutent strictement dans la mémoire vive volatile du serveur, sans écriture sur disque dur permanent.
- Purge automatique après 5 minutes : Un processus d'arrière-plan efface définitivement tous les tampons de traitement cinq minutes au maximum après la fin de l'opération.
- Gratuité intégrale sans compte utilisateur : Aucune adresse e-mail ni coordonnée bancaire n'est requise, préservant votre anonymat total.
- Aucun filigrane promotionnel : Votre fichier XML est rigoureusement conforme aux normes DTD officielles.
Découvrez l'ensemble de nos utilitaires haute performance sur la boîte à outils de traitement PDF technique AZ2PDF directement depuis votre navigateur web.
❓ Foire Aux Questions (FAQ)
La conversion en texte brut élimine toute information spatiale, regroupant colonnes et titres en un flux linéaire confus. Le CSV impose une grille tabulaire stricte. Le format XML préserve l'emplacement physique exact de chaque mot sur la page grâce aux attributs de boîte englobante (top, left, width, height), permettant à vos programmes d'extraire les données par zone géographique indépendamment de la mise en page.
Articles Liés à ce Sujet
Découvrez d'autres techniques professionnelles d'organisation de pages et de gestion documentaire.
Comment convertir un PDF en CSV en ligne gratuitement (extraction propre de tableaux)
Apprenez à convertir des tableaux PDF en fichiers CSV propres et structurés en ligne et gratuitement. Extrayez relevés bancaires et factures sans décalage de colonnes.
Comment convertir un PDF en texte en ligne gratuitement (extraction TXT propre)
Découvrez comment extraire du texte brut non formaté à partir de fichiers PDF en ligne gratuitement. Convertissez vos pages en fichiers TXT UTF-8 sans erreur.

Comment extraire du texte d'un PDF scanné avec l'OCR (Gratuit & Privé)
Découvrez comment convertir des documents papier numérisés et des PDF photo en texte sélectionnable et consultable grâce à l'OCR multilingue gratuit. Rapide, précis et 100 % confidentiel dans votre navigateur.
Comment convertir un PDF en HTML en ligne gratuitement (code propre et mise en page)
Apprenez a convertir vos documents PDF en pages web HTML5 et CSS responsives en ligne et gratuitement. Conservez polices, styles et graphismes sans filigrane.
Comment convertir des fichiers HTML en PDF en ligne sans perte de mise en page
Apprenez à convertir gratuitement en ligne vos fichiers HTML et styles CSS en documents PDF prêts pour l'impression. Polices exactes, sauts de page et mise en page sans filigrane.
Comment convertir un PDF en EPUB en ligne gratuitement (texte ajustable pour liseuse)
Découvrez comment convertir des documents PDF en e-books EPUB à mise en page fluide en ligne gratuitement. Lisez confortablement sur Kindle, Kobo et Apple Books.