Cách làm sạch file PDF và xóa siêu dữ liệu ẩn (Miễn phí & Bảo mật)
Câu Trả Lời Trực Tiếp & Điểm Cốt Lõi
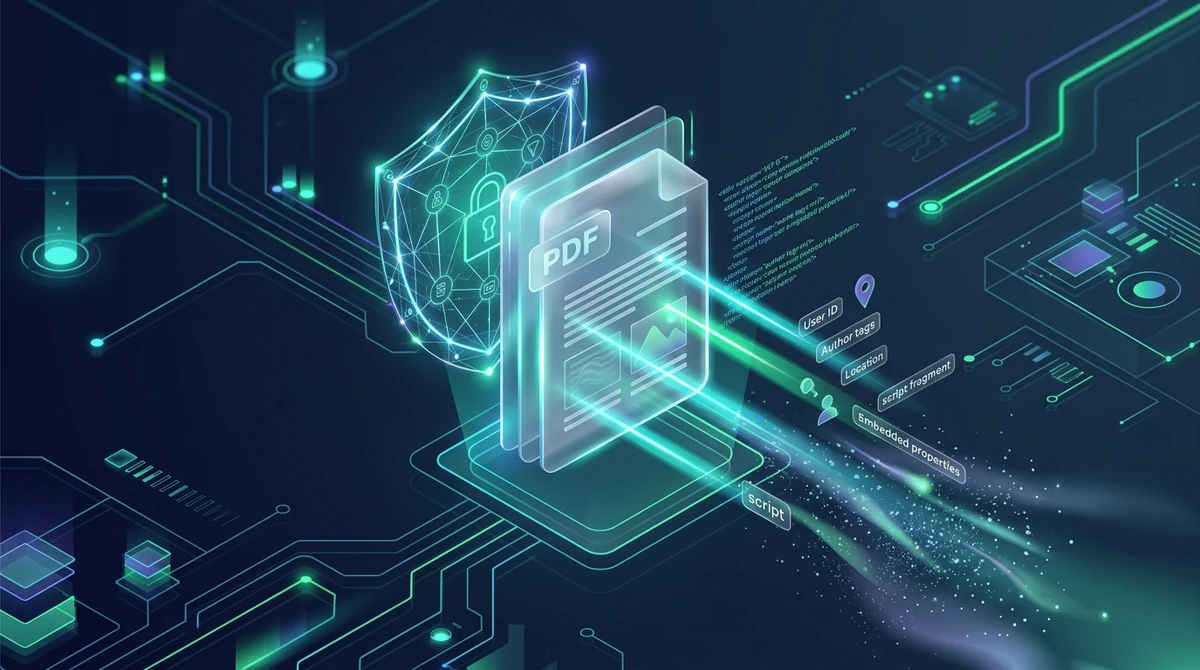
Để làm sạch file PDF, hệ thống thực thi quy trình tẩy rửa cấp độ nhị phân nhằm loại bỏ vĩnh viễn từ điển thông tin tài liệu (/Info), luồng XML nền tảng siêu dữ liệu mở rộng (/Metadata), các macro JavaScript nhúng, lệnh tự động kích hoạt (/OpenAction) và tệp đính kèm bí mật. Với công cụ Làm sạch PDF của AZ2PDF, quá trình này diễn ra an toàn trong bộ nhớ RAM tạm thời, tạo ra tài liệu ẩn danh hoàn hảo và tự hủy dữ liệu sau 5 phút.
- Nguy cơ lộ dữ liệu vô hình: File PDF thông thường ngầm lưu tên tác giả, tài khoản người dùng máy tính, đường dẫn mạng nội bộ, tọa độ GPS và toàn bộ lịch sử chỉnh sửa phần mềm.
- Triệt tiêu các vector mã độc: Quy trình làm sạch sâu loại bỏ triệt để các tập lệnh JavaScript nhúng nguy hiểm, lệnh mở tự động (/OpenAction) và tệp đính kèm ngầm có thể gây hại cho hệ thống người nhận.
- Phân biệt làm sạch (Sanitize) và che dữ liệu (Redact): Che dữ liệu xóa văn bản hiển thị trên trang, trong khi làm sạch triệt tiêu siêu dữ liệu ngầm và đối tượng thực thi phía sau. Quy trình bảo mật tối đa đòi hỏi kết hợp cả hai.
- Hoàn toàn miễn phí và riêng tư: Tẩy sạch hồ sơ pháp lý, tài liệu mật doanh nghiệp và báo cáo tài chính mà không lưu nhật ký máy chủ, không dấu mờ và tự động xóa khỏi bộ nhớ RAM sau 5 phút.
Cấu trúc bên trong file PDF: Giải phẫu từ điển Info và luồng XML XMP
Để hiểu lý do vì sao những thao tác thủ công đơn giản như xóa tên tác giả trong thuộc tính ứng dụng đọc PDF thường thất bại, chúng ta cần tìm hiểu kiến trúc phân tầng của tiêu chuẩn quốc tế ISO 32000 dành cho định dạng tài liệu di động (PDF). Một tệp PDF không phải là một bức ảnh phẳng; đó là một cơ sở dữ liệu hướng đối tượng phức hợp, được tổ chức thành các luồng phân cấp và bảng tham chiếu chéo (XRef).
Siêu dữ liệu trong file PDF hiện đại được lưu trữ qua hai cơ chế kiến trúc chủ đạo:
1. Từ điển thông tin tài liệu (/Info)
Kế thừa từ các đặc tả PDF ban đầu, từ điển /Info nằm trực tiếp ở phần đuôi tài liệu (trailer) hoặc danh mục gốc (catalog). Nó chứa các cặp khóa - giá trị định nghĩa các thông số cơ bản:
/Author: Tên đã đăng ký của người dùng máy tính tạo ra tài liệu./Titlevà/Subject: Tiêu đề công việc và phân loại chủ đề của văn bản./Creator: Ứng dụng mẹ đã tạo ra tài liệu gốc (như Microsoft Word hoặc Apple Pages)./Producer: Thư viện hoặc công cụ chuyển đổi đã biên dịch luồng nhị phân (như Adobe PDF Library, Skia hoặc Quartz)./CreationDatevà/ModDate: Dấu thời gian mật mã chính xác kèm theo độ lệch múi giờ khu vực.
Mặc dù một số phần mềm máy tính cho phép bạn sửa đổi các trường văn bản này, việc chỉnh sửa bằng tay chỉ cập nhật các khóa hiển thị bên ngoài mà không làm sạch được các tầng dữ liệu cấu trúc ngầm bên trong.
2. Luồng XML nền tảng siêu dữ liệu mở rộng (/Metadata)
Được Adobe phát triển và chuẩn hóa theo ISO 16684-1, nền tảng Extensible Metadata Platform (XMP) nhúng trực tiếp các gói XML có cấu trúc vào danh mục PDF và các luồng đối tượng riêng lẻ. Các gói XMP có thể gắn liền với toàn bộ tài liệu, từng trang đơn lẻ, hình vẽ vector hoặc ảnh raster nhúng.
Các lược đồ XMP lưu trữ lịch sử chỉnh sửa chi tiết, hồ sơ màu sắc, thông tin bản quyền phông chữ, định danh quản lý tài sản số và dữ liệu EXIF máy ảnh. Do siêu dữ liệu XMP được mã hóa dưới dạng các luồng XML thô bên trong bộ lọc nén FlateDecode, các trình xem PDF thông thường không hiển thị thông tin này trong bảng thuộc tính, khiến các dấu vết nhạy cảm hoàn toàn không bị người dùng thông thường phát hiện.
3. Lịch sử sửa đổi đính kèm và các đối tượng mồ côi
Khi bạn chỉnh sửa tài liệu trong các ứng dụng máy tính truyền thống và nhấn nút Lưu, nhiều phần mềm thực hiện cơ chế cập nhật gia tăng (incremental update). Thay vì ghi đè toàn bộ tệp nhị phân, ứng dụng chỉ ghi thêm các thay đổi vào cuối tệp hiện có và cập nhật bảng tham chiếu chéo (xref).
Hệ quả là, các đoạn văn bản đã xóa trước đó, tên tác giả cũ và các con số mật chưa che chắn vẫn tồn tại nguyên vẹn bên trong các đối tượng cũ không còn tham chiếu ở phần đầu luồng byte. Một người nhận am hiểu công nghệ chỉ cần mở tệp bằng trình soạn thảo mã hexa hoặc phần mềm điều tra số là có thể khôi phục lại toàn bộ dữ liệu tưởng chừng đã biến mất.
Các thành tố động nguy hiểm: Vì sao JavaScript và lệnh kích hoạt đe dọa bảo mật
Làm sạch file PDF có phạm vi bảo vệ rộng hơn nhiều so với việc chỉ xóa tên tác giả. Trong môi trường doanh nghiệp và các tổ chức có yêu cầu bảo mật cao, tài liệu PDF không rõ nguồn gốc thường bị lợi dụng làm phương tiện phát tán mã độc, thu thập thông tin xác thực và khai thác lỗ hổng bảo mật zero-day.
Đặc tả định dạng PDF hỗ trợ các thành tố động có khả năng tự động thực thi tác vụ ngay khi mở tài liệu:
1. Macro JavaScript nhúng (/JS và /JavaScript)
Định dạng PDF hỗ trợ một tập con chuyên dụng của ngôn ngữ JavaScript (Acrobat JavaScript API) nhằm tự động hóa kiểm tra dữ liệu biểu mẫu, định dạng tiền tệ và điều khiển giao diện. Tuy nhiên, tin tặc thường lợi dụng JavaScript nhúng để tấn công tràn bộ nhớ đệm (heap-spray), khai thác lỗi trong các trình đọc PDF chưa được vá lỗi, hoặc âm thầm chuyển hướng người dùng đến các trang web giả mạo độc hại.
2. Lệnh kích hoạt hành động tự động (/OpenAction và /AA)
Từ điển PDF có thể khai báo khóa /OpenAction hoặc các Hành Động Bổ Sung (/AA) gắn liền với sự kiện mở trang, đóng trang hoặc nhấp vào mục lục. Những hành động này tự động thực thi ngay khoảnh khắc mở tệp mà không cần người dùng thao tác. Trong các cuộc tấn công phức tạp, lệnh /OpenAction có thể kích hoạt chỉ thị /Launch để chạy tập lệnh hoặc phần mềm ngoài trên hệ điều hành máy nạn nhân, hoặc gửi dữ liệu nội bộ đến máy chủ trái phép thông qua hành động /SubmitForm.
3. Tệp đính kèm bí mật (/EmbeddedFiles)
Khung chứa PDF có thể lưu giữ các tệp đính kèm tùy ý bên trong cây định danh /EmbeddedFiles. Mặc dù doanh nghiệp dùng tính năng này để đính kèm bảng tính hoặc bản vẽ kỹ thuật vào báo cáo tổng kết, kẻ tấn công có thể lợi dụng để giấu các tệp thực thi batch file (.bat), VBScript (.vbs) hoặc tài liệu Office chứa mã độc bên trong một file PDF trông có vẻ vô hại nhằm vượt qua các bộ lọc quét email truyền thống.
Quy trình làm sạch PDF chuẩn mực sẽ quét toàn bộ cây đối tượng của tài liệu, định vị và bóc tách triệt để các mục từ điển /JavaScript, /JS, /OpenAction, /AA, /Launch, /SubmitForm và /EmbeddedFiles, vô hiệu hóa hoàn toàn mọi hiểm họa động trước khi chuyển tệp cho khách hàng hoặc đối tác.
Làm sạch siêu dữ liệu so với Che dữ liệu hiển thị: Hiểu rõ sự khác biệt cốt tử
Một trong những hiểu lầm phổ biến nhất trong bảo mật tài liệu số là nhầm lẫn giữa làm sạch siêu dữ liệu (Sanitization) và che dữ liệu hiển thị (Redaction). Mặc dù cả hai phương pháp đều bảo vệ thông tin mật, chúng can thiệp vào các tầng hoàn toàn khác nhau của cấu trúc tài liệu.
Dưới đây là so sánh đối chiếu giữa hai kỹ thuật này:
- Che dữ liệu số tác động lên tầng hiển thị trực quan: Che dữ liệu là thao tác cắt bỏ vĩnh viễn các ký tự văn bản, biểu đồ và điểm ảnh nhìn thấy được trên trang. Khi bạn che dữ liệu bằng các giải pháp chuyên nghiệp, hệ thống sẽ xóa các mã ký tự khỏi luồng nội dung trang và vẽ một khối vector mờ đục đè lên khu vực vừa xóa, ngăn chặn mắt người, trình đọc màn hình và lệnh sao chép lấy cắp thông tin bí mật.
- Làm sạch tài liệu tác động lên tầng cấu trúc và siêu dữ liệu: Làm sạch không thay đổi cách bố trí văn bản nhìn thấy trên trang. Thay vào đó, nó quét toàn bộ hạ tầng ngầm của file, loại bỏ các thuộc tính tác giả, luồng XMP, tệp đính kèm ẩn, lệnh kích hoạt và dấu vết sửa đổi tích lũy.
Quy tắc an toàn bất di bất dịch: Che văn bản trên trang không xóa bỏ siêu dữ liệu tác giả hay tọa độ GPS của ảnh chụp. Ngược lại, làm sạch file không che đi số CMND/CCCD hay số tài khoản ngân hàng in đậm trên trang 2. Để bảo mật toàn diện trước khi phát hành công khai, quy trình chuẩn đòi hỏi thực hiện che dữ liệu hiển thị trước, sau đó tiến hành làm sạch sâu siêu dữ liệu.
Sau khi các dấu vết tác giả cũ và chữ ký phần mềm bị xóa bỏ, bạn có thể dễ dàng điền siêu dữ liệu chuẩn hóa mới cho tài liệu để thiết lập bản quyền doanh nghiệp và từ khóa tra cứu được phê duyệt.
Hướng dẫn làm sạch PDF và xóa siêu dữ liệu qua 3 bước đơn giản
Bước 1: Tải tài liệu PDF của bạn lên
Truy cập công cụ Làm sạch PDF trên trình duyệt web của bạn trên Mac, Windows, Linux, iOS hoặc Android. Kéo và thả tài liệu vào vùng tải lên, hoặc nhấp để chọn tệp từ máy tính. Nền tảng AZ2PDF hoàn toàn miễn phí, hỗ trợ tài liệu dung lượng lớn và không giới hạn số trang.
Bước 2: Quét nhị phân chuyên sâu và tẩy sạch siêu dữ liệu
Động cơ phân tích cú pháp sẽ duyệt qua mô hình đối tượng PDF trong vùng nhớ RAM cô lập. Hệ thống tuần tự xóa bỏ từ điển /Info, thanh lọc toàn bộ các gói siêu dữ liệu XMP nhúng, loại bỏ các nhánh mã lệnh /JavaScript và /JS, xóa bỏ lệnh tự động chạy /OpenAction và bóc tách các tệp đính kèm. Sau đó, động cơ tái cấu trúc bảng tham chiếu chéo, loại bỏ mọi đối tượng mồ côi và lịch sử sửa đổi cũ.
Bước 3: Tải về tài liệu ẩn danh đã được tăng cường bảo mật
Nhấp vào nút Tải Về để lưu file PDF đã làm sạch trực tiếp về thiết bị của bạn. Tài liệu thu được hiển thị hoàn toàn giống nguyên bản trên màn hình, nhưng toàn bộ dấu vết tác giả ẩn, thông tin nhận diện doanh nghiệp và nguy cơ thực thi mã độc đã được thanh trừng vĩnh viễn.
Quyền riêng tư và tuân thủ: Kiến trúc không lưu dữ liệu cho hồ sơ pháp lý và y tế
Các tài liệu cần làm sạch thường là những hồ sơ tối mật của tổ chức: hợp đồng mua bán sáp nhập, chứng cứ kiện tụng tại tòa, báo cáo nghiên cứu độc quyền hoặc bệnh án y tế được quản lý theo tiêu chuẩn HIPAA.
Nhiều dịch vụ chuyển đổi trực tuyến kiểu cũ thường lưu trữ tài liệu đã tải lên trên các ổ cứng đám mây từ xa trong nhiều giờ hoặc nhiều ngày. Việc truyền tải hồ sơ pháp lý cơ mật hoặc dữ liệu bệnh nhân đến các máy chủ chưa được kiểm chứng sẽ tạo ra rủi ro nghiêm trọng về tuân thủ pháp lý theo các quy định HIPAA, Điều 32 GDPR và nghĩa vụ giữ bí mật giữa luật sư và thân chủ.
Đó là lý do các công cụ PDF trực tuyến trên AZ2PDF được xây dựng theo kiến trúc Không Lưu Trữ Dữ Liệu (Zero Data Retention) nghiêm ngặt:
- Xử lý thuần túy trong bộ nhớ RAM tạm thời: Tài liệu được tiếp nhận và xử lý hoàn toàn bên trong các bộ đệm RAM khả biến. Nội dung tệp tuyệt đối không bao giờ bị ghi vào ổ đĩa lưu trữ vĩnh viễn hay cơ sở dữ liệu dài hạn.
- Tiến trình dọn dẹp bộ nhớ tự động sau 5 phút: Một tiến trình daemon chuyên trách liên tục giám sát bộ đệm, xóa vĩnh viễn toàn bộ dữ liệu tạm thời của phiên làm việc trong vòng 5 phút sau khi hoàn tất, hoặc ngay khi người dùng tải tệp về thành công.
- Tuyệt đối không thu thập dữ liệu: AZ2PDF không bao giờ đọc, lập chỉ mục, chia sẻ hay lưu giữ dữ liệu tài liệu của bạn, và các tệp của bạn tuyệt đối không được dùng để huấn luyện các mô hình trí tuệ nhân tạo.
So sánh các giải pháp: AZ2PDF vs. Adobe Acrobat Pro vs. cách in ảo Print-to-PDF
Khi cần làm sạch văn bản trước khi công bố ra bên ngoài, các phương pháp tiếp cận khác nhau mang lại sự cân bằng riêng biệt về tính an toàn, độ thuận tiện và chi phí:
Phương án 1: Công cụ Làm sạch PDF trên AZ2PDF (Khuyên dùng)
Giải pháp nhanh nhất và dễ tiếp cận nhất cho các phòng ban pháp lý, nhà quản lý và cá nhân. AZ2PDF thực hiện làm sạch nhị phân chuyên sâu, thanh lọc cả từ điển /Info lẫn các gói XML XMP, đồng thời vô hiệu hóa JavaScript và lệnh tự mở. Công cụ hoàn toàn miễn phí 100%, không yêu cầu đăng ký tài khoản, chạy tức thì trên mọi hệ điều hành và bảo đảm quyền riêng tư tuyệt đối nhờ cơ chế tự hủy dữ liệu trong RAM.
Phương án 2: Tính năng Sanitize Document trên Adobe Acrobat Pro
Adobe Acrobat Pro cung cấp tính năng làm sạch tài liệu toàn diện trong menu Bảo vệ. Mặc dù có năng lực kỹ thuật tốt, Acrobat Pro đòi hỏi cài đặt gói phần mềm nặng hàng gigabyte trên máy tính và yêu cầu trả phí định kỳ vượt mức 239 USD mỗi năm. Với nhu cầu làm sạch tài liệu định kỳ hoặc các đội ngũ không có ngân sách bản quyền Adobe doanh nghiệp, chi phí này rất khó để biện minh.
Phương án 3: Cách làm tắt qua lệnh in ảo Print to PDF
Nhiều nhân viên văn phòng cố gắng gỡ bỏ siêu dữ liệu bằng cách mở file PDF và in ra máy in ảo (như Microsoft Print to PDF hoặc Save as PDF trên macOS). Mặc dù phương pháp này có thể xóa bỏ siêu dữ liệu gốc, nó lại gây ra nhiều tác dụng phụ tai hại:
- Làm suy giảm chất lượng hiển thị do nén lại các phông chữ vector thành ảnh raster mờ nét.
- Phá hủy toàn bộ mục lục tương tác, liên kết trang nội bộ và siêu liên kết web có thể nhấp được.
- Thường xuyên tự động chèn thêm siêu dữ liệu mới từ trình quản lý in của hệ điều hành, bao gồm tên đăng nhập máy tính và ngày giờ in ấn.
- Chậm chạp và tiêu tốn nhiều tài nguyên khi xử lý các tài liệu báo cáo nhiều trang.
Thanh lọc toàn diện các dấu vết theo dõi ngầm trong tài liệu số với nền tảng tài liệu bảo mật AZ2PDF, bảo đảm an toàn vận hành tối đa thông qua các thuật toán làm sạch chuẩn hóa trên trình duyệt.
Xử lý nhanh các tình huống phát sinh thường gặp khi làm sạch PDF
Nếu bạn gặp phải những kết quả chưa mong muốn khi làm sạch và phân phối tài liệu bảo mật, dưới đây là các giải pháp thực tế cho từng trường hợp:
1. Các con số nhạy cảm hoặc tên riêng vẫn còn nhìn thấy trên trang
Hãy lưu ý rằng quy trình làm sạch nhắm vào siêu dữ liệu ẩn và mã nguồn ngầm, không tác động lên văn bản hiển thị. Nếu số tài khoản hoặc tên khách hàng vẫn in rõ trên trang, bạn cần sử dụng công cụ che dữ liệu để đặt các thanh che màu đen vĩnh viễn lên tọa độ văn bản đó trước khi tiến hành làm sạch siêu dữ liệu.
2. Các trường biểu mẫu tương tác ngừng tự động tính toán
Nếu file PDF của bạn từng chứa các kịch bản tính toán tự động (như đơn đặt hàng tự cộng tổng tiền), quá trình làm sạch sẽ chủ động loại bỏ các macro JavaScript để triệt tiêu nguy cơ mã độc. Nếu bạn muốn các giá trị biểu mẫu được giữ nguyên cố định ở dạng tĩnh, hãy dùng công cụ làm phẳng PDF để khóa vĩnh viễn các trường nhập liệu và chữ ký.
3. Chữ ký số báo không hợp lệ sau khi làm sạch
Chữ ký số mật mã học phụ thuộc vào mã băm (hash) nhị phân chuẩn xác của toàn bộ tệp tài liệu. Vì thao tác làm sạch sẽ bóc tách các luồng siêu dữ liệu và tái cấu trúc bảng tham chiếu chéo, mã băm của tệp sẽ thay đổi, khiến mọi chữ ký số ký trước đó bị vô hiệu hóa. Do đó, bạn hãy luôn làm sạch tài liệu nháp trước, rồi mới áp dụng chữ ký số ở bước hoàn thiện cuối cùng.
4. Cần khóa quyền hạn tài liệu sau khi xóa siêu dữ liệu
Làm sạch chỉ gỡ bỏ siêu dữ liệu nội bộ nhưng vẫn để ngỏ tài liệu cho các thao tác chỉnh sửa tiếp theo. Nếu muốn ngăn chặn người nhận sửa đổi văn bản hoặc trích xuất trang sau khi gửi, hãy thiết lập mã hóa AES-256 tiêu chuẩn quân sự để bảo vệ tệp.
5. Dung lượng tệp vẫn còn lớn sau khi làm sạch
Xóa siêu dữ liệu chỉ loại bỏ vài chục kilobyte dữ liệu XML, nhưng các bức ảnh độ phân giải cao được nhúng bên trong vẫn chiếm phần lớn dung lượng. Nếu cần gửi file qua email với giới hạn đính kèm khắt khe, hãy tối ưu hóa tệp qua tiện ích nén PDF để giảm kích thước hình ảnh mà không làm mờ nét chữ.
❓ Câu Hỏi Thường Gặp
Không. Quá trình làm sạch chỉ can thiệp vào tầng cấu trúc phi trực quan của tài liệu, bao gồm các thuộc tính siêu dữ liệu, tập lệnh nhúng, gói XML và tệp đính kèm ngầm. Để xóa tên riêng hoặc số liệu hiển thị trên trang in, bạn cần sử dụng tính năng che dữ liệu chuyên dụng trước khi làm sạch.
Bài Viết Cùng Chủ Đề Liên Quan
Khám phá các kỹ thuật tổ chức trang và quản lý tài liệu PDF chuyên nghiệp.

Cách mở khóa và xóa mật khẩu file PDF trực tuyến (Gỡ bảo vệ vĩnh viễn)
Hướng dẫn cách mở khóa và xóa mật khẩu bảo vệ file PDF trực tuyến miễn phí. Giải mã quyền in ấn, sao chép văn bản an toàn, không watermark, bảo mật tuyệt đối.
Cách che xóa vĩnh viễn thông tin nhạy cảm trong PDF miễn phí
Hướng dẫn che xóa vĩnh viễn thông tin nhạy cảm, số CCCD, tài khoản ngân hàng trong file PDF trực tuyến miễn phí. Hủy byte dữ liệu nhị phân không thể phục hồi.
Cách tự động che thông tin nhạy cảm trong PDF miễn phí (Làm sạch PII)
Hướng dẫn tự động che xóa thông tin nhạy cảm PII, số CCCD, thẻ tín dụng, email trong file PDF miễn phí. Nhận diện biểu thức chính quy siêu tốc, không rò rỉ dữ liệu.

Cách đặt mật khẩu bảo vệ file PDF miễn phí (Mã hóa chuẩn quân sự AES-256)
Hướng dẫn cách đặt mật khẩu và mã hóa file PDF trực tuyến miễn phí bằng chuẩn mã hóa AES-256 cấp ngân hàng. Bảo vệ hợp đồng, sao kê lương tuyệt đối an toàn.

Cách làm phẳng biểu mẫu và chú thích PDF vĩnh viễn
Tìm hiểu cách làm phẳng trường biểu mẫu PDF, dấu tích, chữ ký và chú thích thành các lớp in cố định. Chống sửa đổi trái phép và hiển thị chuẩn xác 100%.
Cách so sánh hai file PDF tìm điểm khác biệt trực tuyến miễn phí (chuẩn xác & bảo mật)
Hướng dẫn so sánh hai file PDF trực tuyến miễn phí. Phát hiện từng thay đổi câu chữ, điều khoản hợp đồng và sai lệch bố cục bằng trực quan mà không cần Adobe Acrobat.