Hur man konverterar PDF till XML online gratis (strukturerad data med koordinater)
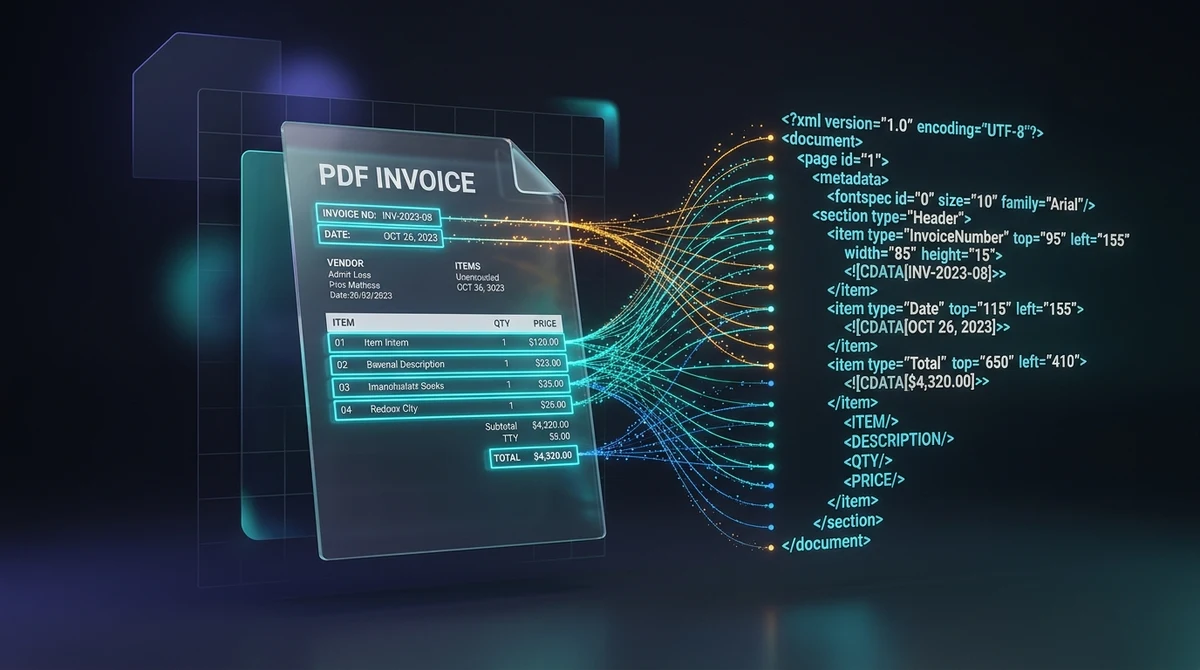
Direktsvar & Viktiga Slutsatser
Att konvertera PDF till XML online gratis innebär att omvandla visuella dokumentlayouter till hierarkiska Extensible Markup Language-taggar med absoluta rumsliga koordinater (top, left, width, height) och typsnittsegenskaper. Med AZ2PDF-konverteraren kan dataingenjörer och utvecklare extrahera maskinläsbara strukturerade textnoder på några sekunder, 100 % gratis och säkert i serverns flyktiga RAM-minne.
- Bevara rumsliga koordinater: Varje textelement förses med exakta bounding box-attribut (top, left, width, height) och typsnittsspecifikationer för precis koordinatbaserad extraktion.
- Maskinläsbar hierarkisk data: Förvandlar stela visuella sidor till strukturerade XML-noder (page, fontspec, text) redo för automatiserad inläsning i Python, Node.js och ERP-system.
- Oumbärligt för fakturor och ETL-flöden: Perfekt för att tolka flerkolumniga finansiella rapporter, B2B-fakturor och skatteblanketter utan att förlora geometriska relationer.
- 100 % gratis med direkt in-memory-bearbetning: AZ2PDF bearbetar dina filer direkt i serverns flyktiga RAM utan avgifter, utan konto, utan vattenstämplar och med automatisk radering inom 5 minuter.
Problemet med dataextraktion: Varför PDF låser in affärsinformation
Inom modern IT är Portable Document Format (PDF) både en oumbärlig visningsstandard och ett av de största hindren för dataautomatisering. Standardiserat under ISO 32000 utmärker sig PDF genom visuell precision: det låser fast ord, vektorgrafik och sidmarginaler i en exakt digital kopia av ett fysiskt papper. Oavsett om det visas på en bärbar dator, telefon eller skrivare ser dokumentet identiskt ut.
Det som gör PDF idealiskt för mänskliga ögon gör det dock besvärligt för programvara. En PDF-fil lagrar inte semantiska dataträd som en databas eller ett kalkylark. Filen förstår inte vad en rad, kolumn, delsumma eller ett fakturanummer är, utan innehåller bara grafiska ritkommandon: explicita instruktioner som rita denna teckensträng vid koordinaten X=150, Y=720.
När utvecklare eller dataingenjörer försöker extrahera data med enkla textdumpverktyg uppstår välkända problem:
- Tabeller med flera kolumner kollapsar till ett enda oordnat textflöde.
- Sidhuvuden, sidfötter och sidnummer blandas godtyckligt in mellan dataraderna.
- Rumsliga relationer (som att ett belopp står precis under en momsrubrik) går helt förlorade.
Att konvertera PDF till strukturerad Extensible Markup Language (XML) löser detta genom att bevara både textinnehållet och dess exakta tvådimensionella geometri i en maskinläsbar hierarki.
Vad är PDF till XML-konvertering och hur ser utdata ut?
PDF till XML-konvertering analyserar dokumentets visuella layout och översätter den till en strukturerad XML-objektmodell enligt etablerade DTD-standarder (såsom Poppler pdf2xml). Istället för att bara dumpa text platt grupperar motorn element per sida, katalogiserar typsnittsegenskaper och förser varje textfragment med koordinater för dess bounding box.
Här är ett autentiskt utdrag ur den resulterande XML-strukturen:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Tack vare denna ordnade struktur behöver automatiserade skript inte längre gissa var data finns. Genom att läsa av attributen top, left, width och height kan programvaran lokalisera data med utgångspunkt i dess faktiska position på arket.
Rumsliga koordinater: Förstå top, left, width, height och fontspec
Styrkan med XML-extraktion ligger i de rika geometriska metadata som tillhandahålls. Att behärska dessa attribut gör det möjligt att bygga robusta dataflöden:
- Sidans dimensioner (<page>): Rotelementet
<page>anger det fysiska sidmåttet (t.ex.width="918" height="1188"i standardpunkter), vilket skapar koordinatsystemet för alla underordnade element. - Typsnittsdeklarationer (<fontspec>): Parsern indexerar alla typsnitt som förekommer och tilldelar unika ID:n (
font="0",font="1"). Varje<fontspec>beskriver teckensnittsfamilj, punktstorlek och färgkod, vilket gör det enkelt för skript att skilja rubriker från fotnoter. - top- och left-koordinater:
topanger det vertikala avståndet från sidans överkant till textens baslinje, medanleftanger det horisontella avståndet från vänstermarginalen. - width- och height-attribut: Dessa definierar bredd och höjd för textens bounding box, vilket underlättar beräkning av kolumnbredder och kontroll av radjusteringar.
- Inline-stiltaggar: Fetstil (
<b>) och kursiv stil (<i>) bevaras direkt i textnoderna, vilket hjälper till att identifiera viktiga rubriker och etiketter.
Konvertera dokument till strukturerade maskinläsbara dataset med AZ2PDF:s PDF till XML-konverterare, som sparar koordinater och hierarkier i standardiserade XML-taggar.
Hur man konverterar PDF till XML online i 3 enkla steg
Att konvertera PDF-dokument till strukturerad XML görs på under en minut direkt i din webbläsare:
Steg 1: Ladda upp ditt PDF-dokument
Dra och släpp din faktura, finansiella rapport eller tekniska specifikation i uppladdningsrutan, eller klicka för att välja filen från din enhet.
Steg 2: Automatisk analys av rumslig data
Vår högpresterande motor analyserar PDF-strukturen direkt i serverns flyktiga RAM. Den mappar textblock, beräknar koordinater, registrerar typsnitt och skapar ett giltigt XML-träd.
Steg 3: Ladda ner din strukturerade XML-fil
Klicka på Ladda ner för att spara din .xml-fil. Du kan genast öppna den i kodredigerare eller integrera den i dina interna system utan krav på konto. Behöver du istället hantera enklare tabeller kan du lära dig hur du konvertera PDF till CSV online för direkt import till kalkylblad.
Viktiga användningsområden: Fakturor, ETL-pipelines och Document AI-träning
Konvertering från PDF till XML utgör grunden för automatiserad stordatahantering inom många områden:
- Automatiserad fakturahantering: Ekonomiavdelningar hanterar tusentals leverantörsfakturor varje månad med olika layouter. Reguljära uttryck (regex) fallerar ofta vid förändringar. Med XML kan skript rikta in sig på specifika koordinatzoner (t.ex. det övre högra hörnet för fakturanummer och förfallodatum).
- ETL-pipelines (Extract, Transform, Load): Datalager tar regelbundet emot kvartalsrapporter och blanketter. XML erbjuder ett neutralt standardformat som integreras sömlöst med Apache Spark, Python Airflow och relationsdatabaser.
- Träning av Document AI och LayoutLM: Moderna maskininlärningsmodeller för dokumentförståelse kräver både text och 2D-bounding boxes. XML ger optimal träningsdata för detta ändamål.
- Elektroniskt datautbyte (EDI): Affärssystem (SAP, Oracle) kräver strukturerade format för automatiserad orderhantering. Att omvandla inköpsorder i PDF till XML överbryggar klyftan mellan dokument och affärssystem.
Praktisk tolkning: Använd Python, lxml och XPath på din XML-fil
När du laddat ner XML-filen är det enkelt att skriva ett Python-skript för att plocka ut önskade fält. Med biblioteket lxml och XPath kan du filtrera textnoder baserat på deras koordinater:
from lxml import etree

# Läs in och tolka den genererade XML-filen
tree = etree.parse("faktura.xml")
root = tree.getroot()

# Hämta alla textnoder inom ett visst koordinatintervall
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Genom att kombinera attributen @top, @left och @font skapar du stabila regler som fungerar även vid små layoutförskjutningar.
Felsökning: Skannade dokument, OCR och sekretess i RAM
För att säkerställa ett smidigt arbetsflöde bör du beakta följande tekniska rekommendationer:
1. Skannade pappersdokument utan digital text
Om PDF-filen skapats via en skanner utan optisk teckenläsning innehåller den endast punktgrafikbilder. Eftersom konverteraren extraherar vektortext resulterar en ren bild-PDF i en tom XML-struktur. Lär dig hur du kan extrahera text från PDF med OCR för att skapa ett osynligt textlager innan du konverterar till XML.
2. Hantering av stora flersidiga dokument
Vid dokument på hundratals sidor kan XML-filen växa kraftigt i storlek på grund av de detaljerade koordinaterna. Använd gärna Gzip-komprimering vid lagring och överföring.
3. Fullständig integritet och in-memory-bearbetning
Fakturor, kontrakt och personalakter innehåller konfidentiell information. Vår plattform tillämpar strikta säkerhetsrutiner:
- Bearbetning uteslutande i RAM: All tolkning och XML-generering sker uteslutande i serverns flyktiga arbetsminne och skrivs aldrig till hårddisk.
- Automatisk radering inom 5 minuter: En bakgrundsprocess rensar bort alla temporära data permanent inom fem minuter efter att bearbetningen avslutats.
- 100 % gratis utan konto: Inga e-postadresser eller betaluppgifter efterfrågas, vilket garanterar fullständig anonymitet.
- Inga vattenstämplar: Utdata levereras i ren XML enligt officiella DTD-standarder.
Utforska fler kraftfulla verktyg i AZ2PDF tekniska verktygslåda för PDF direkt i din webbläsare.
❓ Vanliga Frågor (FAQ)
Vanlig text raderar all rumslig information och slår ihop kolumner och rubriker till en oordnad ström. CSV förutsätter regelbundna rutnät. XML bevarar ordens exakta placering på sidan via bounding box-attribut (top, left, width, height), vilket gör att program kan extrahera data baserat på koordinater oberoende av visuell tabellstil.
Relaterade Artiklar i Ämnet
Lär dig mer om professionell sidhantering och dokumentorganisation.
Konvertera PDF till CSV online gratis (ren tabellextraktion)
Lär dig hur du konverterar PDF-tabeller till rena, strukturerade CSV-filer online gratis. Extrahera kontoutdrag och fakturor utan förskjutna kolumner.
Konvertera PDF till text online gratis (ren TXT-extraktion)
Lär dig hur du extraherar oformaterad ren text från PDF-filer online gratis. Konvertera flerkolumnsdokument till felfria UTF-8 TXT-filer för AI och kod.

Hur man extraherar text från skannad PDF med OCR (Gratis & Säkert)
Lär dig hur du konverterar skannade pappersdokument och foto-PDF:er till sökbar och markerbar text med gratis flerspråkig OCR. Snabbt, exakt och 100 % privat i webbläsaren.
Konvertera PDF till HTML online gratis (ren kod och exakt layout)
Lär dig hur du konverterar PDF-dokument till responsiva HTML5- och CSS-webbsidor online gratis. Behåll typsnitt, formatering och grafik utan vattenstämplar.
Hur man konverterar HTML-filer till PDF online utan formateringsförlust
Lär dig hur du konverterar HTML-filer och CSS-stilar till utskriftsklara PDF-dokument online gratis. Behåll exakta typsnitt, sidbrytningar och layout utan vattenstämplar.
Konvertera PDF till EPUB online gratis (flödande text för läsplattor)
Lär dig hur du konverterar PDF-dokument till flödande EPUB-e-böcker online gratis. Läs bekvämt på Kindle, Kobo och Apple Books utan tröttsamt zoomande.