Como converter PDF em XML online grátis (Dados estruturados com coordenadas)
Resposta Direta & Principais Conclusões
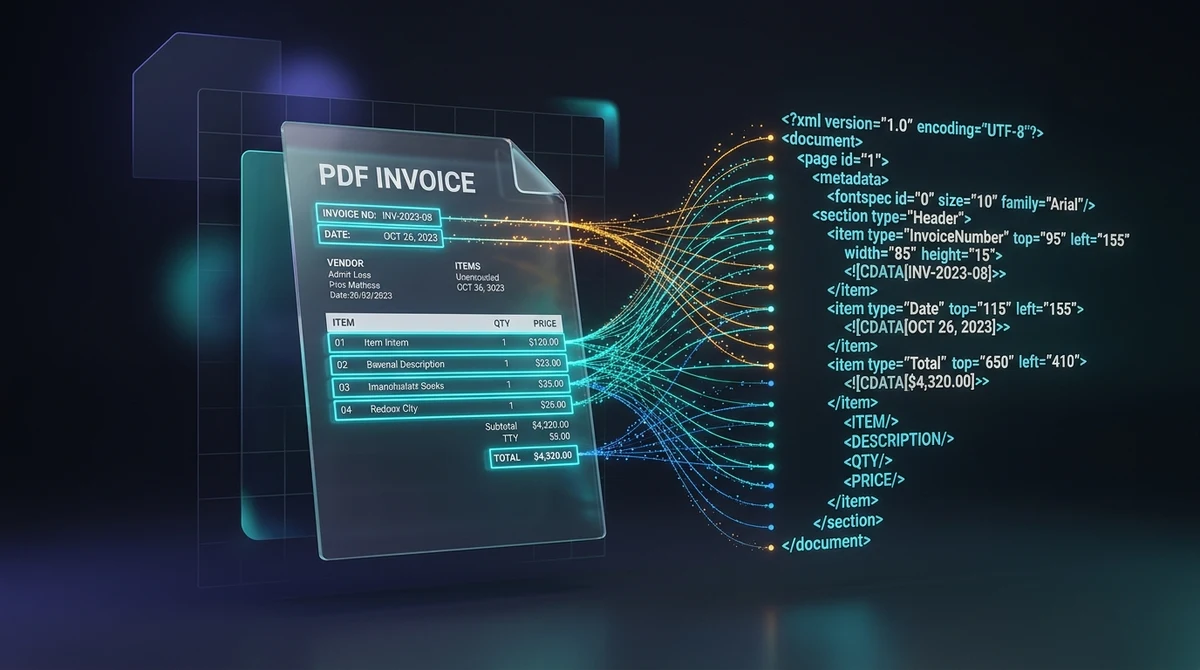
Para converter um PDF em XML online gratuitamente, você transforma layouts visuais de documentos em tags hierárquicas Extensible Markup Language contendo coordenadas espaciais absolutas (top, left, width, height) e especificações tipográficas. Com o conversor AZ2PDF, engenheiros de dados, desenvolvedores e analistas extraem nós de texto estruturados legíveis por máquina em segundos, sem instalar programas, 100% gratuito e na memória RAM volátil.
- Preservação de coordenadas espaciais: Cada elemento de texto recebe atributos de caixa delimitadora (top, left, width, height) e dados de fonte para uma extração geométrica precisa.
- Dados hierárquicos legíveis por máquina: Converte páginas visuais fixas em nós XML estruturados (page, fontspec, text) prontos para ingestão em Python, Node.js e sistemas ERP.
- Ideal para faturas e pipelines ETL: Perfeito para processar demonstrativos financeiros em várias colunas, faturas B2B e formulários fiscais sem perder relações espaciais.
- 100% gratuito com processamento em RAM: O AZ2PDF processa seus arquivos na memória RAM volátil do servidor, sem taxas, sem cadastro, sem marca d'água e com exclusão automática após 5 minutos.
O problema da extração de dados: Por que os PDFs bloqueiam informações corporativas
Na tecnologia da informação corporativa contemporânea, o formato Portable Document Format (PDF) representa um padrão essencial de visualização, mas um dos maiores entraves à automação de dados. Padronizado sob a norma ISO 32000, o PDF se destaca pela fidelidade visual: fixa caracteres, traçados vetoriais e margens em uma cópia exata de uma folha impressa. Em qualquer dispositivo ou impressora, o documento permanece rigorosamente idêntico.
No entanto, o que torna o PDF perfeito para a leitura humana cria um obstáculo para a leitura computacional. Um arquivo PDF não armazena árvores de dados semânticos como uma tabela de banco de dados ou planilha. Ele não compreende inerentemente conceitos como linha, coluna, subtotal ou código de fatura. Em vez disso, armazena instruções gráficas diretas: ordens de desenho como imprimir esta sequência de caracteres nas coordenadas X=150, Y=720.
Quando analistas ou programadores tentam extrair texto usando métodos convencionais de exportação de texto, ocorrem falhas frequentes:
- Tabelas com múltiplas colunas colapsam em uma única sequência de texto desordenada.
- Cabeçalhos, rodapés e números de página se misturam aos registros financeiros.
- Relações espaciais indispensáveis (como reconhecer que um valor monetário está logo abaixo de um rótulo de imposto) desaparecem por completo.
A conversão do seu documento PDF em Extensible Markup Language (XML) estruturado resolve essa limitação, registrando tanto o conteúdo quanto as coordenadas espaciais exatas em um modelo hierárquico legível por computador.
O que é a conversão de PDF para XML e como é a estrutura de saída?
A conversão de PDF para XML analisa a diagramação visual de um documento e a converte em um modelo de objetos XML organizado segundo as DTDs oficiais (como a especificação Poppler pdf2xml). Em vez de gerar texto simples contínuo, o motor agrupa elementos por página, cataloga as fontes tipográficas e associa cada fragmento de texto às coordenadas de sua caixa delimitadora.
Veja um exemplo real da sintaxe XML produzida:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Com essa saída padronizada, scripts de automação não precisam deduzir a disposição dos dados. Analisando os atributos top, left, width e height, qualquer sistema localiza instantaneamente as informações com base nas suas coordenadas reais na página.
Coordenadas espaciais: Compreendendo top, left, width, height e fontspec
O grande diferencial da extração XML reside nos seus metadados espaciais. Compreender esses atributos possibilita construir fluxos de dados resilientes:
- Dimensões da página (<page>): O elemento raiz
<page>indica as medidas físicas da folha (comowidth="918" height="1188"em pontos padrão), estabelecendo a malha de coordenadas para os nós filhos. - Definições tipográficas (<fontspec>): O analisador identifica as fontes empregadas no arquivo e atribui identificadores exclusivos (
font="0",font="1"). Cada tag<fontspec>define família tipográfica, tamanho em pontos e código de cor hexadecimal, permitindo que scripts diferenciem títulos de notas de rodapé pelo tamanho da fonte. - Coordenadas top e left: O atributo
topinforma a distância vertical em pontos desde a borda superior até a linha de base do texto. O atributoleftmarca o recuo horizontal a partir da margem esquerda. - Atributos width e height: Definem largura e altura da caixa delimitadora, facilitando o cálculo de colunas e a conferência de alinhamentos na mesma linha horizontal.
- Marcações de formatação: Estilos em negrito (
<b>) e itálico (<i>) são mantidos diretamente nos nós de texto para auxiliar na identificação de campos principais.
Converta documentos em conjuntos de dados legíveis por máquina com o conversor de PDF para XML da AZ2PDF, mapeando coordenadas espaciais e hierarquias semânticas em tags XML padrão.
Como converter PDF em XML online em 3 passos simples
A conversão de documentos PDF em XML estruturado pode ser concluída em menos de um minuto no navegador web:
Passo 1: Envie seu documento PDF
Arraste e solte sua fatura, demonstrativo ou relatório técnico na área de envio, ou clique para selecionar o arquivo no seu computador ou celular.
Passo 2: Análise automática dos dados espaciais
O motor de processamento analisa a árvore de objetos PDF na memória RAM volátil do servidor. Ele mapeia os blocos de texto, calcula os perímetros das caixas delimitadoras, lê as fontes e cria um modelo XML consistente.
Passo 3: Baixe seu arquivo XML estruturado
Clique em Baixar para gravar seu arquivo .xml. Ele está pronto para ser aberto em editores de código ou conectado à sua infraestrutura de dados sem necessidade de cadastro. Para relatórios tabulares simples, você também pode conferir como converter PDF em CSV online e manipular os valores diretamente no Excel.
Casos de uso estratégicos: Faturas, pipelines ETL e treinamento de Document AI
A transformação de PDF em XML sustenta fluxos automáticos de grande volume em diferentes áreas corporativas:
- Processamento automatizado de notas e faturas: Departamentos contábeis processam milhares de documentos com diagramações diversas. Expressões regulares frequentemente falham diante de variações visuais. Com XML, programas miram áreas de coordenadas específicas (como o quadrante superior direito contendo número de documento e vencimento).
- Pipelines ETL (Extract, Transform, Load): Data warehouses corporativos recebem balanços e formulários com frequência. O XML proporciona um padrão interoperável e neutro que se integra com facilidade ao Apache Spark, Python Airflow e bancos de dados SQL.
- Treinamento de modelos Document AI e LayoutLM: Redes neurais modernas precisam de texto e caixas delimitadoras bidimensionais para entender a disposição dos elementos em uma página. O XML oferece a representação espacial exata para alimentar esses modelos.
- Intercâmbio eletrônico de dados B2B (EDI): Sistemas ERP (SAP, Oracle) dependem de formatos estruturados para emitir pedidos automaticamente. A conversão de pedidos PDF em XML estabelece a ponte entre o layout legível e o processamento no ERP.
Análise prática: Usando Python, lxml e XPath no seu arquivo XML
Depois de fazer o download do arquivo XML, criar um script de leitura em Python é bastante direto. A biblioteca lxml com consultas XPath permite selecionar nós de texto com base em suas coordenadas exatas:
from lxml import etree

# Carregar e analisar o arquivo XML gerado
tree = etree.parse("fatura.xml")
root = tree.getroot()

# Selecionar nós de texto em uma determinada área geométrica
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Ao articular os atributos @top, @left e @font, você desenvolve regras de extração confiáveis e tolerantes a pequenas oscilações de layout.
Solução de problemas: Documentos digitalizados, OCR e privacidade na RAM
Para obter os melhores resultados em suas rotinas de dados, considere estas recomendações técnicas:
1. Documentos digitalizados sem camada de texto digital
Se o PDF for fruto de um scanner sem reconhecimento óptico de caracteres, o arquivo terá somente imagens de mapa de bits. Como o conversor processa vetores de texto nativos, um PDF composto unicamente por imagens gerará um XML sem conteúdo. Para corrigir isso, veja nosso tutorial de como extrair texto de PDF com OCR para embutir uma camada de texto digital antes da conversão.
2. Gerenciamento de arquivos volumosos
Em documentos extensos, o XML pode apresentar tamanho considerável devido à especificação minuciosa de cada coordenada. É recomendável empregar métodos de compressão como Gzip para armazenar ou transmitir os dados com eficiência.
3. Confidencialidade total e processamento em RAM
Demonstrativos contábeis e contratos contêm informações corporativas confidenciais. Nossa plataforma opera com normas rigorosas de proteção:
- Processamento temporário em RAM: A leitura dos objetos e a geração do arquivo XML ocorrem apenas na memória RAM volátil, sem gravação em discos magnéticos permanentes.
- Eliminação automática após 5 minutos: Um serviço em segundo plano purga de forma irreversível qualquer dado em buffer em até 5 minutos após o processamento.
- Gratuito sem necessidade de login: Não exigimos e-mail nem dados de cartão, assegurando total privacidade.
- Sem marcas d'água no arquivo: Seu XML é entregue limpo e compatível com as normas DTD.
Conheça mais ferramentas eficientes no conjunto de ferramentas técnicas de PDF da AZ2PDF direto no seu navegador web.
❓ Perguntas Frequentes (FAQ)
A conversão para texto simples descarta todas as referências espaciais, mesclando colunas e cabeçalhos em um bloco confuso. O CSV exige estruturas regulares de grade. O formato XML registra a localização exata de cada termo na página por meio de atributos de caixa delimitadora (top, left, width, height), permitindo extrair dados por quadrantes independentemente do design visual.
Artigos Relacionados a Este Tema
Aprofunde-se em técnicas profissionais de organização de páginas e manipulação documental.
Como converter PDF em CSV online grátis (extração limpa de tabelas)
Aprenda a converter tabelas PDF em arquivos CSV limpos e estruturados online grátis. Extraia extratos bancários e faturas sem desalinhamento de colunas.
Como converter PDF em texto online grátis (extração TXT limpa)
Aprenda a extrair texto não formatado de documentos PDF online gratuitamente. Converta páginas em colunas em arquivos TXT UTF-8 limpos para IA e código.

Como extrair texto de PDF digitalizado com OCR (Grátis e Seguro)
Aprenda a converter documentos em papel digitalizados e fotos PDF em texto pesquisável e selecionável com OCR multilíngue gratuito. Rápido, preciso e 100% privado no navegador.
Como converter PDF em HTML online grátis (código limpo e layout exato)
Aprenda a converter documentos PDF em páginas web HTML5 e CSS responsivas online e grátis. Preserve fontes, estilos e gráficos vetoriais sem marcas de água.
Como converter arquivos HTML em PDF online sem perder a formatação
Aprenda a converter gratuitamente arquivos HTML e estilos CSS em documentos PDF prontos para impressão online. Mantenha fontes, quebras de página e layout sem marcas d'água.
Como converter PDF em EPUB online grátis (texto fluido para e-readers)
Aprenda a converter documentos PDF em e-books EPUB com texto fluido online grátis. Leia com conforto no Kindle, Kobo e Apple Books sem fadiga visual.