PDF naar XML online gratis converteren (Gestructureerde data met coördinaten)
Direct Antwoord & Belangrijkste Inzichten
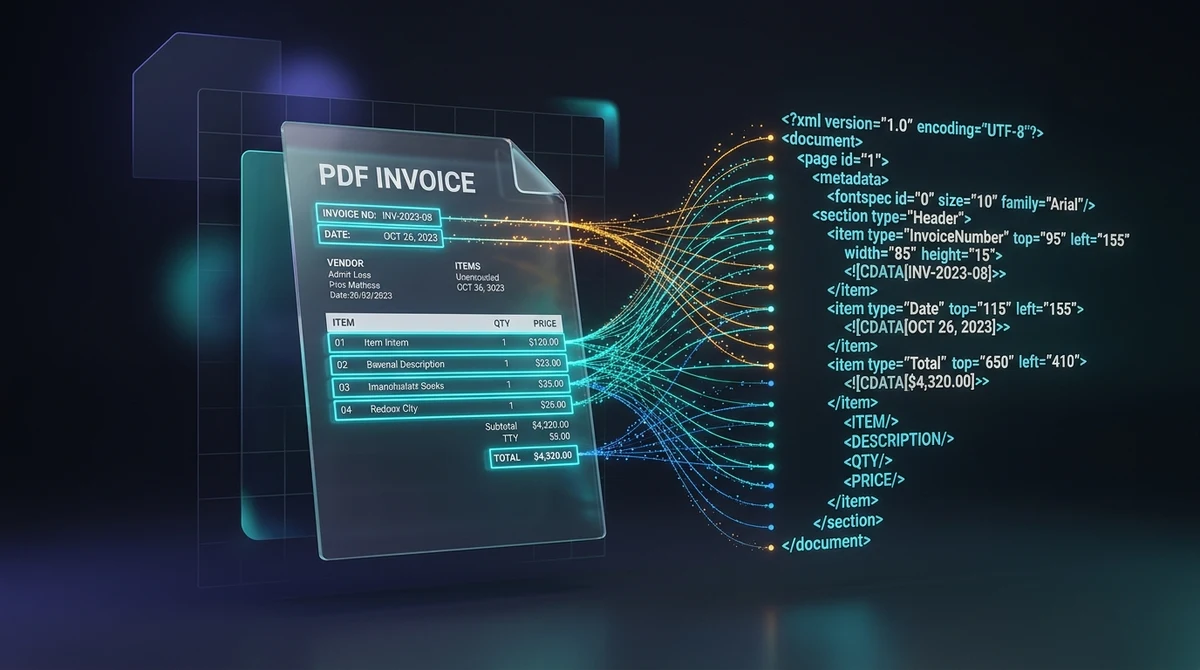
Om een PDF online gratis naar XML te converteren, transformeert u visuele documentindelingen naar hiërarchische Extensible Markup Language-tags met absolute ruimtelijke coördinaten (top, left, width, height) en lettertypespecificaties. Met de AZ2PDF-converter kunnen data engineers, ontwikkelaars en analisten binnen enkele seconden gestructureerde machinaal leesbare tekstknooppunten extraheren, 100% gratis en veilig in het vluchtige server-RAM.
- Ruimtelijke coördinaten behouden: Elk tekstelement wordt voorzien van exacte bounding box-attributen (top, left, width, height) en fontspecificaties voor nauwkeurige extractie op basis van coördinaten.
- Machinaal leesbare hiërarchische data: Zet statische visuele pagina's om in gestructureerde XML-knooppunten (page, fontspec, text) die direct kunnen worden ingeladen in Python, Node.js en ERP-systemen.
- Onmisbaar voor facturen en geautomatiseerde ETL-pipelines: Uitermate geschikt voor het verwerken van financiële overzichten met meerdere kolommen, B2B-facturen en belastingformulieren.
- 100% gratis met directe in-memory verwerking: AZ2PDF verwerkt uw bestanden rechtstreeks in het vluchtige werkgeheugen, zonder kosten, zonder registratie, zonder watermerken en met automatische verwijdering na 5 minuten.
Het data-extractieprobleem: Waarom PDF's bedrijfsinformatie opsluiten
In moderne IT-infrastructuren is het Portable Document Format (PDF) zowel een onvervangbare standaard als een grote hinderpaal voor automatisering. Gestandaardiseerd onder ISO 32000 blinkt het PDF-formaat uit in visuele presentatie: het verankert woorden, vectoren en marges in een exacte digitale kopie van een afgedrukte pagina. Of het document nu wordt geopend op een pc, mobiele telefoon of laserprinter, de weergave is altijd identiek.
Wat het PDF-formaat echter ideaal maakt voor het menselijk oog, maakt het notoir lastig voor computerprogramma's. Een PDF slaat geen semantische databoom op zoals een databasetabel of spreadsheet. Het formaat weet uit zichzelf niet wat een rij, kolom, subtotaal of factuurnummer is. In plaats daarvan bewaart het grafische tekeninstructies: directe opdrachten zoals teken deze tekenreeks op coördinaat X=150, Y=720.
Wanneer softwareontwikkelaars of analisten data proberen te halen uit PDF's met conventionele tekst-dumpgereedschappen, ontstaan hardnekkige problemen:
- Tabellen met meerdere kolommen vallen samen in één ongeordende tekststroom.
- Kopteksten, voetteksten en paginanummers mengen zich willekeurig tussen de feitelijke data.
- Ruimtelijke verbanden (zoals de wetenschap dat een geldbedrag direct onder een btw-label staat) gaan volledig verloren.
Het converteren van PDF-bestanden naar gestructureerde Extensible Markup Language (XML) lost dit op door zowel de tekst als de exacte tweedimensionale geometrie vast te leggen in een machineleesbare hiërarchie.
Wat is PDF naar XML-conversie en hoe ziet de uitvoer eruit?
Bij PDF naar XML-conversie wordt de visuele indeling van een document vertaald naar een geordend XML-objectmodel conform officiële DTD-standaarden (zoals de Poppler pdf2xml-specificatie). In plaats van platte platte tekst te dumpen, groepeert de engine elementen per pagina, brengt lettertype-eigenschappen in kaart en markeert elk tekstfragment met de coördinaten van de bounding box.
Hieronder ziet u een waarheidsgetrouw voorbeeld van de resulterende XML-syntaxis:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Dankzij deze heldere structuur hoeven geautomatiseerde scripts niet langer te gissen naar de herkomst van informatie. Door de attributen top, left, width en height uit te lezen, kan elke softwaretoepassing data lokaliseren op basis van exacte coördinaten op de pagina.
Ruimtelijke coördinaten: Begrijpen van top, left, width, height en fontspec
De ware kracht van XML-extractie schuilt in de rijke geometrische metadata. Begrip van deze attributen helpt u bij het ontwerpen van stabiele datapipelines:
- Paginagrenzen (<page>): Het hoofdelement
<page>specificeert de fysieke canvasafmetingen (zoalswidth="918" height="1188"in standaardpunten), wat het coördinatenstelsel vormt voor alle onderliggende elementen. - Lettertypedefinities (<fontspec>): De parser indexeert alle gebruikte lettertypen en kent unieke id's toe (
font="0",font="1"). Elke tag<fontspec>specificeert de fontfamilie, puntgrootte en hex-kleurcode, waardoor scripts hoofdtitels eenvoudig kunnen onderscheiden van voetnoten op basis van lettergrootte. - top- en left-coördinaten: Het
top-attribuut geeft de verticale afstand aan vanaf de bovenrand van de pagina tot aan de basislijn van de tekst. Hetleft-attribuut markeert de horizontale offset ten opzichte van de linkermarge. - Attributen width en height: Deze definiëren de breedte en hoogte van de bounding box van het tekstblok, wat het berekenen van kolomgrenzen en het controleren van horizontale uitlijningen vereenvoudigt.
- Inline typografietags: Vette (
<b>) en cursieve (<i>) stijlen blijven rechtstreeks behouden binnen de tekstknooppunten, wat helpt bij het identificeren van sleutel-waardelabels.
Zet documenten om in gestructureerde datasets met de AZ2PDF PDF naar XML-converter, die coördinaten en semantische hiërarchieën vertaalt naar standaard XML-tags.
PDF online in 3 eenvoudige stappen naar XML converteren
Het omzetten van PDF naar gestructureerde XML voltooit u in minder dan een minuut direct in uw webbrowser:
Stap 1: Upload uw PDF-document
Sleep uw PDF-factuur, jaarrekening of technisch rapport naar het uploadvak, of klik om het bestand vanaf uw computer of mobiele apparaat te selecteren.
Stap 2: Automatische verwerking van ruimtelijke data
Onze hoogwaardige engine analyseert de PDF-objectstructuur in het vluchtige RAM van de server. De tool brengt tekstblokken in kaart, berekent perimetercoördinaten, registreert fonttabellen en bouwt een conforme XML-boom.
Stap 3: Download uw gestructureerde XML-bestand
Klik op Downloaden om uw .xml-bestand op te slaan. U kunt het direct openen in code-editors zoals VS Code of koppelen aan uw bedrijfsdatasystemen zonder verplichte registratie. Wilt u puur met eenvoudige tabellen werken, bekijk dan ook hoe u PDF naar CSV online converteren kunt om data direct in Excel in te laden.
Belangrijke use cases: Facturen, ETL-pipelines en training van Document AI
De conversie van PDF naar XML vormt de basis voor geautomatiseerde workflows in talloze sectoren:
- Geautomatiseerde factuurverwerking in de boekhouding: Financiële afdelingen verwerken duizenden leveranciersfacturen per maand met uiteenlopende lay-outs. Reguliere expressies (regex) lopen regelmatig vast. Met XML kunnen programma's zich richten op vaste coördinatenzones (zoals de rechterbovenhoek voor factuurnummer en vervaldatum).
- ETL-pipelines (Extract, Transform, Load): Datawarehouses nemen regelmatig kwartaalcijfers en polisdocumenten op. XML biedt een neutraal en gestandaardiseerd formaat dat naadloos integreert met Apache Spark, Python Airflow en relationele databases.
- Training van Document AI- en LayoutLM-modellen: Moderne machine learning-modellen hebben zowel teksttokens als tweedimensionale bounding boxes nodig om paginastructuren te begrijpen. Het XML-formaat levert de perfecte ruimtelijke trainingsdata.
- Elektronische gegevensuitwisseling (EDI): ERP-systemen (zoals SAP en Oracle) vereisen gestructureerde invoer voor automatische orderverwerking. Het converteren van PDF-bestellingen naar XML slaat de brug tussen documenten en geautomatiseerde ERP-processen.
Praktisch parsen: Python, lxml en XPath toepassen op geconverteerde XML
Na het downloaden van het XML-bestand is het schrijven van een extractiescript in Python zeer eenvoudig. Met de bibliotheek lxml en XPath-query's kunt u tekstknooppunten nauwkeurig filteren op basis van hun coördinaten:
from lxml import etree

# XML-bestand laden en parsen
tree = etree.parse("factuur.xml")
root = tree.getroot()

# Alle tekstknooppunten binnen een specifiek coördinatenbereik ophalen
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Door de attributen @top, @left en @font slim te combineren, bouwt u robuuste extractieregels die ook bij lichte verschuivingen in het document betrouwbaar blijven werken.
Probleemoplossing: Gescande documenten, OCR en privacy in RAM
Houd rekening met de volgende technische richtlijnen voor een vlekkeloze documentverwerking:
1. Gescande documenten zonder digitale tekstlaag
Als uw PDF afkomstig is van een scanner of fax zonder optische tekenherkenning, bevat het bestand enkel bitmapafbeeldingen. Omdat de converter native vectoriële tekst extraheert, zal een scan-PDF een lege XML-structuur opleveren. Lees hier hoe u tekst uit PDF extraheren met OCR kunt toepassen om eerst een digitale tekstlaag toe te voegen.
2. Omgaan met grote documenten van vele pagina's
Bij omvangrijke documenten kunnen XML-bestanden behoorlijk groot worden door de gedetailleerde coördinaten per tekstfragment. Maak gebruik van compressietechnieken zoals Gzip voor efficiënte opslag en netwerkoverdracht.
3. Volledige privacy en in-memory verwerking
Facturen, contracten en balansen bevatten gevoelige bedrijfsgegevens. Ons platform hanteert strenge veiligheidseisen:
- Verwerking uitsluitend in werkgeheugen: Alle parsing- en XML-constructies vinden uitsluitend plaats in het vluchtige RAM van de server, zonder opslag op permanente harde schijven.
- Automatische opschoning na 5 minuten: Een achtergrondservice verwijdert alle tijdelijke verwerkingsbuffers definitief binnen vijf minuten na afronding.
- 100% gratis zonder registratie: U hoeft geen e-mailadres of betalingsgegevens op te geven en blijft volledig anoniem.
- Geen storende watermerken: Uw XML-bestand is zuiver en conform de officiële DTD-standaarden.
Ontdek meer krachtige hulpmiddelen in de AZ2PDF technische PDF-gereedschapskist direct in uw browser.
❓ Veelgestelde Vragen (FAQ)
Bij het converteren naar platte tekst gaat alle ruimtelijke informatie verloren, waardoor kolommen en kopteksten door elkaar lopen. CSV vereist een rigide rasterindeling. XML bewaart de exacte fysieke locatie van elk woord via bounding box-attributen (top, left, width, height), waardoor geautomatiseerde programma's data kunnen extraheren op basis van coördinatenzones ongeacht de visuele opmaak.
Gerelateerde Artikelen over Dit Onderwerp
Ontdek meer professionele technieken voor pagina-indeling en documentbeheer.
PDF naar CSV online gratis converteren (schone tabelextractie)
Leer hoe u PDF-tabellen gratis online converteert naar schone, gestructureerde CSV-bestanden. Extraheer bankafschriften en facturen zonder kolomfouten.
PDF naar tekst online converteren gratis (schone TXT-extractie)
Leer hoe u online gratis niet-opgemaakte platte tekst uit PDF-bestanden extraheert. Converteer pagina's met kolommen naar schone UTF-8 TXT-bestanden voor AI.

Tekst uit gescande PDF extraheren met OCR (Gratis en Veilig)
Ontdek hoe u gescande papieren documenten en foto-PDF's omzet in selecteerbare en doorzoekbare tekst met gratis meertalige OCR. Snel, nauwkeurig en 100% privé in uw browser.
PDF naar HTML online gratis converteren (schone code en lay-outbehoud)
Leer hoe u PDF-documenten gratis online converteert naar responsieve HTML5- en CSS-webpagina's. Behoud lettertypen, opmaak en vectorafbeeldingen zonder watermerken.
HTML-bestanden online naar PDF converteren zonder opmaakverlies
Leer hoe u HTML-bestanden en CSS-stijlen gratis online converteert naar afdrukklare PDF-documenten. Behoud lettertypen, pagina-einden en lay-out zonder watermerken.
PDF naar EPUB online gratis converteren (vloeiende tekst voor e-readers)
Leer hoe u PDF-documenten gratis online converteert naar vloeibaar aanpasbare EPUB-e-books. Lees comfortabel op Kindle, Kobo en Apple Books zonder vermoeidheid.