Come convertire PDF in XML online gratis (Dati strutturati con coordinate)
Risposta Diretta & Punti Chiave
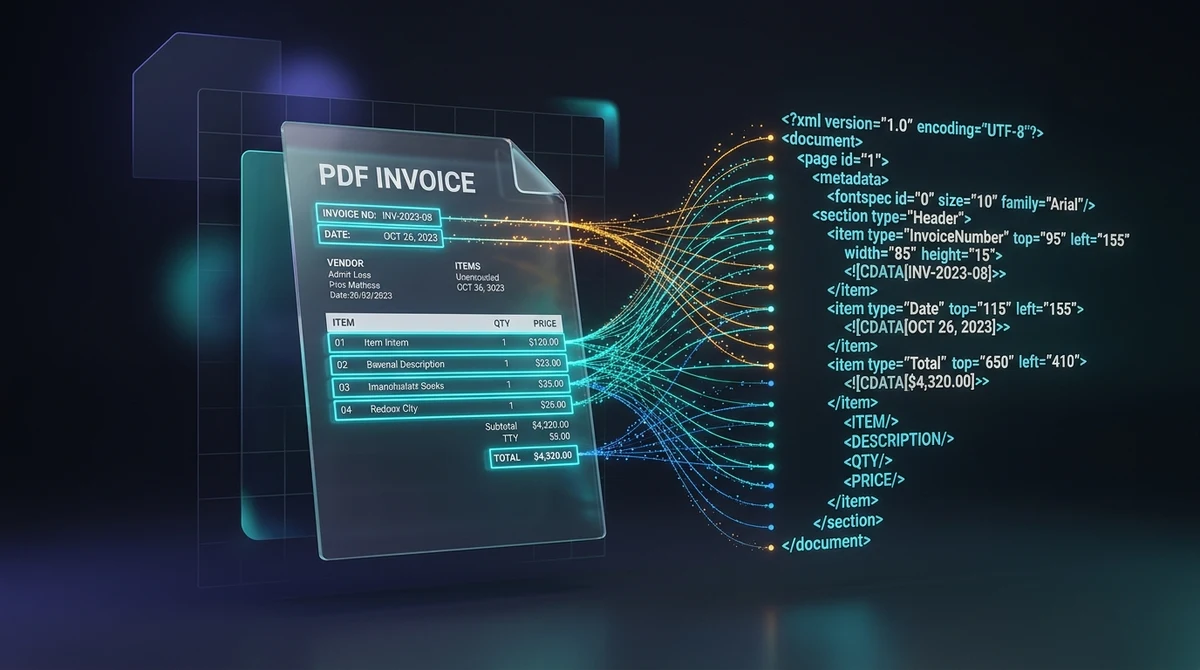
Per convertire un PDF in XML online gratuitamente, si trasformano i layout visivi dei documenti in tag gerarchici Extensible Markup Language contenenti coordinate spaziali assolute (top, left, width, height) e specifiche dei font. Con il convertitore AZ2PDF, ingegneri dei dati, sviluppatori e analisti estraggono nodi di testo strutturati leggibili da macchina in pochi secondi, senza installazione di software, 100% gratis e in memoria RAM volatile.
- Preservazione delle coordinate spaziali: Ogni elemento di testo è etichettato con attributi geometrici esatti (top, left, width, height) e parametri dei font per un'estrazione basata su coordinate.
- Dati gerarchici leggibili da macchina: Trasforma pagine visive statiche in nodi XML strutturati (page, fontspec, text) pronti per l'ingestione automatica in Python, Node.js e sistemi ERP.
- Ideale per fatture e pipeline ETL: Perfetto per analizzare rendiconti finanziari a più colonne, fatture B2B e moduli fiscali senza perdere le relazioni spaziali.
- 100% gratis con elaborazione istantanea in RAM: AZ2PDF elabora i file nella memoria RAM volatile del server, senza costi, senza registrazione, senza filigrane e con cancellazione automatica dopo 5 minuti.
Il problema dell'estrazione dei dati: Perché i PDF bloccano le informazioni aziendali
Nell'informatica aziendale moderna, il formato Portable Document Format (PDF) rappresenta al contempo uno standard imprescindibile e un grande ostacolo per l'automazione dei flussi di lavoro. Standardizzato internazionalmente con la norma ISO 32000, il PDF eccelle nella fedeltà visiva: fissa parole, elementi vettoriali e margini in una replica esatta della pagina stampata. Che venga visualizzato su un computer portatile, su uno smartphone o inviato a una stampante, il documento appare sempre identico.
Tuttavia, ciò che rende il PDF ideale per la lettura umana ne complica notevolmente l'elaborazione automatica da parte dei software. Un file PDF non memorizza un albero di dati semantico come una tabella di database o un foglio di calcolo Excel. Non comprende nativamente cosa sia una riga, una colonna, un subtotale o un numero di fattura. Conserva invece istruzioni grafiche di rendering: ordini espliciti come disegna questa sequenza di caratteri alle coordinate X=150, Y=720.
Quando programmatori o analisti tentano di estrarre testo con utility convenzionali, si presentano problemi tipici:
- Le tabelle a più colonne collassano in un unico flusso continuo di testo disordinato.
- Intestazioni, piè di pagina e numeri di pagina si mescolano casualmente ai dati contabili.
- Le relazioni spaziali fondamentali (come identificare una cifra numerica posizionata sotto una dicitura di imposta) svaniscono del tutto.
Convertire il file PDF in Extensible Markup Language (XML) strutturato risolve questa complessità preservando sia il contenuto testuale sia l'esatta geometria spaziale in una gerarchia leggibile da macchina.
Che cos'è la conversione da PDF a XML e qual è la struttura dell'output?
La conversione da PDF a XML interpreta il layout visivo di un documento e lo traduce in un modello a oggetti XML rigorosamente conforme alle DTD ufficiali (come la specifica Poppler pdf2xml). Invece di esportare un testo piatto, il motore raggruppa gli elementi per pagina, indicizza gli attributi tipografici e associa a ciascun frammento di testo le coordinate del suo rettangolo di delimitazione (bounding box).
Ecco un esempio concreto della sintassi XML ottenuta:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Con questa struttura ordinata, i vostri script di automazione non devono più dedurre la collocazione delle informazioni. Esaminando gli attributi top, left, width e height, qualsiasi programma può individuare istantaneamente i dati in base alle loro coordinate fisiche sulla pagina.
Coordinate spaziali: Comprendere top, left, width, height e fontspec
Il punto di forza dell'estrazione XML consiste nei suoi ricchi metadati geometrici. Conoscere il funzionamento di questi attributi consente di allestire pipeline di dati molto robuste:
- Dimensioni del foglio (<page>): L'elemento radice
<page>definisce le dimensioni del foglio fisico (comewidth="918" height="1188"in punti tipografici), definendo la griglia di riferimento per tutti i nodi figli. - Dichiarazioni dei caratteri (<fontspec>): Il parser cataloga tutti i caratteri tipografici presenti e assegna loro un identificatore univoco (
font="0",font="1"). Ogni tag<fontspec>specifica famiglia del font, dimensione e codice colore esadecimale, consentendo ai programmi di distinguere automaticamente i titoli principali dalle note a piè di pagina. - Coordinate top e left: L'attributo
topmisura la distanza verticale dal bordo superiore della pagina alla linea di base del testo. L'attributoleftindica lo scostamento orizzontale rispetto al margine sinistro. - Attributi width e height: Definiscono larghezza e altezza del blocco di testo, agevolando il calcolo delle colonne e la verifica degli allineamenti orizzontali.
- Tag tipografici inline: Grassetto (
<b>) e corsivo (<i>) sono conservati direttamente all'interno dei nodi di testo, facilitando l'individuazione di etichette chiave.
Converti documenti in dataset leggibili da macchine con il convertitore da PDF a XML di AZ2PDF, estraendo coordinate e gerarchie semantiche in tag XML standard.
Come convertire PDF in XML online in 3 semplici passaggi
Convertire documenti PDF in XML strutturato si effettua in meno di un minuto direttamente nel browser web:
Passaggio 1: Carica il documento PDF
Trascina e rilascia la fattura, il bilancio o la specifica tecnica nell'apposita casella di caricamento, oppure fai clic per selezionare il file dal tuo dispositivo.
Passaggio 2: Elaborazione automatica dei dati spaziali
Il nostro motore analizza il flusso di oggetti PDF nella memoria RAM volatile del server. Mappa i blocchi di testo, calcola le geometrie perimetrali, registra le tabelle dei font e costruisce un albero XML valido.
Passaggio 3: Scarica il file XML strutturato
Fai clic su Scarica per salvare il file .xml sul computer. Puoi aprirlo subito nel tuo editor di testo o integrarlo nei tuoi sistemi aziendali senza registrazione. Se hai bisogno di gestire semplici tabelle numeriche, puoi anche scoprire come convertire PDF in CSV online per lavorare direttamente in Excel.
Casi d'uso ad alto valore: Fatture, pipeline ETL e addestramento Document AI
La trasformazione da PDF a XML costituisce l'infrastruttura fondamentale per l'automazione dei dati su larga scala:
- Elaborazione automatica delle fatture contabili: I reparti finanziari gestiscono migliaia di fatture passive al mese con layout differenti. Le espressioni regolari regex falliscono frequentemente di fronte a variazioni stilistiche. Con l'XML, i software puntano a regioni geometriche fisse (ad esempio il riquadro in alto a destra con numero di fattura e data di scadenza).
- Pipeline ETL (Extract, Transform, Load): I data warehouse aziendali acquisiscono rendiconti periodici e polizze. Il formato XML fornisce una struttura interoperabile che si interfaccia perfettamente con Apache Spark, Python Airflow e database relazionali.
- Addestramento di modelli Document AI e LayoutLM: I moderni modelli di deep learning richiedono sia il testo sia i riquadri delimitatori 2D per comprendere l'impaginazione dei documenti. L'XML generato fornisce i dati geometrici perfetti.
- Scambio elettronico di dati B2B (EDI): I sistemi gestionali ERP (SAP, Oracle) richiedono formati strutturati per la generazione automatica degli ordini. La conversione dei PDF d'ordine in XML stabilisce una connessione diretta tra il foglio cartaceo e i processi ERP.
Parsing pratico: Utilizzare Python, lxml e XPath sull'XML generato
Dopo aver scaricato il file XML, scrivere uno script di estrazione in Python è un'operazione immediata. Con la libreria lxml e la sintassi XPath è possibile estrarre i nodi di testo in base alle loro coordinate:
from lxml import etree

# Caricamento e analisi del file XML prodotto
tree = etree.parse("fattura.xml")
root = tree.getroot()

# Estrazione di tutti i nodi di testo situati nell'area geometrica desiderata
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Combinando con flessibilità gli attributi @top, @left e @font, è possibile formulare regole di estrazione affidabili che resistono anche a lievi variazioni di impaginazione.
Risoluzione dei problemi: Documenti scansionati, OCR e privacy nella memoria RAM
Per assicurare la massima efficacia nell'elaborazione dei documenti, tieni a mente queste indicazioni pratiche:
1. Documenti scansionati privi di testo digitale
Se il documento PDF proviene da uno scanner ottico o fax senza riconoscimento ottico dei caratteri, il file conterrà solo immagini bitmap. Poiché il convertitore analizza testo vettoriale nativo, un PDF composto solo da immagini restituirà un XML privo di contenuti. Per rimediare, consulta la nostra guida su come estrarre testo da PDF con OCR per creare un livello di testo digitale prima di procedere alla conversione XML.
2. Gestione di archivi voluminosi a più pagine
Su documenti di centinaia di pagine, i file XML possono raggiungere dimensioni rilevanti per via del dettaglio delle coordinate. È consigliabile adottare algoritmi di compressione come Gzip per l'archiviazione e il trasferimento di rete.
3. Privacy e trattamento esclusivo in memoria RAM
Fatture, contratti e bilanci aziendali racchiudono informazioni riservate. La nostra piattaforma adotta i massimi requisiti di sicurezza:
- Elaborazione temporanea in RAM: L'analisi e la generazione dell'albero XML avvengono esclusivamente nella memoria RAM volatile dei server, senza memorizzazione su dischi permanenti.
- Eliminazione automatica dopo 5 minuti: Un demone di sistema rimuove in modo irreversibile tutti i buffer temporanei entro 5 minuti dal termine delle operazioni.
- Servizio gratuito senza registrazione: Non è richiesta alcuna e-mail o carta di credito, garantendo l'anonimato completo dell'utente.
- Assenza di watermark promozionali: I file XML prodotti sono puliti e pienamente conformi agli standard DTD ufficiali.
Esplora l'intera gamma di utilità professionali nella suite di strumenti tecnici per PDF di AZ2PDF direttamente dal tuo browser web.
❓ Domande Frequenti (FAQ)
La conversione in testo semplice perde completamente la collocazione spaziale dei contenuti, raggruppando colonne e intestazioni in una sequenza disordinata. Il formato CSV richiede tabelle regolari con griglie ben definite. L'XML conserva la posizione fisica di ogni parola attraverso gli attributi del riquadro delimitatore (top, left, width, height), permettendo ai software di estrarre i dati per zona geografica a prescindere dallo stile grafico.
Articoli Correlati su Questo Argomento
Scopri altre tecniche avanzate per organizzare le pagine e gestire i tuoi documenti.
Come convertire PDF in CSV online gratis (estrazione pulita di tabelle)
Scopri come convertire tabelle PDF in file CSV puliti e strutturati online gratis. Estrai estratti conto ed elenchi contabili senza colonne disallineate.
Come convertire PDF in testo online gratis (estrazione TXT pulita)
Scopri come estrarre testo non formattato da documenti PDF online gratuitamente. Converti pagine a più colonne in file TXT UTF-8 puliti per IA e codice.

Come estrarre testo da un PDF scansionato con OCR (Gratuito e Sicuro)
Scopri come convertire documenti cartacei scansionati e PDF fotografici in testo selezionabile e ricercabile con OCR multilingue gratuito. Veloce, preciso e al 100% privato nel browser.
Come convertire PDF in HTML online gratis (codice pulito e layout fedele)
Scopri come convertire documenti PDF in pagine web HTML5 e CSS responsive online gratis. Mantieni font, stili e grafica vettoriale senza filigrane.
Come convertire file HTML in PDF online senza perdere la formattazione
Scopri come convertire file HTML e stili CSS in documenti PDF pronti per la stampa online gratis. Mantieni caratteri esatti, interruzioni di pagina e layout senza watermark.
Come convertire PDF in EPUB online gratis (testo fluido per e-reader)
Scopri come convertire documenti PDF in e-book EPUB con testo fluido online gratis. Leggi comodamente su Kindle, Kobo e Apple Books senza affaticare gli occhi.