Cómo convertir PDF a XML online gratis (Datos estructurados con coordenadas)
Respuesta Directa y Conclusiones Clave
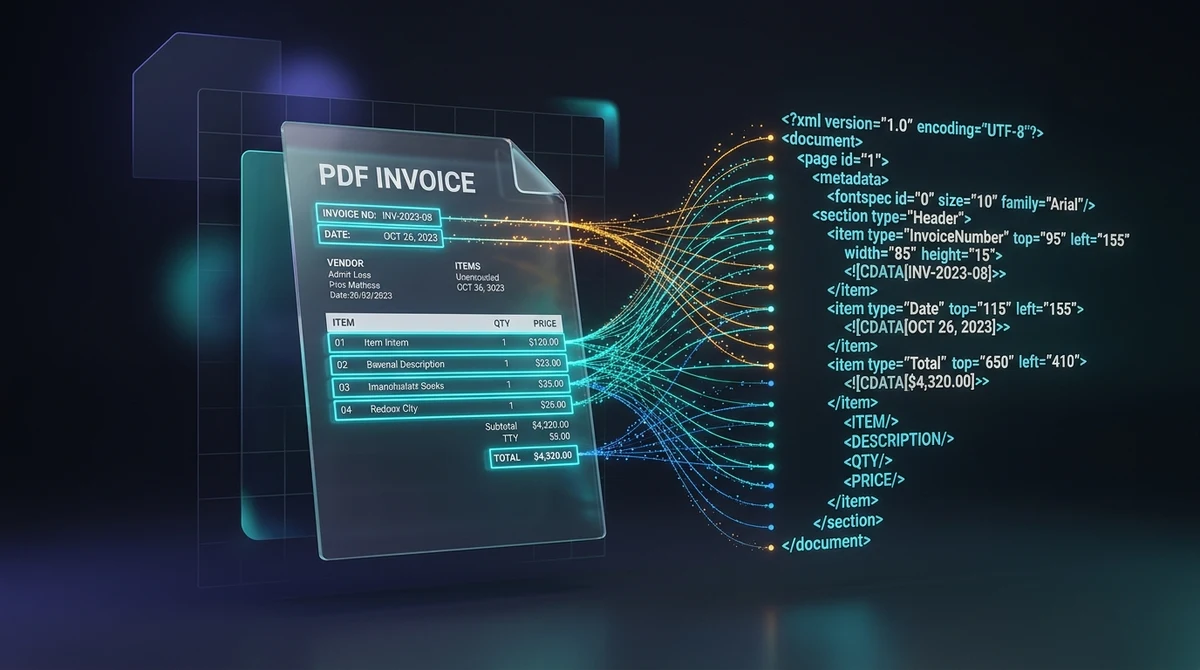
Para convertir un PDF a XML online gratis, usted transforma los diseños visuales de documentos en etiquetas jerárquicas de Extensible Markup Language con coordenadas espaciales absolutas (top, left, width, height) y atributos de fuente. Con el conversor AZ2PDF, ingenieros de datos, desarrolladores y analistas extraen nodos de texto estructurados y legibles por máquina en segundos, sin instalar software, 100% gratis y en memoria RAM volátil.
- Conservación de coordenadas espaciales: Cada elemento de texto se etiqueta con atributos geométricos exactos (top, left, width, height) y especificaciones de fuente para una extracción precisa.
- Datos jerárquicos legibles por máquina: Transforma páginas visuales rígidas en nodos XML estructurados (page, fontspec, text) listos para su procesamiento en Python, Node.js và sistemas ERP.
- Ideal para facturas y flujos ETL automatizados: Perfecto para analizar estados financieros de varias columnas, facturas B2B y formularios fiscales sin perder relaciones espaciales.
- 100% gratis y procesamiento instantáneo en RAM: AZ2PDF procesa sus archivos en la memoria RAM volátil del servidor, sin tarifas, sin registro, sin marcas de agua y con eliminación automática a los 5 minutos.
El problema de la extracción de datos: Por qué los PDF atrapan la información empresarial
En el entorno informático corporativo moderno, el formato Portable Document Format (PDF) es tanto un estándar imprescindible como un gran obstáculo para la automatización. Normalizado internacionalmente bajo la norma ISO 32000, el PDF destaca por su fidelidad visual: bloquea palabras, trazados vectoriales y márgenes en una réplica exacta de una página impresa. Ya se visualice en un ordenador, un teléfono móvil o una impresora de oficina, el documento permanece idéntico.
Sin embargo, lo que hace al PDF perfecto para los lectores humanos lo vuelve extraordinariamente complejo para los programas informáticos. Un archivo PDF no almacena un árbol semántico como una base de datos o una hoja de cálculo. No comprende intrínsecamente conceptos como fila, columna, subtotal o número de factura. Solo guarda instrucciones de dibujo gráfico: comandos directos como dibujar esta cadena de texto en las coordenadas X=150, Y=720.
Cuando programadores o analistas intentan extraer información con volcados de texto tradicionales, aparecen errores graves:
- Las tablas de varias columnas colapsan en una sola cadena de texto desordenada.
- Los encabezados, pies de página y números de página se mezclan aleatoriamente con las filas de datos.
- Las relaciones espaciales fundamentales (como saber que una cifra monetaria está situada debajo de un concepto impositivo) se pierden por completo.
Convertir su archivo PDF en Extensible Markup Language (XML) estructurado soluciona este obstáculo al capturar el texto junto a su geometría espacial en una jerarquía legible por máquina.
¿Qué es la conversión de PDF a XML y cómo es el resultado obtenido?
La conversión de PDF a XML traslada la maquetación visual de un documento a un modelo de objetos XML organizado según estándares de Definición de Tipo de Documento (como la especificación Poppler pdf2xml). En lugar de volcar texto plano, el motor agrupa elementos por página, clasifica propiedades tipográficas y asocia a cada fragmento de texto las coordenadas de su cuadro delimitador.
A continuación se muestra un fragmento representativo de la sintaxis XML resultante:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Con esta estructura nítida, sus scripts de automatización no tienen que deducir la posición de los datos. Analizando los atributos top, left, width y height, cualquier software localiza con exactitud los valores a partir de sus coordenadas en la página.
Coordenadas espaciales: Comprender top, left, width, height y fontspec
La ventaja decisiva de la extracción en XML radica en sus metadatos geométricos. Dominar el funcionamiento de estos atributos permite diseñar canalizaciones de datos sólidas:
- Límites del lienzo de página (<page>): El elemento raíz
<page>define las dimensiones del soporte físico (por ejemplowidth="918" height="1188"en puntos estándar), fijando la cuadrícula de coordenadas para todos los nodos secundarios. - Declaración de fuentes (<fontspec>): El analizador cataloga todas las tipografías del archivo y les asigna un identificador único (
font="0",font="1"). Cada etiqueta<fontspec>detalla familia tipográfica, tamaño en puntos y código hexadecimal de color, permitiendo discriminar títulos de notas al pie según el tamaño. - Coordenadas top y left: El atributo
topindica la distancia vertical en puntos desde el borde superior hasta la línea base del texto. El atributoleftmarca el desplazamiento horizontal respecto al margen izquierdo. - Atributos width y height: Establecen el ancho y alto del cuadro delimitador, facilitando el cálculo de anchos de columna y la comprobación de alineaciones horizontales.
- Etiquetas de estilo en línea: Las variantes en negrita (
<b>) y cursiva (<i>) se preservan directamente en los nodos de texto para facilitar el reconocimiento de etiquetas clave.
Convierta documentos en conjuntos de datos legibles por máquina con el conversor de PDF a XML de AZ2PDF, que extrae coordenadas y jerarquías semánticas en etiquetas XML estándar.
Cómo convertir PDF a XML online en 3 sencillos pasos
El proceso para convertir sus documentos PDF en XML estructurado se completa en menos de un minuto desde cualquier navegador web:
Paso 1: Suba su documento PDF
Arrastre y suelte su factura, balance contable o informe técnico en la casilla de carga, o pulse para elegir el archivo desde su ordenador o dispositivo móvil.
Paso 2: Procesamiento automático de datos espaciales
Nuestro motor analiza el flujo de objetos PDF en la memoria RAM volátil del servidor. Identifica fragmentos de texto, calcula geometrías perimetrales, extrae fuentes y compone un árbol XML estándar.
Paso 3: Descargue su archivo XML estructurado
Haga clic en Descargar para guardar su archivo .xml listo para usar. Puede abrirlo en editores de código o integrarlo en su flujo de datos empresarial sin necesidad de registro. Si solo requiere tablas numéricas sencillas, también puede consultar cómo convertir PDF a CSV online para trabajar directamente en Excel.
Casos de uso estratégicos: Facturas, flujos ETL y entrenamiento de Document AI
La conversión de PDF a XML es el pilar de automatizaciones masivas en diversos sectores empresariales:
- Gestión automatizada de facturas y contabilidad: Los departamentos financieros reciben miles de facturas mensuales con diseños dispares. Las expresiones regulares tradicionales fallan con frecuencia ante estos cambios. Con XML, los scripts seleccionan áreas de coordenadas fijas (por ejemplo, el cuadrante superior derecho con número y fecha de vencimiento).
- Canalizaciones ETL (Extract, Transform, Load): Los almacenes de datos procesan regularmente informes trimestrales y pólizas. El formato XML proporciona un estándar neutral que se integra sin fricciones en Apache Spark, Python Airflow y bases de datos relacionales.
- Entrenamiento de modelos Document AI y LayoutLM: Los modelos de aprendizaje profundo requieren tanto el texto como las cajas delimitadoras bidimensionales para interpretar la estructura documental. El XML generado provee las entradas geométricas idóneas.
- Intercambio electrónico de datos B2B (EDI): Las plataformas ERP (SAP, Oracle) necesitan datos estructurados para procesar pedidos de compra. Convertir pedidos PDF en XML conecta la información visual con la gestión automatizada del ERP.
Análisis práctico: Uso de Python, lxml y XPath en su XML generado
Una vez descargado el archivo XML, escribir un script de extracción en Python resulta muy sencillo. La librería lxml con consultas XPath permite aislar nodos de texto por sus coordenadas:
from lxml import etree

# Cargar y parsear el archivo XML obtenido
tree = etree.parse("factura.xml")
root = tree.getroot()

# Filtrar nodos de texto situados en una región geométrica concreta
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Combinando los atributos @top, @left y @font, usted construye filtros estables que toleran pequeños cambios de maquetación en los documentos.
Solución de problemas: Documentos escaneados, OCR y privacidad en RAM
Para asegurar un procesamiento óptimo en sus proyectos, considere estas pautas técnicas:
1. Documentos escaneados sin texto digital
Si su PDF proviene de un escáner óptico o fax sin reconocimiento de texto, el archivo solo contendrá imágenes de mapa de bits. Como el conversor extrae texto vectorial nativo, un PDF de solo imágenes generará un XML vacío. Para resolverlo, revise nuestra guía sobre cómo extraer texto de PDF con OCR para generar una capa de texto digital antes de convertirlo a XML.
2. Gestión de archivos grandes con múltiples páginas
En documentos de cientos de páginas, el XML resultante puede alcanzar tamaños notables debido a la descripción pormenorizada de coordenadas. Aplique algoritmos de compresión como Gzip para almacenar o transferir los datos con eficiencia.
3. Seguridad y procesamiento estricto en memoria RAM
Facturas comerciales, contratos legales y datos fiscales albergan información corporativa sensible. Nuestra infraestructura implementa protocolos de seguridad rigurosos:
- Ejecución exclusiva en memoria RAM: La descomposición sintáctica y la generación del árbol XML se ejecutan únicamente en memoria RAM volátil, sin almacenarse en discos duros.
- Borrado automático a los 5 minutos: Un servicio en segundo plano purga de forma irreversible cualquier búfer temporal dentro de los cinco minutos siguientes al procesamiento.
- Gratuito y sin registro: No se solicitan correos electrónicos ni tarjetas bancarias, manteniendo su anonimato absoluto.
- Sin marcas de agua comerciales: Su XML se entrega limpio y acorde a las especificaciones DTD.
Descubra más utilidades de alto rendimiento en el conjunto de herramientas técnicas para PDF de AZ2PDF directamente desde su navegador.
❓ Preguntas Frecuentes (FAQ)
La conversión a texto plano descarta la información espacial, mezclando columnas y encabezados en un flujo lineal continuo. El formato CSV requiere tablas de cuadrícula regulares. El formato XML preserva la ubicación exacta de cada término en la página mediante atributos de caja delimitadora (top, left, width, height), permitiendo extraer datos por zonas de coordenadas independientemente del diseño visual.
Artículos Relacionados con este Tema
Profundice en técnicas profesionales de organización de páginas y gestión documental.
Cómo convertir PDF a CSV online gratis (extracción limpia de tablas)
Aprenda a convertir tablas PDF en archivos CSV limpios y estructurados online gratis. Extraiga extractos bancarios y facturas sin desajustes de columnas.
Cómo convertir PDF a texto online gratis (extracción TXT limpia)
Aprenda a extraer texto sin formato de documentos PDF online y gratis. Convierta páginas en columnas en archivos TXT UTF-8 limpios para IA y código.

Cómo extraer texto de un PDF escaneado con OCR (Gratis y Seguro)
Aprenda a convertir documentos en papel escaneados y fotos PDF en texto seleccionable y editable con OCR multilingüe gratuito. Rápido, preciso y 100 % privado en su navegador.
Cómo convertir PDF a HTML online gratis (código limpio y maquetación exacta)
Aprenda a convertir documentos PDF en páginas web HTML5 y CSS responsivas online y gratis. Conserve fuentes, estilos y gráficos vectoriales sin marcas de agua.
Cómo convertir archivos HTML a PDF online sin perder formato
Aprende a convertir gratis online archivos HTML y estilos CSS en documentos PDF listos para imprimir. Mantén fuentes exactas, saltos de página y diseño sin marcas de agua.
Cómo convertir PDF a EPUB online gratis (texto adaptable para lectores electrónicos)
Aprenda a convertir documentos PDF en libros electrónicos EPUB de diseño fluido online y gratis. Lea cómodamente en Kindle, Kobo y Apple Books sin fatiga visual.