如何在线免费解压PDF数据流(提取原始代码与FlateDecode解码)
核心解答与重点摘要
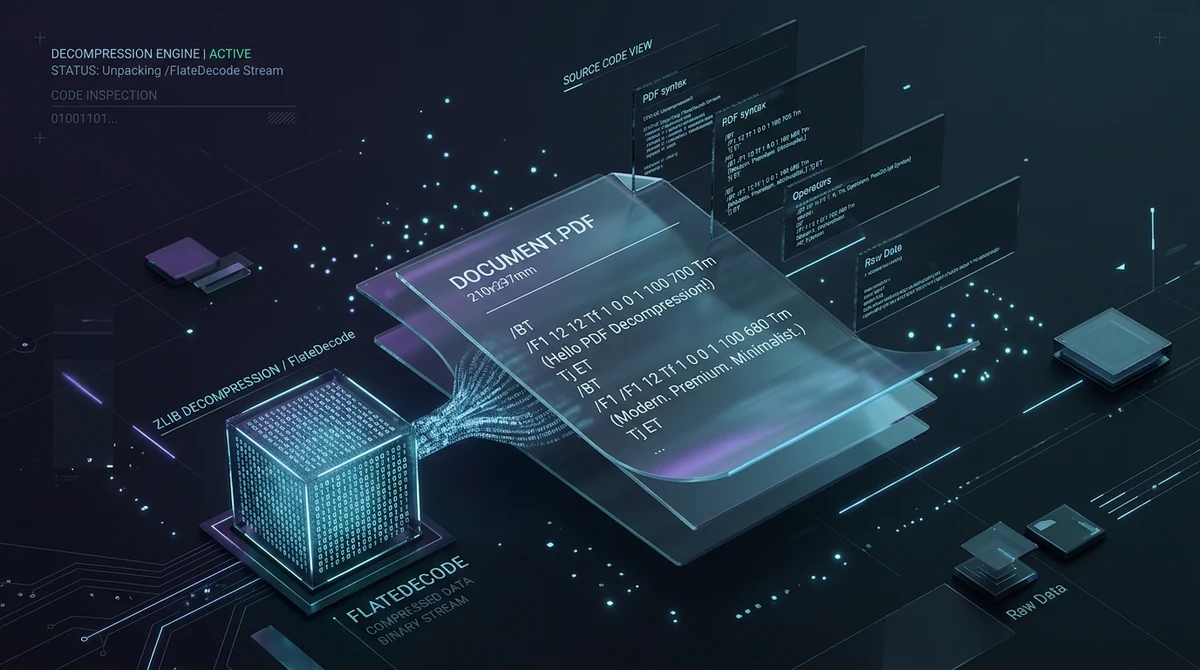
在线免费解压PDF数据流是指遵循ISO 32000国际标准,将文档内部经过压缩的二进制数据流(如FlateDecode、LZWDecode、ASCII85Decode等)展开为纯文本格式的PostScript与PDF指令。借助AZ2PDF数据流解压工具,开发者、安全审计员与印前技术人员无需安装任何软件,即可在浏览器中安全、快速地检查页面绘图算子。
- 还原PDF原始代码:将无法阅读的FlateDecode二进制数据块转换为清晰、可编辑的PostScript风格文本操作符(BT、ET、Tf、Tj、cm、re、f)。
- 开发者调试利器:快速排查页面渲染异常、字体编码冲突、边界框错位以及损坏的矢量路径,无需本地编译命令行工具。
- 安全取证与漏洞审计:穿透多层Deflate压缩屏障,直接检查隐藏的JavaScript字典、启动动作与结构异常。
- 100%免费且纯内存安全处理:所有解析操作仅在服务器临时易失内存中运行,无需注册账号,无水印,5分钟内全自动彻底清除。
PDF内部的隐秘代码:为什么数据流默认全部压缩
对绝大多数普通用户来说,PDF文件就像一张数字打印纸或一张静态图像。只需双击打开,阅读器就会呈现出整齐的排版、清晰的徽标和规整的表格。然而,在直观的视觉界面之下,深藏着一套受国际标准ISO 32000严格管辖的面向对象编程语言体系。
一份标准的PDF文件由离散对象组合而成:字典(Dictionary)、数组(Array)、数值、字符串以及最核心的数据流(Streams)。数据流是承载文档主要体积的连续字节序列,负责存储页面绘图指令、矢量路径坐标、内嵌字体程序及元数据。
如果所有页面的内容流都以纯ASCII文本存储,文件体积将迅速膨胀失控。一份仅有20页、带有重复排版坐标的普通报表,其纯文本体积很容易达到几十兆字节。为了解决这一痛点,PDF生成器(如Adobe Acrobat、Ghostscript、Puppeteer等)普遍采用数学算法对内部流进行压缩。虽然这让文档变得轻巧,却也将内部语法变成了普通文本编辑器无法识别的二进制乱码。
为了检查、修复或逆向分析文档底层的绘制逻辑,我们需要在不损坏文件结构的前提下,使用 AZ2PDF 解压工具将这些数据流精准还原为明文。
什么是FlateDecode?为何直接打开PDF源码全是乱码
当你使用Visual Studio Code、Sublime Text或记事本等代码编辑器强行打开一份普通PDF时,你或许能看懂开头的版本标识(如 %PDF-1.7)以及基础的字典键(如 /Type /Catalog 或 /Pages)。但只要光标滚动到真正的内容流区域,文本就会瞬间变成一堆杂乱无章的乱码和乱字符。
以下是数据流开始前典型的对象字典示例:
5 0 obj
<<
  /Length 1420
  /Filter /FlateDecode
>>
stream
xœí[msÛ8 … [无法辨识的二进制乱码] …
endstream
endobj
导致这段代码无法阅读的关键属性正是 /Filter /FlateDecode。在PDF技术规范中,FlateDecode代表着工业标准的zlib/deflate压缩算法(定义于RFC 1950与RFC 1951)。Deflate算法会检索流中的重复字节序列,将其替换为位级别的向后指针,并通过霍夫曼编码将数据体积压缩至极小。
由于数据在比特位层级被打包,代码编辑器无法将其解析为正常的UTF-8或ASCII字符。日常查看时,阅读器会在内存中自动完成解压与渲染;但对程序员和安全研究人员而言,这堵二进制高墙彻底阻断了直接审查代码的可能性。
核心应用场景:哪些专业人士需要解压PDF内部数据流
解压PDF内部数据流会使文件体积成倍增加,因此它绝非用于日常文件传输,而是多门专业技术领域不可或缺的底层诊断工具:
- 构建PDF生成管线的后端开发工程师: 当使用pdf-lib、ReportLab、FPDF、Puppeteer或Apache PDFBox等开源库编写生成脚本时,经常会遇到奇怪的渲染缺陷——文本错位重叠、字体字符间距失效、或者裁剪框意外切掉了页眉。通过解压输出的PDF,开发者可以在VS Code中直接审查精确的绘图坐标与矩阵变换(如
cm与Tm算子),迅速定位代码中的Bug。 - 印前制版工程师与专业印刷技术员: 商业印刷对色彩准确度与字体嵌入规范有着极高要求。技术人员解压PDF,以核实内嵌字体是否具备合规的ToUnicode CMap映射表、直接查看CMYK分色通道,并在开机印刷前确认专色定义无误。
- 网络安全分析师与数字取证专家: 攻击者经常将恶意JavaScript载荷或隐藏的重定向链接藏匿在经过压缩的数据流中。传统杀毒软件有时难以穿透多层嵌套压缩。将整个对象树彻底解压,能够直接暴露出隐藏的
/JavaScript字典与异常的交叉引用表项。 - 研读ISO 32000规范的技术人员与学生: 研读上千页晦涩的技术规范极为抽象。在编辑器中打开一份干净、解压后的PDF,能够直观看到页面、资源字典与内容操作符之间是如何紧密联动的。
基于ISO 32000规范的PDF数据流解压底层原理解析
解压PDF文件远比用WinRAR解压ZIP压缩包要精细得多。PDF并不是一个简单的打包容器,而是一个相互引用的对象图。如果粗暴地对整个文件运行解压算法,会直接破坏文件头与交叉引用表,导致文档彻底损坏无法打开。
- 交叉引用表映射(XRef Mapping): 解析器首先读取PDF尾部信息(Trailer),将交叉引用表载入内存,建立所有间接对象(如
1 0 R、2 0 R)的地址索引。 - 流对象识别与过滤器检测: 遍历文档对象树,定位包含数据流的对象,并检查其字典中的过滤器键值:
/Filter和/DecodeParms(支持FlateDecode、LZWDecode、ASCII85Decode等)。 - 内存载荷解码(Payload Inflation): 压缩的二进制数据在内存流中完成还原,展开为原始未压缩字节。
- 剥离过滤器键值: 从对象字典中移除
/Filter与/DecodeParms,通知后续阅读器该数据流现已处于未压缩明文状态。 - 重算数据流长度(/Length): 由于数据流从紧凑的二进制膨胀为明文,原先记录的长度数值已失效。引擎重新计算准确的未压缩字节总数,并更新
/Length整数。 - 未压缩序列化与XRef重建: 以未压缩参数重新序列化文档,全量重新计算所有对象的字节偏移量(Byte Offset)并重构XRef表,确保生成的文件在任何标准阅读器中都能稳定打开。
在线解压PDF内部数据流的3个简单步骤
在以往,提取PDF原始流需要安装命令行工具、配置编译器环境或编写Python脚本。现在,通过现代浏览器即可在数秒内免费完成:
步骤 1:上传需要检查的PDF文档
进入PDF数据流解压工具页面,将PDF文件拖入上传区域,或从本地磁盘选取。工具在Windows、macOS、Linux、iOS和Android浏览器上均可流畅运行。
步骤 2:自动化引擎在内存中展开内部流
文件载入后,引擎立即在服务器易失性内存中遍历文档结构。它将自动定位所有FlateDecode数据流,解压还原为纯文本,移除过滤字典,并全自动修正字节偏移量。
步骤 3:下载解压后的PDF并在编辑器中检查
处理完毕后即可立即下载解压后的文档。使用VS Code或Notepad++等编辑器打开文件,即可随心所欲地搜索、分析与编辑原始语法。如果在检查过程中发现文件原本存在交叉引用表断裂问题,可参考如何在线修复损坏的PDF文件来彻底恢复数据结构。
读懂PDF原始语法:文本编辑器中常见的页面绘图操作符
用代码编辑器打开解压后的PDF后,原本神秘的二进制乱码已荡然无存,取而代之的是规整的PostScript风格绘图操作符:
5 0 obj
<<
  /Length 284
>>
stream
q
1 0 0 1 50 720 cm
BT
/F1 16 Tf
18 TL
(Welcome to Document Engineering) Tj
T*
/F2 11 Tf
(All page content streams are now fully human-readable.) Tj
ET
0.2 0.4 0.8 rg
50 680 500 2 re
f
Q
endstream
endobj
掌握以下常见操作符即可轻松阅读页面指令:
q与Q:保存与恢复图形状态栈(锁定当前线宽、颜色与变换矩阵)。cm:当前变换矩阵(Current Transformation Matrix),精确控制页面元素的坐标定位、缩放比例与旋转角度。BT与ET:文本块开始(Begin Text)与结束(End Text)。所有文字绘制必须在这两个操作符之间进行。/F1 16 Tf:指定调用F1字体资源,并将字号设置为16点。Tj:在页面上绘制括号内的文字字符串。你可以直接看到具体的文本内容。T*:根据行距(TL)参数将文字光标移动到下一行起点。re与f:定义矩形矢量区域(x, y, 宽度, 高度),并用当前填充色进行实心填充。
当数据流变为明文后,排查某行丢失的文本或定位某个图片偏离原位的坐标,只需在编辑器中按下Ctrl+F搜索即可轻松解决。
在线网页工具与命令行程序(qpdf、mutool)的对比
在传统的开发环境中,工程师通常在终端中使用以下两款命令行工具来解压PDF数据流:
- qpdf 命令行格式:
qpdf --qdf --object-streams=disable input.pdf output.pdf - mutool 命令行格式:
mutool clean -d input.pdf output.pdf
这些CLI程序固然强大,但在日常工作协同中存在明显壁垒:
- 需要配置Homebrew或apt软件包管理器,并安装底层C++编译依赖。
- 在受企业安全策略锁定的办公电脑、Chromebook或移动设备上无法安装运行。
- 非技术岗位(如法务人员或设计审核人员)不熟悉终端指令与文件路径操作。
在线工具在浏览器端提供了同等级别的工业级流解压体验,免去了所有环境配置与终端操作成本。
技术考量:文件体积激增的原因及何时需要重新压缩
在处理解压后的PDF时,需要注意以下两个客观技术特征:
1. 文件体积显著增大
FlateDecode压缩算法对矢量线条和排版指令的压缩率通常在60%到85%之间。将这些数据还原为明文后,原先500KB的文件可能会膨胀到2MB甚至4MB。因此,解压后的文件应当用于开发、测试和代码审计,不适宜作为最终交付版本进行外发。
2. 图像数据流的处理机制
PDF内部嵌入的摄影图片通常采用专用的图像压缩滤镜,如用于JPEG的 /DCTDecode。解压操作只展开FlateDecode文本指令与字体字典,不会将JPEG二进制强行转换为无意义的文本字符。图片仍保持为标准的点阵位图,保证在普通阅读器中依然能完美显示。
3. 排查完成后重新压缩
在完成底层语法排查或手动微调后,建议在分发前对文件进行重新压缩与优化,以便节约网络传输带宽。
隐私至上:纯内存临时计算与服务器零残留保障
送检进行底层排查的PDF文件通常包含私有源代码、未公开商业合同或敏感财务报表。使用在线工具时,数据安全性不容妥协。
AZ2PDF坚持执行严苛的隐私保护规范:
- 纯易失性RAM内存运行: 文档解析、数据流还原与XRef重建完全在易失性内存中进行,严禁向服务器物理磁盘写入任何文件。
- 5分钟自动彻底销毁: 后台常驻守护进程持续巡检,在处理完成后5分钟内彻底销毁所有临时内存缓冲。
- 100%免费且无需注册: 无需提供电子邮箱、无需绑定信用卡,保障全流程匿名操作。
- 绝不添加推广水印: 生成的PDF保持100%纯净,绝不附带任何第三方水印或试用标识。
欢迎访问安全高效的AZ2PDF在线PDF专业处理中心,在零隐私泄露风险的前提下,轻松完成深度文档工程分析。
❓ 常见问题解答 (FAQ)
因为标准PDF文档默认使用zlib Deflate算法(通过/Filter /FlateDecode字典键定义)对其页面内容流和字体数据进行了压缩。代码编辑器试图将压缩后的二进制字节强行作为文本字符显示,因而呈现为杂乱的乱码。解压流操作会剥离这些压缩过滤器,将二进制还原为明文指令。
同主题精选文章
进一步探索专业的 PDF 页面管理与文档组织技巧。
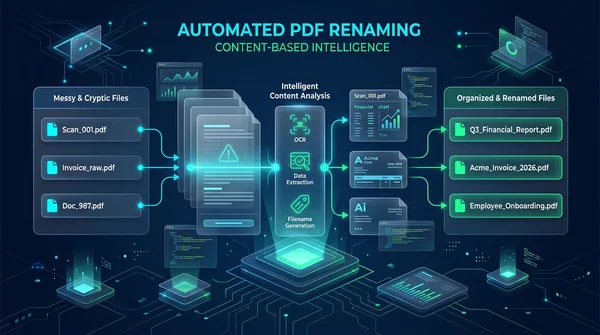
如何根据内容在线免费自动重命名PDF文件
了解如何根据文档内容和元数据标题标签在线免费自动重命名PDF文件。无需手动打开,轻松规范扫描件与发票文件名且零画质损失。

如何在线修复损坏的PDF文件(免费且安全)
学习如何在线免费修复受损或无法打开的PDF文件。重建损坏的xref交叉引用表,恢复二进制数据流并安全找回重要文档。

如何在线自动检测并删除扫描PDF中的空白页(免费无水印)
了解如何免费在线自动检测并删除扫描PDF文件中的空白页。消除双面扫描产生的无用空白纸张,不损画质且无需手动逐页排查。
如何将PDF转换为符合ISO标准的PDF/A以实现长期归档
免费在线将PDF文档转换为符合ISO 19005标准的PDF/A归档格式。完整嵌入字体、标准化ICC色彩配置文件并确保长期法律效力。

如何免费为PDF设置密码保护(军用级AES-256高强度加密)
了解如何使用军工级AES-256算法在线免费为PDF设置密码加密。无水印保护机密商业合同、薪资账单与财务报表,严守数据隐私。

在线解除PDF密码保护与权限限制方法(永久去除密码并安全解密)
学习如何在线免费去除已获授权PDF文件的打开密码与打印复制权限限制。内存安全解密,绝无水印,保障企业与个人隐私。