Jak przekonwertować PDF na XML online za darmo (strukturyzowane dane z koordynatami)
Bezpośrednia Odpowiedź i Kluczowe Wnioski
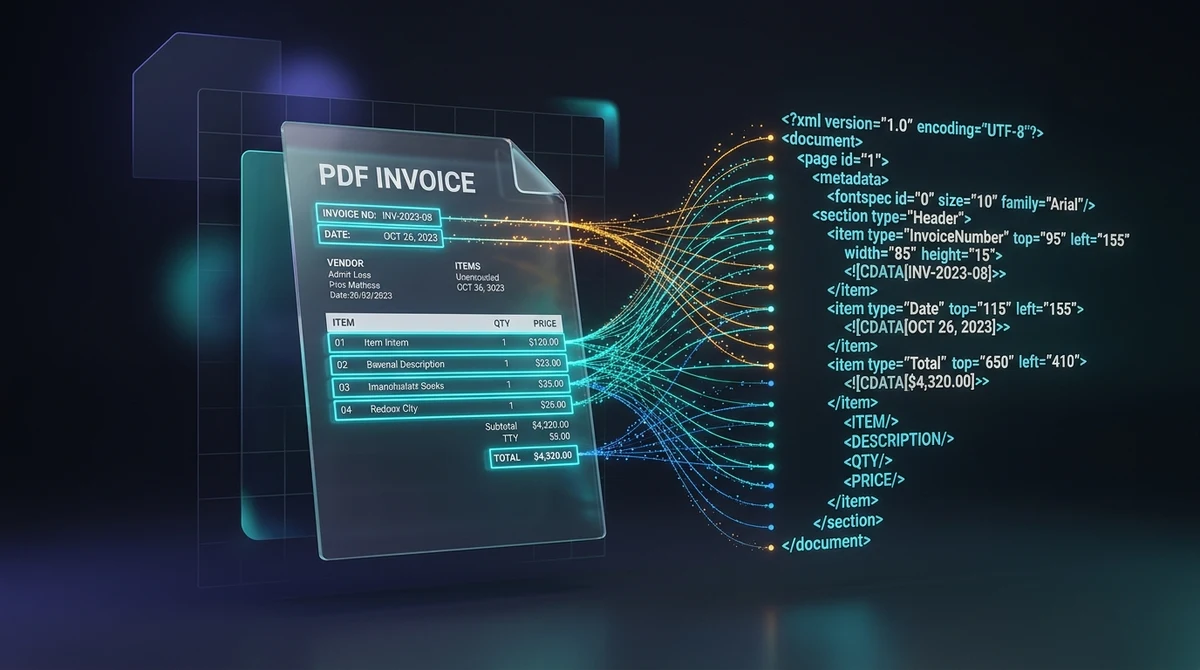
Konwersja pliku PDF na XML online za darmo polega na przekształceniu wizualnego układu dokumentu w hierarchiczne znaczniki Extensible Markup Language zawierające bezwzględne współrzędne przestrzenne (top, left, width, height) i specyfikacje czcionek. Za pomocą konwertera AZ2PDF inżynierowie danych i programiści mogą wyodrębnić czytelne maszynowo węzły tekstu w kilka sekund, całkowicie bezpłatnie i bezpiecznie w pamięci RAM.
- Zachowanie współrzędnych przestrzennych: Każdy element tekstowy otrzymuje dokładne atrybuty ramki otaczającej (top, left, width, height) oraz właściwości czcionki dla precyzyjnej ekstrakcji.
- Ustrukturyzowane dane czytelne maszynowo: Przekształca sztywne strony wizualne w ustrukturyzowane węzły XML (page, fontspec, text), gotowe do automatycznego przetwarzania w Pythonie, Node.js i systemach ERP.
- Niezastąpione przy fakturach i potokach ETL: Doskonałe do przetwarzania wielokolumnowych sprawozdań finansowych, faktur B2B i formularzy podatkowych bez utraty relacji przestrzennych.
- 100% za darmo i natychmiastowe przetwarzanie w RAM: AZ2PDF przetwarza pliki w ulotnej pamięci RAM serwera bez opłat, bez rejestracji, bez znaków wodnych i z automatycznym usuwaniem po 5 minutach.
Problem ekstrakcji danych: Dlaczego PDF blokuje informacje biznesowe
W nowoczesnych systemach IT format Portable Document Format (PDF) jest niezastąpionym standardem wizualnym, a jednocześnie poważną barierą dla automatyzacji procesów. Ustandaryzowany międzynarodowo normą ISO 32000 format PDF doskonale radzi sobie z prezentacją: utrwala litery, grafiki wektorowe i marginesy w wiernej cyfrowej kopii wydrukowanej strony. Niezależnie od urządzenia czy drukarki, dokument prezentuje się identycznie.
To, co czyni PDF idealnym dla ludzkiego oka, staje się koszmarem dla programów komputerowych. Plik PDF nie przechowuje semantycznego drzewa danych, takiego jak tabela bazy danych czy arkusz kalkulacyjny. Nie rozumie, czym jest wiersz, kolumna, suma częściowa czy numer faktury. Zawiera jedynie graficzne instrukcje rysowania: komendy takie jak narysuj ten ciąg znaków na współrzędnych X=150, Y=720.
Gdy inżynierowie próbują wydobyć tekst standardowymi narzędziami do zrzutu tekstu, pojawiają się poważne komplikacje:
- Wielokolumnowe tabele zlewają się w jeden nieuporządkowany ciąg znaków.
- Nagłówki, stopki i numery stron wplatają się losowo między wiersze danych.
- Zależności przestrzenne (np. to, że kwota znajduje się bezpośrednio pod etykietą podatku) znikają bezpowrotnie.
Konwersja pliku PDF na ustrukturyzowany Extensible Markup Language (XML) rozwiązuje ten problem, zachowując zarówno zawartość tekstową, jak i precyzyjną dwuwymiarową geometrię w czytelnej maszynowo strukturze.
Czym jest konwersja PDF na XML i jak wygląda wynikowy format?
Konwersja PDF na XML bada wizualny układ dokumentu i odwzorowuje go w uporządkowanym modelu obiektowym XML zgodnym z oficjalnymi definicjami DTD (np. standardem Poppler pdf2xml). Zamiast płaskiego ciągu tekstu silnik grupuje elementy według stron, indeksuje właściwości typograficzne i przypisuje każdemu fragmentowi tekstu współrzędne ramki otaczającej (bounding box).
Oto rzeczywisty fragment wygenerowanej składni XML:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Dzięki tej uporządkowanej strukturze skrypty automatyzujące nie muszą zgadywać układu danych. Odczytując atrybuty top, left, width i height, dowolna aplikacja może natychmiast zlokalizować poszukiwane wartości na podstawie ich fizycznych współrzędnych.
Współrzędne przestrzenne: Zrozumienie atrybutów top, left, width, height i fontspec
Prawdziwa siła ekstrakcji XML tkwi w szczegółowych metadanych geometrycznych. Zrozumienie tych właściwości pozwala na tworzenie niezawodnych potoków danych:
- Wymiary strony (<page>): Element główny
<page>definiuje fizyczny rozmiar arkusza (np.width="918" height="1188"w punktach standardowych), wyznaczając układ odniesienia dla wszystkich elementów podrzędnych. - Deklaracje czcionek (<fontspec>): Parser indeksuje wszystkie użyte kroje pisma i nadaje im unikalne identyfikatory (
font="0",font="1"). Każdy znacznik<fontspec>określa rodzinę czcionki, stopień pisma i kod koloru hex, co pozwala na automatyczne odróżnianie nagłówków od przypisów na podstawie rozmiaru. - Współrzędne top i left: Atrybut
topwskazuje odległość pionową od górnej krawędzi strony do linii bazowej tekstu. Atrybutleftokreśla przesunięcie poziome od lewego marginesu. - Wymiary width i height: Definiują szerokość i wysokość ramki tekstu, ułatwiając kalkulację kolumn oraz weryfikację wyrównania w linii poziomej.
- Wewnętrzne znaczniki stylów: Pogrubienie (
<b>) i kursywa (<i>) są zachowywane wewnątrz węzłów tekstu, co przyspiesza wykrywanie kluczowych etykiet.
Przekształć dokumenty w ustrukturyzowane zbiory danych za pomocą konwertera PDF na XML AZ2PDF, który analizuje współrzędne i hierarchię do standardowych znaczników XML.
Jak przekonwertować PDF na XML online w 3 prostych krokach
Konwersja dokumentu PDF na ustrukturyzowany plik XML zajmuje mniej niż minutę bezpośrednio w przeglądarce:
Krok 1: Prześlij dokument PDF
Przeciągnij i upuść fakturę, sprawozdanie finansowe lub specyfikację techniczną w polu przesyłania albo wybierz plik z pamięci urządzenia.
Krok 2: Automatyczne przetwarzanie danych przestrzennych
Nasz wydajny silnik analizuje strukturę obiektów PDF w ulotnej pamięci RAM serwera. Mapuje bloki tekstu, wylicza geometrie obrysów, odczytuje tabele czcionek i buduje prawidłowe drzewo XML.
Krok 3: Pobierz gotowy plik XML
Kliknij Pobierz, aby zapisać plik .xml. Możesz go natychmiast otworzyć w edytorze kodu lub włączyć do systemów firmowych bez rejestracji. Jeśli potrzebujesz przetwarzać proste tabele liczbowe, sprawdź także jak przekonwertować PDF na CSV online i pracować bezpośrednio w Excelu.
Kluczowe zastosowania: Faktury, potoki ETL i trenowanie Document AI
Przekształcanie dokumentów PDF na XML jest fundamentem procesów automatyzacji w wielu branżach:
- Automatyczne księgowanie faktur zakupowych: Działy finansowe przetwarzają tysiące faktur o różnych szablonach. Wyrażenia regularne (regex) często zawodzą przy zmianach w układzie. Dzięki formatowi XML skrypty mogą odwoływać się do stałych stref współrzędnych (np. prawego górnego rogu z numerem faktury i datą płatności).
- Potoki ETL (Extract, Transform, Load): Hurtownie danych cyklicznie agregują raporty kwartalne i polisy. XML oferuje neutralny standard, który bez trudu integruje się z Apache Spark, Python Airflow i relacyjnymi bazami danych.
- Trenowanie modeli Document AI i LayoutLM: Nowoczesne sieci neuronowe analizujące układ dokumentów wymagają zarówno tokenów tekstowych, jak i dwuwymiarowych ramek bounding box. Plik XML dostarcza gotowych danych przestrzennych.
- Elektroniczna wymiana danych B2B (EDI): Systemy ERP (SAP, Oracle) wymagają danych strukturalnych do generowania zamówień. Konwersja zamówień z PDF na XML łączy świat druku z automatyzacją procesów ERP.
Praktyczny parsing: Wykorzystanie Pythona, lxml i XPath w plikach XML
Po pobraniu pliku XML napisanie skryptu wyodrębniającego w Pythonie jest wyjątkowo proste. Biblioteka lxml i zapytania XPath pozwalają precyzyjnie filtrować węzły tekstu według współrzędnych:
from lxml import etree

# Wczytanie i przetworzenie wygenerowanego pliku XML
tree = etree.parse("faktura.xml")
root = tree.getroot()

# Pobranie węzłów tekstu w zadanym obszarze geometrycznym
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
    print(f"{coordinates}: {text_node.text}")
Łącząc atrybuty @top, @left i @font, tworzy się odporne reguły ekstrakcji, które radzą sobie z drobnymi przesunięciami szablonu.
Rozwiązywanie problemów: Zeskanowane dokumenty, OCR i bezpieczeństwo w RAM
Aby zapewnić bezproblemowy przebieg przetwarzania dokumentów, warto pamiętać o kilku zasadach technicznych:
1. Zeskanowane dokumenty bez warstwy tekstu cyfrowego
Jeśli plik PDF powstał ze skanera bez optycznego rozpoznawania znaków, zawiera wyłącznie mapy bitowe. Ponieważ konwerter wyodrębnia natywny tekst wektorowy, plik złożony z samych obrazów da pusty plik XML. Zapoznaj się z naszym poradnikiem jak wyodrębnić tekst z PDF za pomocą OCR, aby dodać warstwę tekstową przed konwersją do XML.
2. Zarządzanie obszernymi wielostronicowymi archiwami
W przypadku wielusetstronicowych dokumentów pliki XML mogą osiągać znaczne rozmiary z uwagi na szczegółowość współrzędnych. Zaleca się stosowanie kompresji Gzip podczas archiwizacji i transferu sieciowego.
3. Pełna poufność i przetwarzanie w pamięci RAM
Faktury, umowy i dokumenty finansowe zawierają tajemnice przedsiębiorstwa. Nasza platforma przestrzega rygorystycznych procedur bezpieczeństwa:
- Przetwarzanie wyłącznie w RAM: Parsowanie i generowanie pliku XML odbywa się wyłącznie w ulotnej pamięci operacyjnej serwera, bez zapisu na dyskach trwałych.
- Automatyczne usuwanie po 5 minutach: Proces w tle bezpowrotnie niszczy wszystkie bufory tymczasowe w ciągu 5 minut od zakończenia operacji.
- Całkowicie za darmo bez konta: Nie wymagamy podawania adresu e-mail ani danych płatniczych, co zapewnia pełną anonimowość.
- Brak znaków wodnych: Plik XML jest w 100% czysty i zgodny z oficjalnymi standardami DTD.
Poznaj pełny techniczny zestaw narzędzi PDF AZ2PDF bezpośrednio w oknie swojej przeglądarki.
❓ Często Zadawane Pytania (FAQ)
Zwykły tekst usuwa wszystkie relacje przestrzenne, powodując zlanie się kolumn i nagłówków w chaotyczny ciąg. CSV wymaga sztywnej siatki wierszy i kolumn. XML zachowuje dokładną fizyczną lokalizację każdego słowa za pomocą atrybutów ramki (top, left, width, height), co pozwala programom wyodrębniać dane na podstawie współrzędnych bez względu na styl graficzny tabeli.
Powiązane Artykuły w Tej Tematyce
Dowiedz się więcej o profesjonalnej organizacji stron i zarządzaniu plikami PDF.
Jak przekonwertować PDF na CSV online za darmo (czyste wyodrębnianie tabel)
Dowiedz się, jak bezpłatnie konwertować tabele PDF na czyste pliki CSV online. Wyodrębniaj wyciągi bankowe i faktury bez przesunięć kolumn i znaków wodnych.
Jak przekonwertować PDF na tekst online za darmo (czysta ekstrakcja TXT)
Dowiedz się, jak bezpłatnie wyodrębnić czysty tekst z plików PDF online. Przekształć wielokolumnowe dokumenty w czyste pliki TXT UTF-8 dla AI i programowania.

Jak wyodrębnić tekst ze skanowanego PDF za pomocą OCR (Darmowe & Bezpieczne)
Dowiedz się, jak przekonwertować zeskanowane dokumenty papierowe i zdjęcia PDF na przeszukiwalny i edytowalny tekst za pomocą darmowego wielojęzycznego OCR. Szybko, precyzyjnie i w 100% prywatnie w przeglądarce.
Jak przekonwertować PDF na HTML online za darmo (czysty kod i układ)
Dowiedz się, jak przekonwertować dokumenty PDF na responsywne strony HTML5 i CSS online za darmo. Zachowaj czcionki, formatowanie i grafikę bez znaków wodnych.
Jak przekonwertować plik HTML na PDF online bez utraty formatowania
Dowiedz się, jak bezpłatnie przekonwertować pliki HTML i style CSS na gotowe do druku dokumenty PDF online. Zachowaj czcionki, podziały stron i układ bez znaków wodnych.
Jak przekonwertować PDF na EPUB online za darmo (płynny tekst na czytniki)
Dowiedz się, jak przekonwertować dokumenty PDF na elastyczne e-booki EPUB online za darmo. Czytaj wygodnie na Kindle, Kobo i telefonie bez uciążliwego przybliżania.