PDF를 XML로 온라인에서 무료 변환하는 방법 (좌표가 포함된 구조화 데이터)
핵심 요약 & 직접 답변
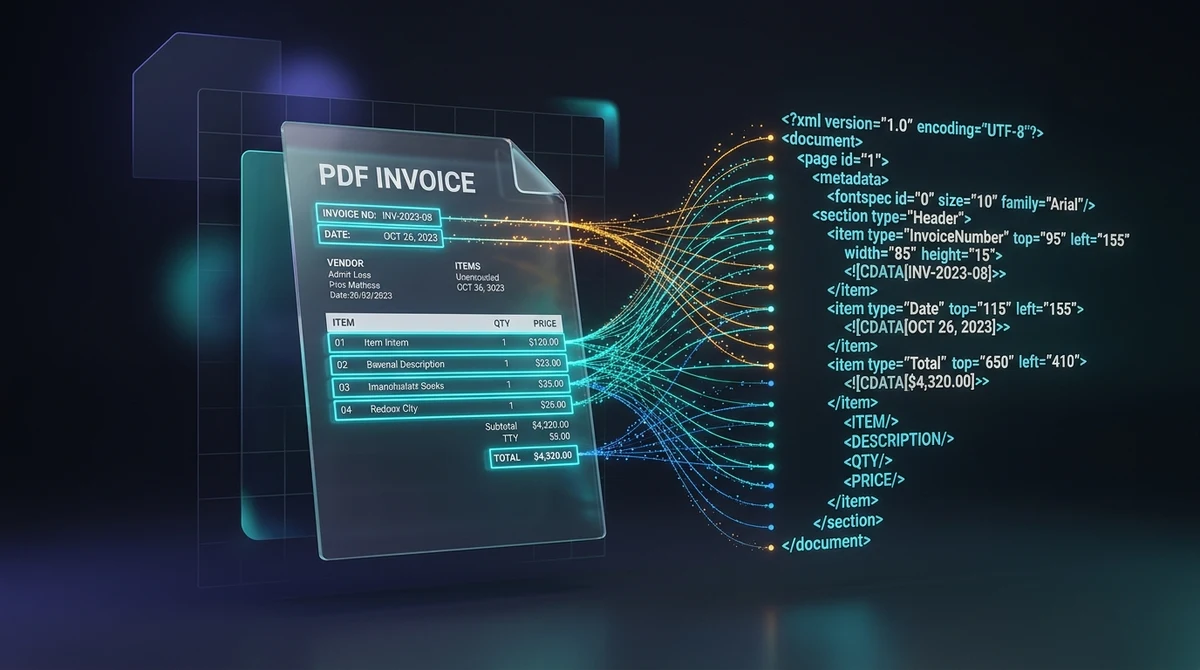
PDF 문서를 온라인에서 무료로 안전하게 XML로 변환하는 것은 시각적 레이아웃을 절대 공간 좌표(top, left, width, height)와 폰트 사양이 포함된 계층형 Extensible Markup Language 태그로 전환하는 프로세스입니다. AZ2PDF 변환기를 사용하면 데이터 엔지니어와 개발자가 소프트웨어 설치 없이 휘발성 RAM 메모리에서 몇 초 만에 기계 판독 가능한 텍스트 데이터를 추출할 수 있습니다.
- 공간 좌표의 완벽한 보존: 모든 텍스트 요소에 정확한 바운딩 박스 속성(top, left, width, height)과 폰트 사양이 부여되어 좌표 기반 데이터 추출이 가능합니다.
- 기계 판독 가능한 계층형 데이터: 고정된 시각적 페이지를 구조화된 XML 노드(page, fontspec, text)로 변환하여 Python, Node.js, ERP 시스템 자동 수집에 즉시 연동됩니다.
- 청구서 처리 및 ETL 파이프라인 필수 도구: 다중 열 재무제표, B2B 송장, 세무 서식의 공간적 위치 관계를 왜곡 없이 파싱하는 데 이상적입니다.
- 100% 무료 및 RAM 기반 즉시 처리: AZ2PDF는 서버의 휘발성 RAM에서만 파일을 처리하며, 비용 없이 로그인 없이 워터마크 없이 5분 후 자동 영구 삭제됩니다.
데이터 추출의 딜레마: PDF가 비즈니스 데이터를 가두는 이유
현대 기업 IT 환경에서 Portable Document Format(PDF)은 표준적인 시각 출력물이지만, 데이터 자동화 측면에서는 큰 걸림돌이 되기도 합니다. ISO 32000 국제 표준을 따르는 PDF는 인쇄된 종이 문서를 디지털상에 완벽히 재현하는 데 중점을 둡니다. PC, 모바일 기기, 고해상도 프린터 등 어떤 환경에서도 글자와 여백이 동일하게 고정되어 표시됩니다.
그러나 인간의 눈에 완벽한 이 시각적 고정성은 컴퓨터 프로그램에 의한 자동 분석을 어렵게 만듭니다. PDF 파일은 데이터베이스 테이블이나 스프레드시트처럼 의미론적인 데이터 트리를 저장하지 않습니다. 파일 자체는 행, 열, 소계, 인보이스 번호와 같은 개념을 전혀 인식하지 못하며, 단지 X=150, Y=720 좌표에 특정 문자열을 그린다는 시각적 그리기 명령만을 보관합니다.
개발자나 데이터 엔지니어가 일반적인 텍스트 덤프 도구를 사용하여 텍스트를 추출하려 할 때 다음과 같은 문제가 발생합니다:
- 여러 열로 나뉜 표 데이터가 단일 텍스트 줄로 합쳐지며 읽기 순서가 뒤섞입니다.
- 머리글, 바닥글, 페이지 번호가 데이터 행 사이에 무작위로 섞여 들어갑니다.
- '세액' 라벨 바로 아래에 금액이 위치한다는 2차원 공간적 관계가 완전히 사라집니다.
PDF 문서를 구조화된 Extensible Markup Language(XML)로 변환하면 텍스트 내용뿐만 아니라 페이지상의 기하학적 좌표 정보를 계층적 구조로 추출할 수 있어 이 문제를 근본적으로 해결할 수 있습니다.
PDF to XML 변환이란 무엇이며 출력 데이터는 어떻게 구성되는가?
PDF to XML 변환은 문서의 시각적 배치를 분석하여 공인 DTD 사양(예: Poppler pdf2xml 표준)에 부합하는 체계적인 XML 객체 모델로 재구성하는 과정입니다. 단순한 텍스트 덤프와 달리 페이지별로 요소를 그룹화하고, 글꼴 속성을 매핑하며, 각 텍스트 조각에 정확한 2차원 바운딩 박스 좌표를 부여합니다.
실제 생성되는 XML 구문의 예시는 다음과 같습니다:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
이처럼 정돈된 구조 덕분에 자동화 스크립트가 데이터의 위치를 어림짐작할 필요가 없습니다. top, left, width, height 속성을 파싱함으로써 어떤 응용 프로그램이든 실제 종이상의 공간 좌표를 기반으로 원하는 항목을 찾아낼 수 있습니다.
공간 좌표 체계: top, left, width, height 및 fontspec의 이해
XML 추출의 핵심적인 장점은 풍부한 기하학적 메타데이터에 있습니다. 이러한 속성의 원리를 이해하면 신뢰성 높은 데이터 파이프라인을 구축할 수 있습니다:
- 페이지 캔버스 정의(<page>): 루트
<page>요소는 물리적 용지 크기(예: 표준 포인트 단위width="918" height="1188")를 명시하여 모든 하위 요소의 기준 좌표계를 형성합니다. - 폰트 사양 선언(<fontspec>): 문서에 사용된 모든 글꼴을 인덱싱하고 고유 ID(
font="0",font="1")를 부여합니다. 글꼴 패밀리, 포인트 크기, 16진수 색상 코드가 포함되므로 폰트 크기를 기준으로 본문과 각주를 자동 분류할 수 있습니다. - top 및 left 좌표:
top속성은 페이지 상단 가장자리부터 텍스트 기준선까지의 수직 거리를 나타내며,left속성은 페이지 왼쪽 여백으로부터의 수평 거리를 나타냅니다. - width 및 height 속성: 텍스트 상자의 폭과 높이를 지정하여 표의 열 너비 계산 및 동일 수평선상의 정렬 여부를 손쉽게 판단할 수 있습니다.
- 인라인 스타일 태그: 굵은 글씨(
<b>)와 기울임꼴(<i>) 스타일이 텍스트 노드 내에 그대로 유지되어 주요 라벨 항목을 식별하는 데 유용합니다.
문서를 기계 판독 가능한 구조화 데이터셋으로 변환하려면 AZ2PDF PDF to XML 변환기를 활용해 보세요. 텍스트 좌표와 계층 구조를 표준 XML 태그로 정밀하게 재구성합니다.
온라인에서 PDF를 XML로 변환하는 간단한 3단계
별도의 소프트웨어 설치 없이 웹 브라우저에서 1분 이내에 간편하게 변환을 마칠 수 있습니다:
1단계: PDF 문서 업로드
변환할 송장, 재무 보고서, 기술 명세서 PDF 파일을 업로드 영역으로 드래그 앤 드롭하거나 내 기기에서 직접 선택합니다.
2단계: 고성능 엔진의 공간 데이터 자동 분석
서버의 휘발성 RAM 메모리에서 PDF 객체 스트림이 즉시 분석됩니다. 텍스트 블록의 위치를 맵핑하고, 외곽 경계 좌표를 계산하며, 폰트 사전을 추출하여 유효한 XML 트리를 생성합니다.
3단계: 구조화된 XML 파일 다운로드
다운로드 버튼을 클릭하여 완성된 .xml 파일을 저장합니다. VS Code 등의 편집기에서 바로 열람하거나 회원가입 없이 백엔드 시스템에 즉시 연동할 수 있습니다. 만약 단순한 수치 표 데이터를 다루고자 한다면 온라인에서 PDF를 CSV로 무료 변환하는 방법을 통해 엑셀용 데이터로 손쉽게 가공할 수도 있습니다.
핵심 활용 사례: 송장 자동화, ETL 파이프라인, Document AI 학습
PDF to XML 변환은 다양한 엔터프라이즈 자동화 분야에서 핵심 기반으로 활용됩니다:
- 회계 부서의 공급업체 송장 자동 처리: 매달 수많은 공급업체로부터 서식이 서로 다른 대량의 인보이스를 수령합니다. 기존 정규표현식은 양식이 바뀌면 오작동하기 쉽지만, XML을 활용하면 특정 좌표 영역(예: 송장 번호와 만기일이 위치하는 우측 상단)을 타겟팅하여 안정적으로 파싱할 수 있습니다.
- 엔터프라이즈 ETL(추출, 변환, 적재) 파이프라인: 데이터 웨어하우스에 분기별 실적 보고서와 보험 청구서를 주기적으로 수집할 때, XML은 플랫폼에 구애받지 않고 Apache Spark, Python Airflow 및 관계형 데이터베이스와 유연하게 통합됩니다.
- Document AI 및 LayoutLM 모델 학습 데이터 구축: 최신 문서 분석 딥러닝 모델은 텍스트 토큰과 함께 2차원 바운딩 박스를 입력값으로 요구합니다. XML 변환은 모델 학습에 최적화된 공간 데이터를 제공합니다.
- B2B 전자문서교환(EDI) 시스템: SAP, Oracle 등 전사적 자원관리(ERP) 시스템에서 발주 처리를 자동화하려면 구조화된 데이터가 필수적입니다. PDF 구매 주문서를 XML로 변환하면 시각적 문서와 ERP 간의 자동화 격차를 해소할 수 있습니다.
실전 파싱 가이드: Python, lxml, XPath를 활용한 XML 데이터 추출
XML 파일을 다운로드한 후 Python 스크립트를 작성하여 특정 데이터 필드를 추출하는 과정은 매우 간단합니다. lxml 라이브러리와 XPath 표현식을 사용하면 지정된 좌표 범위 내의 텍스트 노드를 정확하게 필터링할 수 있습니다:
from lxml import etree

# 생성된 XML 파일 로드 및 파싱
tree = etree.parse("invoice.xml")
root = tree.getroot()

# 특정 2차원 좌표 범위 내에 위치한 텍스트 노드 추출
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
print(f"{coordinates}: {text_node.text}")@top, @left, @font 속성을 조합하면 문서 디자인이 미세하게 변경되더라도 안정적으로 작동하는 룰 기반 추출 파이프라인을 구축할 수 있습니다.
문제 해결: 스캔 문서, OCR 처리, RAM 기반 보안 원칙
문서 처리 파이프라인의 안정성을 보장하기 위해 다음 기술 지침을 참고하십시오:
1. 디지털 텍스트가 없는 스캔 종이 문서
광학 스캐너나 팩스를 통해 생성된 PDF는 글자 데이터가 없는 단순 비트맵 이미지 파일일 수 있습니다. 변환 엔진은 원본 벡터 텍스트를 추출하므로 순수 이미지 PDF를 변환하면 빈 XML이 반환됩니다. 이를 해결하려면 먼저 OCR로 PDF에서 텍스트 추출하는 가이드를 참고하여 보이지 않는 투명 텍스트 레이어를 생성한 후 XML 변환을 진행해야 합니다.
2. 수백 페이지 분량의 대용량 문서 용량 관리
페이지 수가 많은 문서의 경우 모든 텍스트의 좌표 메타데이터가 포함되어 XML 크기가 커질 수 있습니다. 스토리지 보관 및 네트워크 전송 시 Gzip 등의 압축 기술을 적용하는 것이 유리합니다.
3. 휘발성 RAM 메모리 처리와 철저한 정보 보호
재무 서류, 계약서, 임직원 세무 서식은 기업의 주요 기밀 사항을 담고 있습니다. 본 플랫폼은 다음과 같은 엄격한 보안 프로토콜을 준수합니다:
- 휘발성 RAM 내 일시적 처리: 파일 분석 및 XML 트리 생성 등 모든 연산은 서버의 임시 RAM 메모리에서만 이루어지며 하드디스크에 영구 저장되지 않습니다.
- 5분 후 자동 완전 파기: 백그라운드 프로세스가 상시 가동되어 변환 완료 후 5분 이내에 모든 임시 버퍼 데이터를 영구 삭제합니다.
- 회원가입 없는 완전 무료 서비스: 이메일 주소나 카드 정보를 요구하지 않으므로 사용자의 익명성이 완벽히 보장됩니다.
- 홍보용 워터마크 없음: 공식 DTD 표준을 준수하는 깨끗한 원본 형태의 XML 결과물을 제공합니다.
브라우저에서 바로 활용 가능한 다양한 도구들을 AZ2PDF 엔지니어링 PDF 도구 모음에서 직접 경험해 보세요.
❓ 자주 묻는 질문 (FAQ)
일반 텍스트 변환은 모든 공간 좌표를 버리기 때문에 여러 열로 구성된 표와 머리글이 한 줄로 뒤섞입니다. CSV는 규칙적인 바둑판식 격자 구조를 전제합니다. 반면 XML은 바운딩 박스 속성(top, left, width, height)을 통해 페이지상 단어의 물리적 위치를 보존하므로, 표 디자인에 구애받지 않고 특정 좌표 구역을 지정하여 데이터를 정밀하게 추출할 수 있습니다.
이 주제의 관련 글
전문적인 PDF 페이지 정리 및 문서 관리 노하우를 확인해보세요.
온라인에서 PDF를 CSV로 무료 변환하는 방법 (깔끔한 표 데이터 추출)
PDF 표 데이터를 깔끔하고 구조화된 CSV 파일로 무료 변환하세요. 은행 거래 내역서와 인보이스를 열 깨짐이나 워터마크 없이 추출합니다.
온라인에서 PDF를 텍스트로 무료 변환하는 방법 (깔끔한 TXT 추출)
PDF 문서에서 서식 없는 순수 텍스트를 무료로 추출하는 방법을 알아보세요. 다단 편집 페이지도 깨짐 없이 깨끗한 UTF-8 TXT 파일로 변환합니다.

스캔한 PDF에서 OCR로 텍스트 추출하는 방법 (무료 및 보안)
스캔한 종이 문서와 사진 PDF를 무료 다국어 OCR을 통해 검색 및 복사 가능한 텍스트로 변환하세요. 브라우저에서 빠르고 정확하며 100% 안전하게 처리됩니다.
PDF를 HTML로 온라인에서 무료 변환하는 방법 (깔끔한 코드 및 레이아웃 유지)
PDF 문서를 반응형 HTML5 및 CSS 웹페이지로 온라인에서 무료 변환하세요. 폰트, 서식 및 그래픽을 워터마크 없이 원본 그대로 보존합니다.
서식 손실 없이 온라인에서 HTML 파일을 PDF로 변환하는 방법
HTML 파일과 CSS 스타일을 인쇄 가능한 PDF 문서로 온라인에서 무료 변환하세요. 워터마크 없이 정확한 글꼴, 페이지 분할 및 레이아웃을 그대로 유지합니다.
PDF를 EPUB으로 온라인에서 무료 변환하는 방법 (전자책 리더용 리플로우 텍스트)
고정 레이아웃의 PDF 문서를 리플로우 지원 EPUB 전자책으로 온라인에서 무료 변환하세요. 킨들, 코보, 스마트폰에서 화면 확대 없이 편안하게 독서할 수 있습니다.