PDF'i XML'e Çevirme Online Ücretsiz (Koordinatlı Yapılandırılmış Veri)
Doğrudan Yanıt & Temel Çıkarımlar
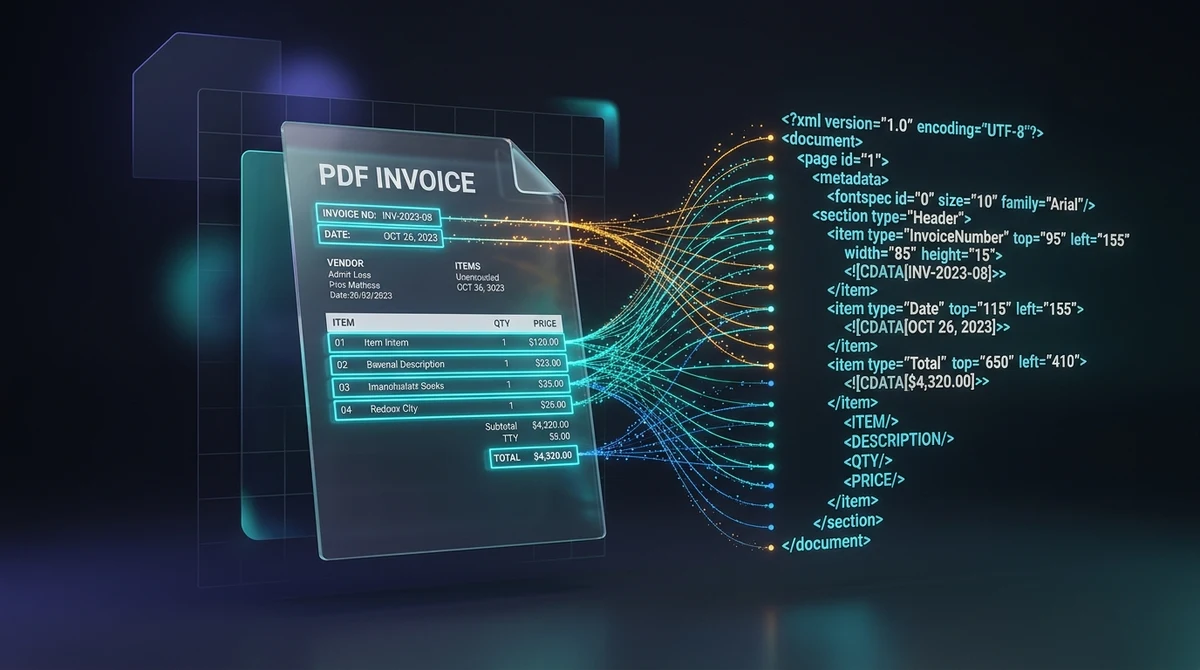
Bir PDF'i çevrim içi ücretsiz olarak XML'e dönüştürmek, görsel belge düzenlerini mutlak mekansal koordinatlar (top, left, width, height) ve yazı tipi parametreleri içeren hiyerarşik Extensible Markup Language etiketlerine dönüştürmek anlamına gelir. AZ2PDF dönüştürücüsü ile veri mühendisleri ve geliştiriciler, makine tarafından okunabilir yapılandırılmış metin düğümlerini saniyeler içinde, tamamen ücretsiz ve geçici RAM belleğinde güvenle ayıklayabilir.
- Mekansal koordinatları koruma: Her metin öğesi kesin sınırlayıcı kutu öznitelikleri (top, left, width, height) ve yazı tipi bilgileriyle etiketlenerek koordinat tabanlı hassas veri çıkarımı sağlar.
- Makine tarafından okunabilir hiyerarşik veri: Statik sayfaları Python, Node.js ve ERP sistemlerinde otomatik işlemeye hazır yapılandırılmış XML düğümlerine (page, fontspec, text) dönüştürür.
- Faturalar ve ETL hatları için vazgeçilmez: Çok sütunlu mali tabloları, B2B faturalarını ve vergi formlarını mekansal ilişkilerini kaybetmeden ayrıştırmak için mükemmeldir.
- Yüzde 100 ücretsiz ve anında RAM içi işleme: AZ2PDF dosyalarınızı doğrudan sunucunun geçici RAM belleğinde işler; ücret talep etmez, kayıt gerektirmez, filigran eklemez ve 5 dakika içinde otomatik siler.
Veri çıkarma sorunu: PDF formatı kurumsal verileri neden kilitler?
Modern kurumsal bilişim dünyasında Portable Document Format (PDF) vazgeçilmez bir sunum standardı olmasının yanı sıra otomatik veri işleme süreçlerinin önündeki en büyük engellerden biridir. ISO 32000 kapsamında standartlaştırılan PDF, görsel sadakate odaklanır: sözcükleri, vektör çizimlerini ve kenar boşluklarını basılı bir sayfanın kusursuz dijital kopyası olarak kilitler. İster bilgisayarda, ister telefonda görüntülensin, belgenin görünümü daima aynı kalır.
Ancak PDF'i insan gözü için mükemmel kılan bu görsel sabitleme, bilgisayar yazılımları için süreci fazlasıyla karmaşıklaştırır. Bir PDF dosyası veritabanı tablosu veya elektronik tablo gibi anlamsal bir veri ağacı barındırmaz. Satır, sütun, ara toplam veya fatura numarası gibi kavramları doğası gereği tanımaz. Yalnızca grafik çizim komutlarını saklar: X=150, Y=720 koordinatına bu karakter dizisini çiz gibi doğrudan talimatlar içerir.
Geliştiriciler veya veri analistleri standart metin çıkarma araçlarıyla bilgi almaya çalıştıklarında bildik sorunlar baş gösterir:
- Çok sütunlu tablolar birbirine karışarak tek bir düzensiz metin akışına çöker.
- Üstbilgiler, altbilgiler ve sayfa numaraları verilerin arasına rastgele serpişir.
- Mekansal ilişkiler (örneğin bir tutarın doğrudan bir vergi kaleminin altında durması) bütünüyle yok olur.
PDF belgenizi yapılandırılmış Extensible Markup Language (XML) formatına dönüştürmek, hem metin içeriğini hem de sayfa üzerindeki kesin geometrik koordinatları makine tarafından okunabilir bir hiyerarşide yakalayarak bu sorunu çözer.
PDF'i XML'e dönüştürme nedir ve çıktı yapısı nasıldır?
PDF'i XML'e dönüştürme işlemi, belgenin görsel düzenini analiz ederek resmi DTD standartlarına (Poppler pdf2xml spesifikasyonu gibi) uygun, düzenli bir XML nesne modeline aktarır. Düzensiz metin dökmek yerine motor, öğeleri sayfalarına göre gruplandırır, yazı tipi özelliklerini haritalar ve her metin parçacığına sınırlayıcı kutusunun koordinatlarını ekler.
Elde edilen XML yapısının gerçek bir örneği aşağıda sunulmuştur:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE pdf2xml SYSTEM "pdf2xml.dtd">
<pdf2xml producer="poppler" version="24.08.0">
  <page number="1" position="absolute" top="0" left="0" height="1188" width="918">
    <fontspec id="0" size="14" family="Helvetica" color="#000000"/>
    <fontspec id="1" size="10" family="Helvetica" color="#333333"/>
    <text top="95" left="155" width="220" height="16" font="0"><b>INVOICE #INV-2026-0924</b></text>
    <text top="120" left="155" width="85" height="12" font="1">Date: 2026-09-24</text>
    <text top="650" left="410" width="95" height="14" font="0"><b>Total: $4,320.00</b></text>
  </page>
</pdf2xml>
Bu düzenli yapı sayesinde otomatik betikleriniz bilgilerin nereden geldiğini tahmin etmek zorunda kalmaz. top, left, width ve height özniteliklerini ayrıştırarak herhangi bir yazılım, sayfadaki kesin konumuna göre verileri hızla bulabilir.
Mekansal koordinatlar: top, left, width, height ve fontspec özniteliklerini anlama
XML veri çıkarımının asıl gücü, sunduğu zengin geometrik meta verilerde yatar. Bu özniteliklerin işleyişini kavramak, dayanıklı veri işleme hatları kurmanızı sağlar:
- Sayfa sınırları (<page>): Kök
<page>öğesi fiziksel çalışma alanının boyutlarını (örneğin standart nokta cinsindenwidth="918" height="1188") tanımlayarak tüm alt öğeler için koordinat ızgarasını kurar. - Yazı tipi tanımları (<fontspec>): Ayrıştırıcı belgedeki tüm yazı tiplerini indeksler ve benzersiz kimlikler (
font="0",font="1") atar. Her<fontspec>etiketi yazı tipi ailesini, boyutunu ve onaltılık renk kodunu belirterek betiklerin başlıkları dipnotlardan yazı tipi boyutuna göre ayırt etmesini sağlar. - top ve left koordinatları:
topözniteliği sayfanın üst kenarından metin taban çizgisine olan dikey mesafeyi gösterir.leftözniteliği ise sol kenar boşluğundan olan yatay uzaklığı belirtir. - width ve height boyutları: Metin kutusunun genişliğini ve yüksekliğini belirleyerek sütun genişliklerinin hesaplanmasını ve yatay hizalamaların doğrulanmasını kolaylaştırır.
- Satır içi stil etiketleri: Kalın (
<b>) ve italik (<i>) stiller metin düğümleri içinde doğrudan korunur, böylece kilit etiketlerin tanınması kolaylaşır.
Belgelerinizi AZ2PDF PDF'den XML'e dönüştürücü ile yapılandırılmış veri kümelerine dönüştürün; sınır koordinatlarını ve hiyerarşiyi standart XML etiketlerine aktarın.
Online olarak PDF'i XML'e dönüştürmenin 3 basit adımı
PDF belgelerinizi yapılandırılmış XML koduna dönüştürmek web tarayıcınızda bir dakikadan az sürer:
1. Adım: PDF belgenizi yükleyin
Faturanızı, finansal raporunuzu veya teknik şartnamenizi yükleme alanına sürükleyip bırakın veya cihazınızdan seçin.
2. Adım: Mekansal verilerin otomatik analizi
Yüksek performanslı motorumuz PDF nesne akışını sunucunun geçici RAM belleğinde analiz eder. Metin bloklarını haritalar, sınır koordinatlarını hesaplar, yazı tiplerini kaydeder ve geçerli bir XML ağacı oluşturur.
3. Adım: Yapılandırılmış XML dosyanızı indirin
.xml dosyanızı kaydetmek için İndir butonuna tıklayın. Kod düzenleyicilerde anında açabilir veya hesap açmaya gerek duymadan kurumsal sistemlerinize entegre edebilirsiniz. Yalnızca düz sayısal tablolarla çalışmak istiyorsanız, Excel uyumlu tablolar için online PDF'i CSV'ye dönüştürme rehberimize de göz atabilirsiniz.
Yüksek değerli kullanım senaryoları: Faturalar, ETL hatları ve Document AI eğitimi
PDF'i XML'e dönüştürmek, birçok sektörde büyük ölçekli veri otomasyonunun omurgasını oluşturur:
- Otomatik fatura ve muhasebe işleme: Muhasebe departmanları her ay farklı tasarımlara sahip binlerce tedarikçi faturasını işler. Standart düzenli ifadeler (regex) şablon değişikliklerinde aksar. XML ile yazılımlar sabit koordinat bölgelerini (örneğin fatura numarası ve vadesinin bulunduğu sağ üst köşe) hedefleyebilir.
- ETL (Extract, Transform, Load) boru hatları: Kurumsal veri ambarları üç aylık mali tabloları ve poliçeleri düzenli olarak toplar. XML, Apache Spark, Python Airflow ve ilişkisel veritabanlarıyla sorunsuz entegre olan nötr bir standart sunar.
- Document AI ve LayoutLM modellerini eğitme: Modern derin öğrenme modelleri sayfa yapısını kavramak için hem metin parçalarına hem de 2 boyutlu sınırlayıcı kutulara ihtiyaç duyar. XML çıktısı ideal mekansal eğitim verisini sağlar.
- B2B Elektronik Veri Değişimi (EDI): ERP sistemleri (SAP, Oracle) siparişleri otomatikleştirmek için yapılandırılmış verilere ihtiyaç duyar. PDF sipariş formlarını XML'e dönüştürmek, görsel belgeler ile ERP işleme mekanizmaları arasındaki köprüyü kurar.
Pratik ayrıştırma: Elde edilen XML üzerinde Python, lxml ve XPath kullanımı
XML dosyasını indirdikten sonra Python ile bir veri çıkarma betiği yazmak son derece pratiktir. lxml kütüphanesi ve XPath sorguları ile metin düğümlerini koordinatlarına göre filtreleyebilirsiniz:
from lxml import etree

# Oluşturulan XML dosyasını yükleyin ve ayrıştırın
tree = etree.parse("fatura.xml")
root = tree.getroot()

# Belirli bir koordinat aralığındaki metin düğümlerini çekin
for text_node in root.xpath("//text[@top > 90 and @top < 130 and @left > 150]"):
    coordinates = f"(top={text_node.get('top')}, left={text_node.get('left')})"
print(f"{coordinates}: {text_node.text}")@top, @left ve @font özelliklerini birlikte kullanarak, sayfa düzenindeki hafif kaymalara karşı dirençli ayıklama kuralları oluşturabilirsiniz.
Sorun giderme: Taranmış belgeler, OCR ve RAM bellek güvenliği
Veri işleme süreçlerinizin sorunsuz ilerlemesi için şu teknik noktalara dikkat edin:
1. Dijital metin içermeyen taranmış belgeler
PDF dosyanız optik karakter tanıma yapılmamış bir tarayıcıdan geliyorsa sadece piksel resimlerinden ibarettir. Dönüştürücü yerel vektör metinlerini ayıkladığından, salt görsel içeren bir PDF boş bir XML üretecektir. XML dönüştürmesinden önce dijital metin katmanı oluşturmak için OCR ile PDF'den metin çıkarma rehberimizden yararlanın.
2. Yüzlerce sayfalık büyük arşivlerin yönetimi
Çok sayfalı belgelerde her karakter bloğunun ayrıntılı koordinatları XML boyutunu artırabilir. Depolama ve ağ transferlerinde Gzip sıkıştırma yöntemlerini tercih edebilirsiniz.
3. Tam gizlilik ve geçici RAM belleğinde işleme
Faturalar, sözleşmeler ve finansal tablolar ticari sırlar içerir. Platformumuz en yüksek güvenlik standartlarını uygular:
- Yalnızca RAM bellekte işleme: Ayrıştırma ve XML ağacının inşası tamamen sunucunun geçici RAM belleğinde gerçekleşir, sabit disklere kaydedilmez.
- 5 dakika içinde otomatik imha: Bir arka plan işlemi, dönüştürme tamamlandıktan sonra en geç 5 dakika içinde tüm geçici bellek verilerini geri döndürülemez biçimde siler.
- Hesap açmadan tamamen ücretsiz: E-posta adresi veya ödeme bilgisi talep edilmez, anonimliğiniz korunur.
- Reklam filigranı eklenmez: Elde ettiğiniz XML çıktısı temiz ve resmi DTD standartlarıyla tam uyumludur.
Gelişmiş diğer araçları doğrudan web tarayıcınızda denemek için AZ2PDF teknik PDF araç takımı sayfamızı ziyaret edin.
❓ Sıkça Sorulan Sorular (SSS)
Düz metin çıkarma tüm konumsal verileri silerek sütunları ve başlıkları birbirine katar. CSV ise katı tablo ızgaraları gerektirir. XML, sınırlayıcı kutu öznitelikleri (top, left, width, height) ile her sözcüğün sayfadaki tam konumunu korur; böylece yazılımlar tablo tasarımından bağımsız olarak koordinat bölgelerine göre veri çıkarabilir.
Bu Konudaki İlgili Makaleler
Profesyonel sayfa yönetimi ve belge organizasyonu hakkında daha fazla bilgi edinin.
Online PDF CSV dönüştürme ücretsiz (temiz tablo çıkarma rehberi)
PDF tablolarını online olarak ücretsiz, temiz CSV dosyalarına dönüştürmeyi öğrenin. Banka ekstrelerini ve faturaları sütun kayması olmadan çıkarın.
Online PDF'i metne ücretsiz dönüştürme (temiz TXT çıkarma)
PDF belgelerinden biçimlendirilmemiş düz metni çevrimiçi ve ücretsiz olarak nasıl çıkaracağınızı öğrenin. Çok sütunlu sayfaları temiz UTF-8 TXT dosyalarına dönüştürün.

Taranmış PDF'ten OCR ile Metin Çıkarma (Ücretsiz ve Güvenli)
Taranmış kağıt belgeleri ve fotoğraf PDF'lerini ücretsiz çok dilli OCR ile aranabilir ve seçilebilir metne nasıl dönüştüreceğinizi öğrenin. Tarayıcınızda hızlı, hassas ve %100 gizli.
PDF'i HTML'ye online ücretsiz dönüştürme (temiz kod ve tam düzen koruma)
PDF belgelerini online ve ücretsiz olarak duyarlı HTML5 ve CSS web sayfalarına nasıl dönüştüreceğinizi öğrenin. Yazı tiplerini, biçimlendirmeyi ve vektör grafikleri filigransız koruyun.
HTML Dosyalarını Biçimlendirmeyi Kaybetmeden Çevrimiçi PDF'ye Dönüştürme
HTML dosyalarını ve CSS stillerini çevrimiçi olarak ücretsiz ve baskıya hazır PDF belgelerine dönüştürün. Yazı tiplerini, sayfa sonlarını ve düzeni filigransız koruyun.
PDF'i EPUB'a Çevrimiçi Ücretsiz Dönüştürme (E-Okuyucular İçin Akışkan Metin)
Sabit düzenli PDF belgelerini akışkan EPUB e-kitaplarına çevrimiçi ücretsiz dönüştürün. Kindle, Kobo ve mobilde yakınlaştırma zahmeti olmadan rahatça okuyun.